Obsidian+Claudian:为AI搭建个人知识库的实战指南

用Obsidian加Claudian插件,让AI先查你的笔记再回答,附配置流程与实测。
文章基于B站UP主蓝叔的分享,介绍了一套让通用大模型接入个人知识库的实用方案:以Obsidian作为本地Markdown知识库,通过Claudian插件驱动Codex、Claude Code、DeepSeek等Agent,在回答问题前先检索相关笔记。文中用归档流程和版本号管理两个案例说明通用AI与知识库AI的差异,比较了在线服务、本地加云端、本地加本地模型三条路线,并给出从安装、初始化目录到编写agents.md规则的完整步骤。实测显示AI能自动分类零散资料、跨会话检索计算、按局部变更更新记录并保留历史。文章也点明手机端不可用、云端模型存在数据外发风险、回答质量受资料完整度制约等边界。
大模型掌握大量通用知识,却未必知道你的具体工作习惯和项目约定。B站UP主蓝叔分享了一套方案:用Obsidian做本地知识库、Claudian插件接入AI,让AI在回答问题前先查阅你的笔记。本文基于该视频内容整理,拆解配置流程、实际效果与成本考量。
为什么通用AI需要你的知识库
蓝叔在视频中举了两个对比案例。第一个问题是“我的AI工作记录归档流程是什么”——没有知识库时,即使允许联网,AI只能给出通用建议;接入知识库后,AI能准确说出“提炼记录→转交→增量归档→返回值→回读核对”这一具体流程。第二个案例关于一个B站小工具的版本号管理:通用AI只能讲版本管理原则,而读取了项目规范的AI能给出确定规则——修改程序代码必须升补丁号,仅更新数据时保留工具版本、用时间戳区分数据包。
差异的根源在于:用户做过的决定、选择某方法的原因、项目里已经形成的约定,这些信息不在模型的训练数据里。知识库的作用是把这些“值得长期保留的信息”沉淀下来,在提问时通过工具检索相关笔记,再结合资料生成回答。整个过程不涉及重新训练模型,也不需要每次把整个库发给AI。
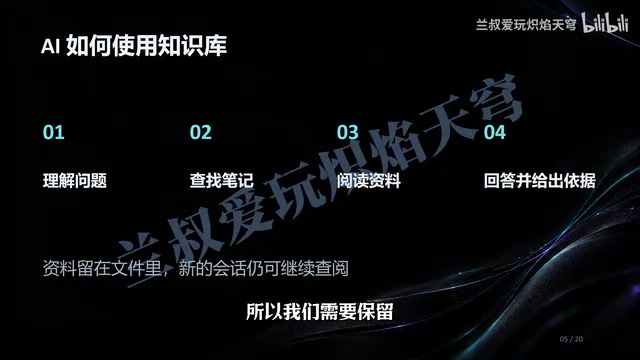
回答质量取决于资料本身和检索结果,所以蓝叔强调要保留来源、日期和待确认项,便于核对。
三条知识库路线与选择逻辑
视频中将方案分为三类:在线服务(上传文件加问答界面)、本地文件加云端AI、本地文件加本地模型。蓝叔选择第二条路线,理由是兼顾成本、能力与资料自主权。
Obsidian的本质是一个文件夹,笔记以Markdown文本保存,用任意文本编辑器都能打开和修改。这意味着即使将来更换模型或工具,主体内容仍可继续使用,迁移成本极低。本地保存也不等于锁在一台电脑上——知识库文件夹可以放在iCloud、Google Drive等同步目录中,由网盘负责多端同步。
需要注意的是,多端同步不等于AI能力在所有设备可用。本次使用的Claudian插件仅支持桌面端Obsidian,手机端可以手动查询知识库,但用不了AI能力。
Agent(智能体) 是这里的关键概念。与单纯调用一次模型接口不同,Agent 是一套能自主规划步骤、调用工具(如读写文件、搜索笔记)、根据结果迭代行动的运行框架。Claudian 不直接与模型对话,而是驱动一个 Agent,由它决定何时去 Obsidian 库中检索、读取哪些笔记、是否需要写入或修改文件。文章中提到的 Codex、Claude Code、DeepSeek广告 Harness、Grok Build 都属于这类可被插件调用的 Agent 运行时,因此配置时需要填写各自的命令行路径。理解这一点有助于明白:AI 能"自己整理资料、修改两个文件并保留历史",靠的是 Agent 的文件读写能力,而不是模型本身具备记忆。
RAG(检索增强生成) 是知识库方案背后的通用范式:先从资料库中检索与问题相关的片段,再把片段连同问题一起交给模型生成回答。文章强调"不涉及重新训练模型,也不需要每次把整个库发给 AI",正是 RAG 的典型特征。它把"记住知识"和"推理回答"拆开,知识放在可编辑的本地文件里,模型只在需要时读取。这也是回答质量取决于资料本身和检索结果的原因——检索不到或资料写得含糊,模型就只能回到通用常识。
成本与隐私:钱花在哪,数据去哪
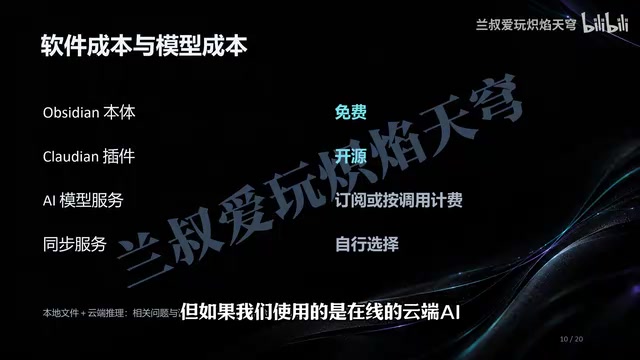
Obsidian本体免费,Claudian开源免费。可能的费用来自两处:模型服务(按订阅或调用量计费)和同步服务(自行选择)。模型接入很灵活,可以是Claude、GPT等国外模型,也可以是DeepSeek等国产模型,甚至本地部署的小模型。
隐私方面有一个关键区分:本地保存资料只代表文件由自己管理。如果接入的是云端AI,提问内容以及工具读取后提供给模型的相关内容,仍可能发送到对应服务商。对隐私要求高的用户,应选择接入本地部署的小模型,让数据和推理全部留在本地。
从零搭建:安装与初始化知识库
蓝叔演示的环境是MacBook Air,Windows和Linux同样支持。流程大致如下:
- 从官网下载对应系统的Obsidian安装包并安装。
- 新建仓库,起名并选择存放位置。若需跨设备同步,放在同步盘目录下即可。出现“文件同步服务冲突”提示可以忽略,因为不使用官方Sync服务。
- 进入设置→第三方插件,关闭受限模式,在社区插件市场搜索Claudian并安装、启用。
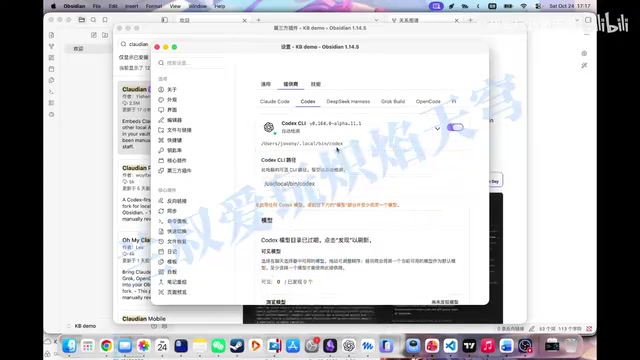
- 在插件选项中切换中文,进入提供商页面,按需启用Codex、Claude Code、DeepSeek Harness、Grok Build等agent,并配置对应的命令行路径。
- 点击“发现模型”,插件会列出当前agent可用的模型,选一个或多个即可。
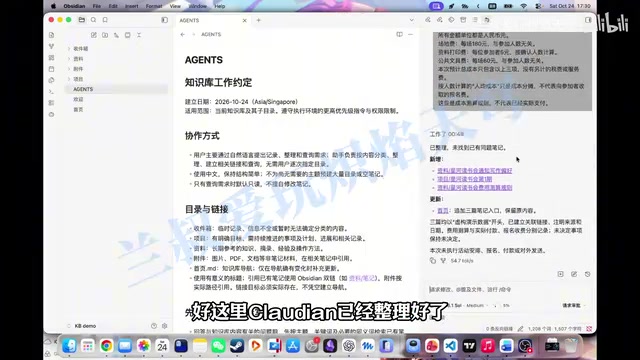
配置完成后,侧边栏会出现Claudian面板。蓝叔建议不要让用户手动建目录,而是直接让AI初始化知识库:创建收件箱、项目、资料、附件等文件夹,生成首页说明各目录用途并提供导航。
随后让AI把整理与查询规则写成文件,例如根目录的agents.md,约定“回答前先查相关笔记、新材料优先合并、信息不足或冲突时加以说明”。新会话建立后需验证规则是否被加载。
Obsidian 的"仓库(Vault)" 并不是数据库或专有格式,它就是一个普通文件夹,Obsidian 只是把这个文件夹当作工作区来索引和展示。笔记以纯 Markdown 文本存储,图片等附件放在同一目录树中。因此"新建仓库"本质上是选一个目录,"换工具"或"迁移"也只是换一个软件打开同一个文件夹。文中提到的"文件同步服务冲突"提示,是因为 Obsidian 官方 Sync 服务检测到目录已被 iCloud 等第三方同步工具接管,二者同时同步可能产生冲突,所以在不使用官方 Sync 时忽略即可。
受限模式(Restricted Mode) 是 Obsidian 的安全开关,默认关闭第三方插件的运行权限,防止未经审核的代码访问本地文件。Claudian 需要读写笔记,因此必须先关闭受限模式才能从社区市场安装并启用。相应地,启用第三方插件也意味着把库的读写权限交给了插件及其调用的 Agent,选择插件和 Agent 时应留意其来源与权限范围。
实测:让AI记笔记、跨会话查询与更新
演示用的是一套虚构的读书会资料,包含写作偏好、活动筹备信息和费用规则,故意写成聊天式的零散段落。交给AI后,它自动完成了分类:写作偏好、第一期项目文件、费用测算规则各归其位,首页也生成了索引。
关键测试在跨会话查询:新建绘画后不粘贴材料、不指定打开哪篇笔记,直接问“读书会什么时候举行、筹备到哪一步、按现有人数预计花多少钱”。AI需要自己找到项目记录和费用规则才能算出结果——12人预计总成本300元、人均25元、预算剩余60元。视频还点出一个细节:资料里明确写了收费方案未定,所以AI不能因为算出人均成本就替用户定收费标准,结果来自记录而非常识猜测。
第二轮测试信息更新:把人数从12人改为16人、开始时间推迟半小时,只说变化部分。AI修改了两个文件并保留变更历史;新会话中查询到16人、下午两点半开始、总成本320元、人均20元。总成本上升而人均下降,因为场地和公共文具是固定费用——AI需要同时理解人数变化和费用规则才能算对。
适用边界与下一步
这套方案的门槛比想象中低:用户不必先学Markdown,也不必设计复杂笔记体系,只需提供信息、表达目标、必要时确认事实,整理和查询交给AI。
局限同样明确:手机端无法使用AI能力;云端模型存在数据外发风险;回答质量受资料完整度和检索效果制约。蓝叔预告下一期将讲如何让其他agent工具共用同一个知识库——做事前读取已有配置与决定,完成后把成果补回去,形成闭环。
相关推荐
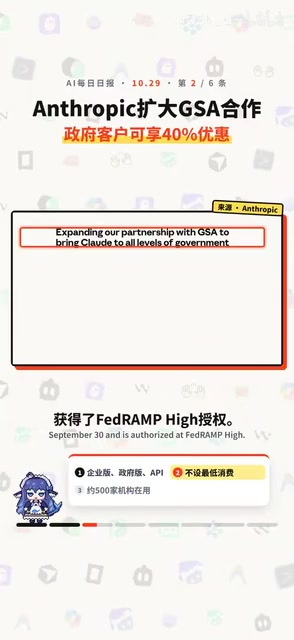
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
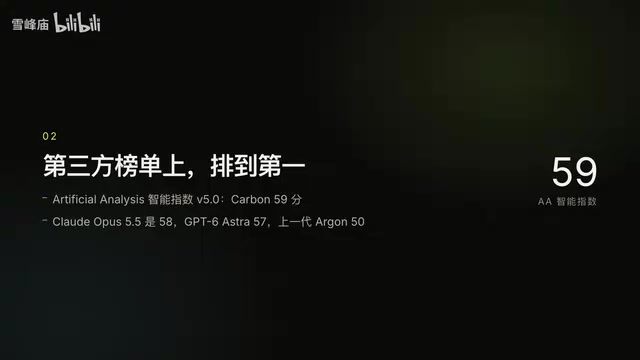
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。