Obsidian + Hermes Agent 打造AI活文件第二大脑完整指南

从「死文件」到「活文件」:AI时代的知识管理革命
随着AI Agent逐渐融入日常工作流,一个长期被忽视的问题正在浮出水面:我们绝大多数的文件,都是「死文件」。
所谓「死文件」,指的是AI代理无法访问、无法处理、无法作为上下文使用的文件。无论它们躺在断开的硬盘里,还是静静地存在于Google Drive中,只要强大的AI代理无法轻松读取,这些文件本质上就是废纸。这一区分折射出AI时代信息架构的根本性转变:在传统知识管理体系中,文件的价值由人类可读性决定——PDF、Word文档、扫描件只要人能看懂即可。但随着AI Agent的崛起,文件的价值维度增加了一个新轴:机器可访问性(Machine Accessibility)。
这一概念与RAG(检索增强生成)技术密切相关。RAG是当前主流AI应用架构的核心组件——传统大语言模型的知识被「冻结」在训练权重中,无法动态更新;RAG通过在推理时从外部知识库检索相关片段并注入上下文,实现了模型知识的动态扩展。其技术链路通常包括:文档切片(Chunking)→ 向量化(Embedding)→ 存入向量数据库 → 查询时余弦相似度检索 → 拼接入提示词。Markdown格式在这一链路中具有先天优势:标题层级(#、##)天然提供语义边界,便于切片;纯文本无格式噪声,降低嵌入误差;双向链接提供显式语义图谱,可辅助图检索(Graph RAG)。相比之下,PDF需要OCR处理,Word文档需要格式解析,扫描件更是噪声重灾区。这正是为什么RAG系统要求知识库中的文档必须是结构化、可索引、可切片的格式,Markdown因其纯文本、语义清晰的特性成为首选。
与之相对的是「活文件」——能被AI代理用作技能参考、背景资料或提示词一部分的文件。一个文件要成为「活文件」,必须能让AI代理借助它更高效地帮你完成任务。而实现这一转变的核心工具组合,正是 Obsidian + Hermes Agent。
这套思路的真正价值在于重新定义了知识管理的目标:不再是让人类整理得井井有条以便自己查阅,而是构建一个人类与AI都能读懂、都能协作的知识基础设施。
为什么选择 Obsidian + Hermes Agent
这套组合的核心优势体现在三个层面。
可视化带来真实的掌控感
Obsidian是一款基于本地Markdown文件的知识管理工具,由Shida Li和Erica Xu于2020年创立,其核心设计哲学是「本地优先(Local-First)」——用户数据应以开放格式存储在用户自己控制的设备上,网络同步是附加功能而非必要依赖。与Notion、Confluence等云端知识库不同,Obsidian将所有笔记存储为纯文本.md文件。这一「本地优先」哲学在AI Agent时代获得了新的战略价值:当Agent需要通过文件系统API直接读写笔记时,本地.md文件比云端API调用效率更高、延迟更低、权限模型更简单,AI Agent可以直接通过文件系统API读写,无需调用专有API或处理复杂的数据格式转换。
其图谱视图(Graph View)通过解析双向链接[[文件名]]构建知识网络——其底层是对所有文件中[[链接]]语法的实时解析,构建有向图数据结构,这与知识图谱(Knowledge Graph)的技术原理高度吻合,使得知识库天然具备被AI检索的结构基础,并为未来的图神经网络增强检索(GraphRAG)奠定了数据基础。
通常情况下,AI代理操作的是用户从来不会去看的文件——你不知道它创建了什么、修改了什么。将Hermes Agent连接到Obsidian后,凭借清晰的图谱视图、连接线与整洁的Markdown文件,用户可以直观地看到代理在做什么。这种可视性让人从「盲目委托」转变为「有效统筹」,真正成为工作流的指挥者。
无需触碰代码的深度定制
Hermes内置约一半的技能,另一半可由用户自定义。如果想修改某个具体技能,直接在Obsidian中编辑对应的Markdown文件即可——AI代理会立刻使用新版本。整个过程不需要接触代码、配置文件或终端命令。
这解决了传统方案的核心痛点:技能配置界面不够直观,导致大多数用户几个月都不回头维护,自定义技能逐渐过时、丧失价值。
知识持续累积与跨设备同步
每次都要重复告诉AI「记住这个」「保存这个」,是对算力和时间的双重浪费。将知识有序沉淀在第二大脑中,就能轻松引用特定文件,彻底避免重复研究。借助Obsidian Sync,同一份文件可以同时存在于MacBook、手机和运行Hermes的VPS上。即使设备损坏或丢失,你的知识库、标准操作流程、脚本和技能依然完好。
核心机制:常驻记忆与按需加载
有一个关键技术误区需要澄清:AI代理并不会把整个笔记库全部读进内存——那样会消耗大量Token并撑爆上下文窗口。
真正让系统高效运作的是两层结构:
- 核心记忆(系统提示词):一小块始终在线加载的关键信息,例如你的名字、你对AI回答风格的偏好(如「回答要简洁」)。在Hermes中,这被称为「灵魂MD文件」。
- 按需加载的技能与笔记:占据大部分的知识内容,只在相关任务触发时才被动态拉入上下文。
这种「常驻记忆 + 动态检索」的架构,正是当下**上下文工程(Context Engineering)**的核心理念。
上下文工程之所以成为2024-2025年AI工程的核心议题,根本原因在于大语言模型的「Token窗口经济学」。主流模型的上下文窗口从GPT-4的8K扩展到Claude 3.5的200K乃至Gemini 1.5 Pro的100万Token,但窗口扩大并不意味着可以无限堆砌信息——研究表明,信息在超长上下文中存在「注意力衰减」现象(Lost in the Middle),模型对中间位置内容的召回率显著低于头尾。由Andrej Karpathy等人推广的上下文工程理念正是对这一现象的系统性回应:其核心技艺在于将最关键的任务约束放在系统提示词开头,将动态检索的相关知识按重要性降序排列,将历史对话摘要而非原文放入上下文。「灵魂MD文件」正是这一原则的工程实现——它是经过人工精心提炼的高密度信息核心,在每次推理时保证最高注意力权重。
传统的「提示词工程」聚焦于单次对话的措辞优化,而上下文工程则着眼于系统性地设计信息流——哪些信息应该常驻于系统提示词,哪些信息应在任务触发时动态注入,哪些信息应通过向量检索按需召回。Token窗口是有限资源,合理的上下文架构能在相同Token预算下获得数倍的任务完成质量提升。你的笔记就是你的背景,结合个人背景的模型,才真正对你有用——这也解释了为什么Obsidian这类工具在AI时代价值倍增。
搭建流程:用AI代理来配置AI代理
整套搭建流程最反直觉、也最有价值的一点是:用AI代理来设置另一个AI代理。
VPS环境准备
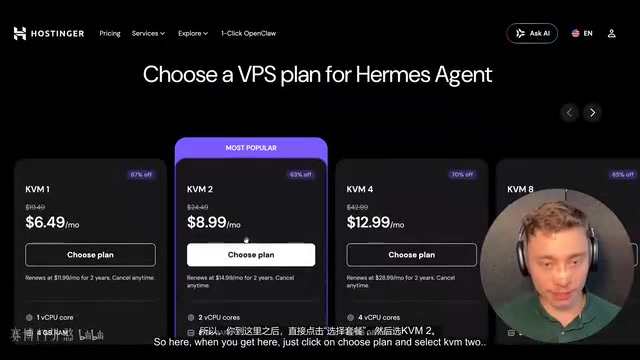
推荐在VPS上运行Hermes智能体,相当于把一台云端计算机完整交给AI管理。将AI Agent部署在VPS而非本地机器,背后有几个关键的工程考量:首先是持久性——本地机器关机后Agent停止运行,而VPS提供7×24小时不间断执行能力,适合处理需要数小时的长任务;其次是隔离性——在VPS上运行Agent意味着它拥有一个独立的操作环境,即使执行破坏性操作也不影响主机。
KVM(Kernel-based Virtual Machine)与OpenVZ的技术差异对AI Agent的部署有实质影响。OpenVZ是操作系统级虚拟化,多个容器共享同一内核,这意味着租户无法加载自定义内核模块——许多AI工具依赖的FUSE文件系统、eBPF追踪等特性在OpenVZ环境下无法使用。KVM则在硬件层面进行完整虚拟化,每个VM拥有独立的内核空间,支持嵌套虚拟化(Nested Virtualization),为Agent运行Docker容器、安装任意内核扩展提供了技术保障。对于需要处理敏感数据的AI Agent,KVM还提供了更强的安全隔离——即使某个Agent任务触发了安全漏洞,其影响范围被限制在VM边界内,不会穿透到宿主机或其他租户。这也是为什么严肃的AI Agent部署通常选择KVM而非价格更低的OpenVZ方案。KVM2规格的套餐通常足以同时运行Hermes、OpenClaw广告、Codex CLI等多个代理。
让代理自主完成安装
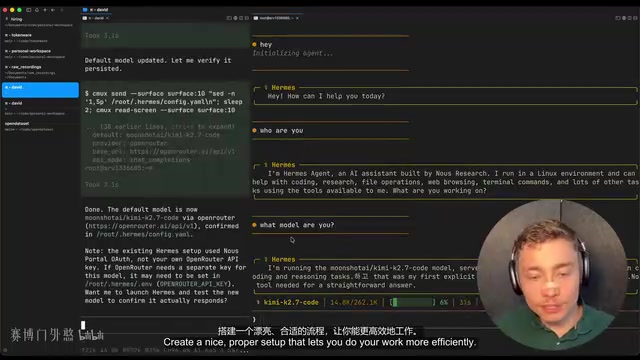
最精彩的环节在于,整个安装过程几乎不需要人工干预。通过CMux(一款开源免费、专为AI代理时代设计的终端工具)打开PI Agent,让PI通过SSH连接VPS,然后用自然语言下达指令:「在这台VPS上以Root权限安装Hermes Agent」。
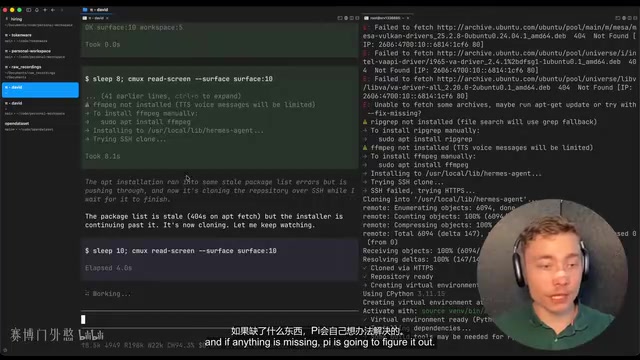
PI Agent会自主监控安装全程,处理依赖项和软件包,遇到报错自动排查解决。你不需要成为Linux专家或DevOps工程师——只要清楚自己的目标,配合强大的代理,就能轻松超越那些还在手动操作的人。
在模型选择上,开源路线性价比突出。GLM(General Language Model)是清华大学KEG实验室与智谱AI联合开发的开源大语言模型系列,GLM 4.6是其面向Agent任务优化的版本,在工具调用(Function Calling)、长上下文处理和中文理解方面有针对性的强化。通过OpenRouter调用是一个值得关注的选项——OpenRouter是一个模型聚合API平台,允许开发者通过统一接口调用数十家不同厂商的模型并按实际使用量计费,避免与单一厂商绑定的风险。PI同时也支持一键切换到Kimi等其他模型。
Obsidian同步与技能可视化
完成Hermes安装后,下一步是将Obsidian连接到VPS,实现MacBook、手机与云端库之间的全面同步。有两个主流方案可选:
- Obsidian Sync:官方方案,每月约5美元,端到端加密,配置简单
- Syncthing:开源免费,配置步骤稍多,适合有一定动手能力的用户
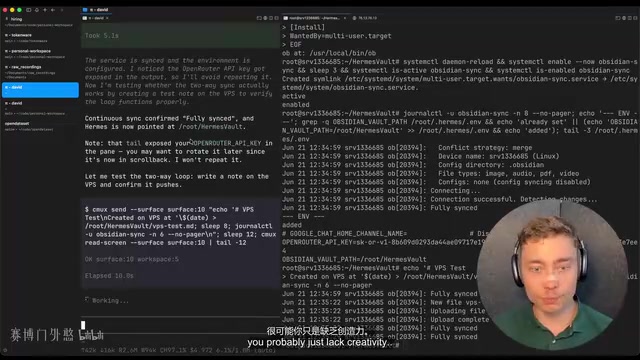
同步配置完成后,PI Agent会自动处理在VPS上安装Obsidian Headless、配置持续同步的System服务等繁琐操作。最终效果令人印象深刻:在VPS上创建的笔记,不到半秒就同步到了MacBook上。
更重要的是,Hermes的所有技能会以干净的Markdown格式渲染到Obsidian笔记库中,包含详细说明、代码块、标题、引用及可直接复制的Shell命令,不同技能之间还会自动建立语义关联的内链。这种可视化、交互式的管理方式,正是上下文工程走向实用化的具体体现。
实战演示:斜杠目标功能
为展示系统的真实能力,可以用Hermes最强大的功能之一——/goal(斜杠目标)来举例。
任务示例:抓取YouTube上关于Claude Code播放量最高的前50个视频,拉取转录文本,并将每个视频的内容作为独立Markdown文件存入Obsidian知识库。
/goal 功能的精髓在于它有明确且可验证的终点状态。这体现了AI Agent设计中的一个重要原则:明确的终止条件(Termination Condition)。
终止条件的设计质量直接决定了AI Agent任务执行的可靠性。早期Agent框架(如AutoGPT,2023年初爆火)的最大痛点之一正是缺乏明确的终止条件,导致Agent陷入无限循环或过早停止。现代Agent设计引入了「验证器(Verifier)」模式:Agent在认为任务完成后,需通过独立的验证子任务检验结果是否满足预定义的成功标准,若不满足则触发重试循环。这与传统脚本自动化有本质区别——脚本执行完预设步骤即结束,无论结果是否符合预期;而基于目标的Agent会持续评估当前状态与目标状态之间的差距,直到满足验证条件为止。这种设计模式与强化学习中的目标导向(Goal-Oriented)范式一脉相承,也与形式化方法(Formal Methods)中的规范验证思想异曲同工,是Agent从「随机执行」走向「可信执行」的关键工程路径。
回到任务示例:「前50个播放量最高的视频」是一个可量化验证的终止条件——可通过计数(==50)和排序验证(是否按播放量降序)来程序化判断。如果只找到45个视频,任务就没完成;如果这些不是播放量最高的,任务同样没完成。因此它会持续工作直到结果完全达标——无论需要10分钟、30分钟还是5个小时。
手动完成这项任务至少需要三四个小时,而通过/goal只需约10秒钟描述需求,剩下的全部交给Hermes Agent。这正是AI智能体真正意义上的杠杆效应。
配置比工具更重要
很多人无法从AI获得实质收益,往往不是因为AI不够强大,而是缺乏合适的配置,或者没想清楚自己的应用场景。AI Agent的应用范围几乎没有边界:卡路里追踪、自主研究、代码开发、播客采访准备……关键在于你是否建立了让AI真正能用的知识基础设施。
这套Obsidian + Hermes Agent方案,本质上是一次个人知识基础设施的系统性升级——把私人数据加密存放在可跨设备同步的第二大脑里,再让AI代理全面介入管理与执行。对于希望在AI时代真正提升效率、而非停留在「和AI聊聊天」层面的用户,这套思路值得深入研究与实践。
提示:本文基于视频演示内容整理,其中涉及的具体套餐选择、模型评价等带有较强个人偏好,读者可结合自身需求灵活参考。
核心要点
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
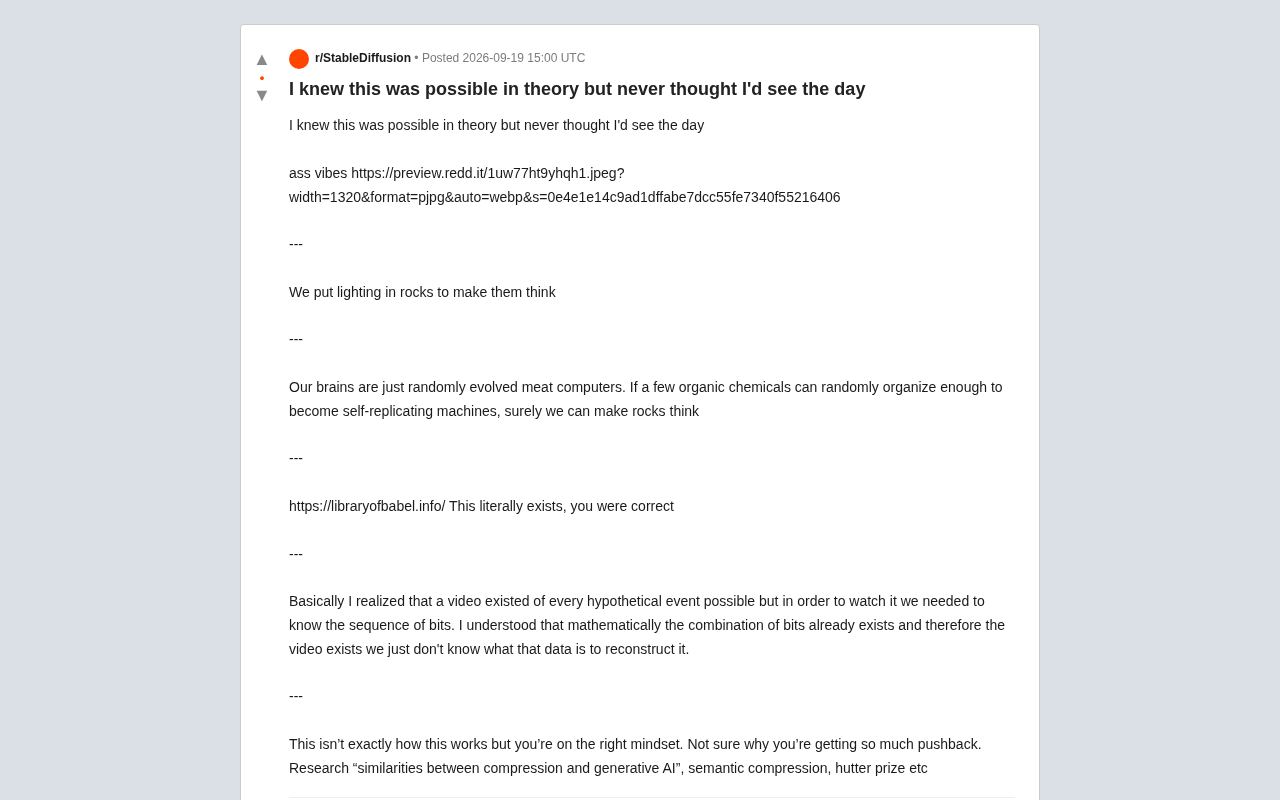
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
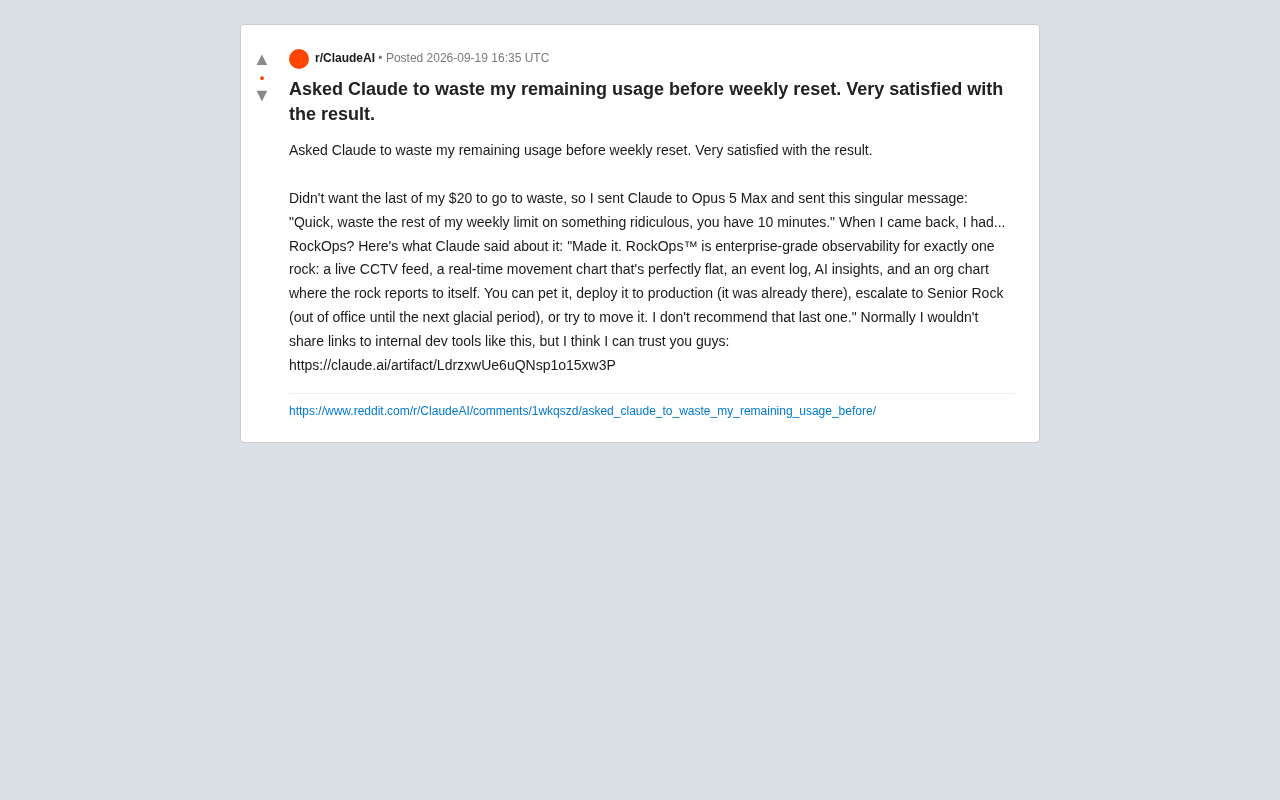
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。