Obsidian接入AI:开源四层骨架与四大技能

开源Agent骨架用四层仓库和四个技能为Obsidian中的AI划定行为边界。
B站UP主「鲸鱼大小姐」开源了一套面向Obsidian的Agent骨架,以MIT协议发布。其核心不是插件或模板,而是一份七万多字节的结构规范:将仓库分为知识层(人写)、看板层(只读)、技能层(Agent规则)和日志层(只追加),明确每层「谁可以写、写什么」,越界即视为故障。在此基础上设计了四个落地技能——日常整理(三档分类保守处理)、截止时间(只取公布DDL并标来源)、刷题(只判不带做)、课件转换(PDF转结构化LaTeX讲义)。知识层按Google OKF规范打包,配套离线测试与CI验证。方案强调可审计性和保守设计,但存在浏览器链路未实测、截图识别仅限macOS、无内置回滚等局限。
如果你在用 Obsidian 管理知识,却总觉得 AI 像个外人——只能靠你复制粘贴喂给它——那么 B 站 UP 主「鲸鱼大小姐」开源的一套 Agent 骨架,或许能改变这种尴尬。这套方案不是插件,不是模板,而是一套给 AI 画边界的结构规范:四层仓库、四个技能,全部开源,MIT 协议。
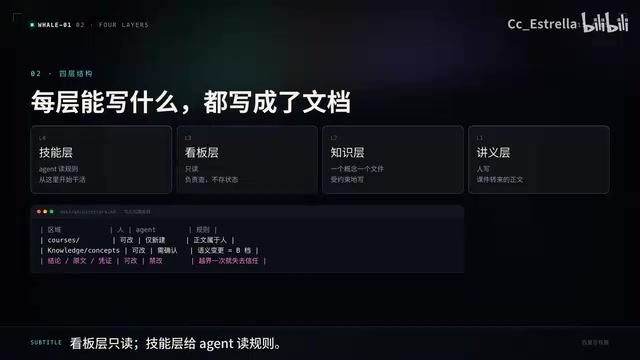
四层仓库:给 Agent 划清边界
这套骨架的核心思路,是把 Obsidian 仓库分成四层,每层明确「谁可以写、写什么」,并把这些规则写成文档。越过边界,就视为故障。
- 知识层:人写,一个概念一个文件。这是人类沉淀知识的地方,AI 不直接修改。
- 看板层:只读,供 AI 了解任务状态。
- 技能层:给 Agent 读的规则,定义它能做什么、不能做什么。
- 日志层:只允许追加,不允许覆盖。这一点来自惨痛教训——UP 主曾试过一条自动流程,把日志整段覆盖成了模型回答,虽然已经修复,但从此日志只允许追加。
这种分层设计,本质上是在 AI 介入知识管理时,用工程手段约束其行为边界。据 UP 主介绍,知识层按 Google 的 OKF 规范打包,一个概念一个文件,带类型和时间戳,每门课一个包,有索引也有日志。索引负责渐进披露,日志只允许追加。好处很实在:能 cat 就能读。
Google OKF 规范(Open Knowledge Format)是 Google 提出的一种面向知识管理的开放格式,强调以「一个概念一个文件」的方式组织知识,每个文件包含类型、时间戳等元数据,并通过索引实现渐进式披露。它与传统笔记堆叠的最大区别在于可审计性:任何工具(包括 AI Agent)都能通过读取索引和文件内容理解知识结构,而无需解析复杂的数据库或私有格式。OKF 的设计目标是让知识库像代码仓库一样可版本化、可 diff、可自动化处理,这与文中「能 cat 就能读」的理念高度契合。
四个技能:从整理到刷题
骨架搭好后,Agent 才真正算接入了 AI。UP 主设计了四个落地技能,每个都有明确的边界和操作规范。
日常整理:三档分类,保守处理
这个技能把问题分三档:机械项(缺字、日期写法错)直接改;语义项(这页该不该拆)先报告进「改进区」;结论原文凭证一个字不碰。如果分不清 A 和 B,就按 B 处理——也就是更保守的那一档。这种小心翼翼的设计,源于前面提到的日志覆盖事故。
截止时间:猜出来的 DDL 比没有更危险
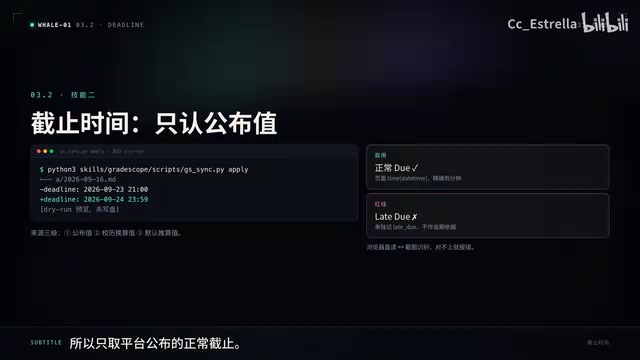
第二个技能处理截止时间。UP 主的原则很明确:猜出来的 DDL 比没有更危险,它会让你以为自己已经逾期。所以只取平台公布的正常截止时间,late do 单独记录,永不写进 deadline。每条都标来源:公布、换算还是推算。写入前先出 diff,人工点击确认才落盘。
刷题:只判不带做
第三个技能是刷题。判分必须落到第一个错误,错题入库,考前只出错过的加同概念变式。这个技能不替用户做题,只负责判分和整理错题,边界清晰。
课件转换:PDF 变结构化讲义
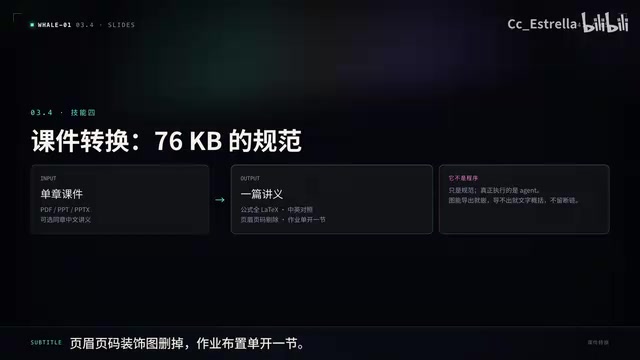
第四个技能是课件转换。一份 PDF 进来,变成结构化讲义:公式全部 LaTeX,英文课件配中文,艺术页眉页脚装饰图删掉,作业布置单开一节。
LaTeX 是一种排版系统,尤其擅长公式排版,在学术和工程领域被广泛使用。将 PDF 中的公式转换为 LaTeX 意味着公式从「不可编辑的图片或字形」变成了「可搜索、可修改的文本代码」,这对于知识管理和后续 AI 处理至关重要。例如,一个积分公式在 PDF 中只是视觉符号,而转为 LaTeX 后,Agent 可以理解其结构、提取变量、甚至生成变式题。这也是课件转换技能选择 LaTeX 而非保留原图的核心原因:可计算性优先于视觉保真。
七万字节的规范,不是程序
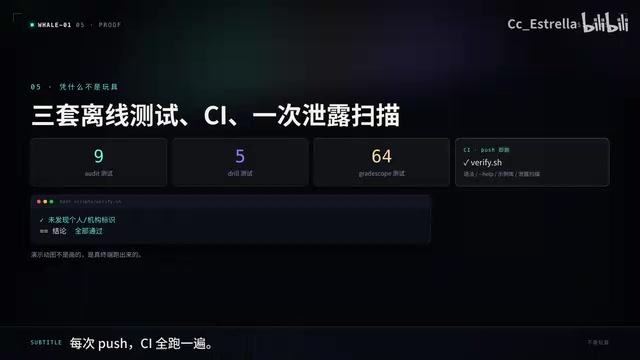
这套方案最特别的地方在于:它是一份七万多字节的规范,而不是一段程序。UP 主强调,知识层不是随便一堆笔记,而是按 Google OKF 规范打包的骨架。五个包、228 页文档,怎么证明它不是玩具?三套离线测试、九项、五项、六十四项,每次 push CI 全跑一遍。仓库里没有一个真实课程名,演示动图是真终端跑出来的。
使用流程分三步:clone 仓库、导出 Vault 路径、跑体检。第一步只读不改,拟任何文件想动手得显式加 apply。UP 主也坦诚了局限:浏览器链路没实测,截图识别只支持 macOS,没有内置回滚。一门课的清单写在 json 里,不进代码,换自己的库改一个配置就行。
CI(Continuous Integration,持续集成)是一种软件开发实践,指每次代码推送(push)后自动运行测试和构建流程,以尽早发现集成错误。文中提到的「每次 push CI 全跑一遍」意味着这套规范仓库配置了自动化流水线,三套离线测试(九项、五项、六十四项)会在每次提交时自动执行,确保规范文档和配套脚本的一致性。对于一份「不是程序」的规范来说,CI 的存在是一种可信度背书:它证明这套结构不是一次性写就的静态文档,而是像软件一样被持续验证和维护的活体规范。
开放与局限
这套骨架采用 MIT 协议,用得上就 star,用不上可以在 issue 里反馈。它代表了一种思路:AI 接入知识管理工具,不一定要做成插件或模板,也可以是一套约束 Agent 行为的规范。对于 Obsidian 用户来说,这或许是一个值得尝试的起点——前提是你能接受它的保守设计和当前局限。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。