OCR噪声下的LLM文档信息抽取:一份全面基准测评
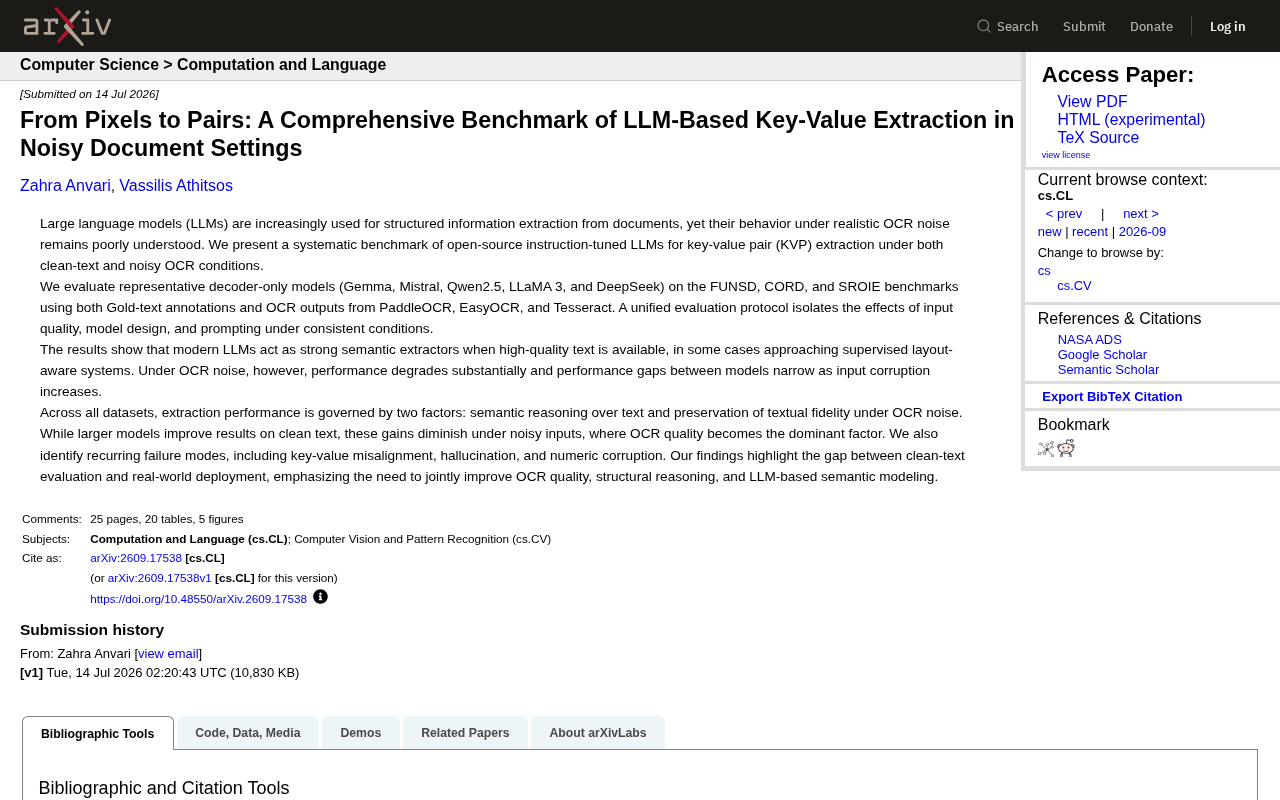
基准测评揭示LLM在OCR噪声下键值对抽取性能大幅下滑,输入质量比模型规模更关键。
论文《From Pixels to Pairs》系统评测了五款主流开源LLM(Gemma、Mistral、Qwen2.5、LLaMA 3、DeepSeek)在三个文档抽取基准数据集上的键值对抽取能力,并通过引入三种OCR引擎的真实输出,将"干净文本"与"含噪输入"两种条件进行严格对照。结果显示,LLM在高质量文本下已接近专用版面感知系统的水准,但OCR噪声会导致性能显著下滑,且输入损坏越严重,模型间的差距越趋于消失——此时OCR质量而非模型能力成为主导因素。研究还归纳出键值错位、幻觉、数字损坏三类典型失败模式,并指出真实部署需将OCR质量、结构化推理与LLM语义建模作为整体管线联合优化,而非孤立提升单一环节。
大语言模型(LLM)正越来越多地被用于从文档中抽取结构化信息,但它们在真实OCR噪声环境下的表现却鲜有系统研究。一篇发表于arXiv的最新论文《From Pixels to Pairs》对这一问题给出了严谨的基准测评,揭示了实验室干净文本与实际部署之间的巨大鸿沟。
研究要解决的核心问题
键值对(Key-Value Pair, KVP)抽取是文档智能的基础任务——从发票、表单、收据中识别出「字段名—字段值」这样的结构化信息。近年来,开源指令微调LLM被寄予厚望,人们希望用一个通用模型替代传统的、依赖版面感知的专用系统。
但现实往往被忽略:文档进入LLM之前,通常要先经过OCR(光学字符识别)转成文本。OCR并不完美,识别错误、字符缺失、数字损坏都会引入噪声。论文指出,学界的多数评测停留在「干净文本」(Gold-text)条件下,这与真实世界的部署场景严重脱节。研究团队因此设计了一套统一的评测协议,专门考察LLM在干净文本与含噪OCR两种条件下的差异。
OCR(光学字符识别)技术通过分析扫描图像或照片中的像素,将其转换为机器可读的文本字符。主流引擎包括商业方案(如Google Cloud Vision、Azure OCR)和开源方案(如本文使用的Tesseract、PaddleOCR、EasyOCR)。OCR引擎的识别质量受多重因素影响:文档打印质量、扫描分辨率、字体类型、版面复杂度以及光照条件。在财务文档、历史档案或低质量手机拍照场景中,OCR错误率可高达5%–20%,常见问题包括:字形相近字符互换(如"0"与"O"、"1"与"l")、多字符粘连或切割错误、小数点和货币符号丢失,以及多列版面的行顺序混乱。这些噪声会以不可预测的方式传递给下游的LLM,使得依赖上下文语义的推理任务面临严峻挑战。
实验设计:五大模型、三大数据集、三种OCR引擎
这项基准测评的覆盖面相当扎实。在模型层面,选取了具有代表性的开源decoder-only模型:Gemma、Mistral、Qwen2.5、LLaMA 3 以及 DeepSeek,构成了当前主流开源阵营的横切面。
数据集方面采用了文档抽取领域的三个经典基准——FUNSD(表单理解)、CORD(收据抽取)和 SROIE(扫描收据信息提取)。为了模拟真实的输入退化,研究者不仅使用了人工标注的Gold-text,还引入了三种常见OCR引擎的实际输出:PaddleOCR、EasyOCR 和 Tesseract。
这种「模型 × 数据集 × 输入质量」的交叉设计,让研究能够在一致条件下分离出三个变量的独立影响:输入质量、模型设计和提示(prompting)方式。这是该论文方法论上的关键贡献——避免了以往评测中变量混杂、结论难以复现的问题。
FUNSD、CORD和SROIE是文档信息抽取领域的三个标志性基准数据集,各自侧重不同场景。FUNSD(Form Understanding in Noisy Scanned Documents)包含扫描表单图像,标注了文本区域、字段语义角色及字段间关系,噪声水平较高。CORD(Consolidated Receipt Dataset)聚焦零售收据,包含来自印度尼西亚的多样化票据图像,标注粒度细化到商品名称、价格、税额等字段。SROIE(Scanned Receipts OCR and Information Extraction)是ICDAR 2019竞赛数据集,针对英文扫描收据,要求抽取商家名称、日期、地址和总金额四类关键字段。三者在版面结构、语言复杂度和字段类型上的差异,使得跨数据集的评测结论更具泛化意义。
关键发现:干净文本下强,噪声下退化明显
结果呈现出清晰的两面性。当输入为高质量文本时,现代LLM表现出强大的语义抽取能力,某些情况下已经逼近经过监督训练的版面感知专用系统。这印证了通用大模型在结构化理解上的潜力。
然而,一旦引入OCR噪声,性能便大幅下降。更耐人寻味的是,随着输入损坏程度加深,不同模型之间的性能差距反而收窄。换句话说,在干净文本上领先的模型,在噪声环境中的优势会被抹平。
论文将抽取性能归结为两个主导因素:对文本的语义推理能力 与 OCR噪声下文本保真度的保持。更大的模型能在干净文本上带来提升,但这些收益在含噪输入下逐渐消失——此时OCR质量本身成为决定性因素。这意味着,盲目堆叠模型参数并不能解决真实部署中的问题,输入端的质量瓶颈往往更关键。
反复出现的失败模式
研究还归纳出几类典型的错误模式,对工程落地颇具参考价值:
- 键值错位(key-value misalignment):模型将字段名与错误的值配对,尤其在版面信息丢失后更易发生。
- 幻觉(hallucination):模型凭空生成文档中并不存在的内容,这在噪声导致信息缺失时尤为突出。
- 数字损坏(numeric corruption):金额、日期等数值型字段被OCR错误传导,进而被模型固化输出,对财务类文档危害极大。
这些失败模式提醒开发者,在生产环境中不能只看整体准确率,还需针对性地监控这些高风险错误。
幻觉(Hallucination)是大语言模型的一种系统性缺陷,指模型生成的内容在事实上不正确或在原始输入中根本不存在,却以高置信度呈现。在文档抽取任务中,幻觉的成因与通用问答场景有所不同:当OCR噪声导致原始字段信息残缺或语义模糊时,模型会倾向于用训练数据中常见的"合理"值填补空白,例如将损坏的日期补全为某个格式正确但内容错误的日期,或将缺失的税率替换为常见的默认值。这种"有害的纠错"行为在输出层面难以与正确抽取区分,却会在财务、法律等对精确度要求极高的场景中造成严重后果。因此,针对幻觉的检测需要独立于准确率之外的专项评估机制,例如对比模型输出与原始OCR文本的字面对应关系。
对实际部署的启示
这项研究最有价值的结论,是明确指出了「干净文本评测」与「真实部署」之间的落差。很多在论文榜单上表现亮眼的方案,一旦接入真实OCR管线,效果就会大打折扣。
论文给出的方向是「联合优化」:不能孤立地提升某一环节,而应同时改进OCR质量、结构化推理能力和LLM的语义建模。对于正在构建文档智能系统的团队而言,这意味着在选型时不应只盯着模型排行榜,而要把整条数据管线——从像素到键值对(from pixels to pairs)——作为一个整体来评估和优化。
随着多模态大模型的兴起,未来或许能跳过独立OCR步骤,直接从图像端到端抽取信息。但在当前以文本LLM为主的架构下,这份基准测评提供了一个务实且清醒的参照。
相关推荐
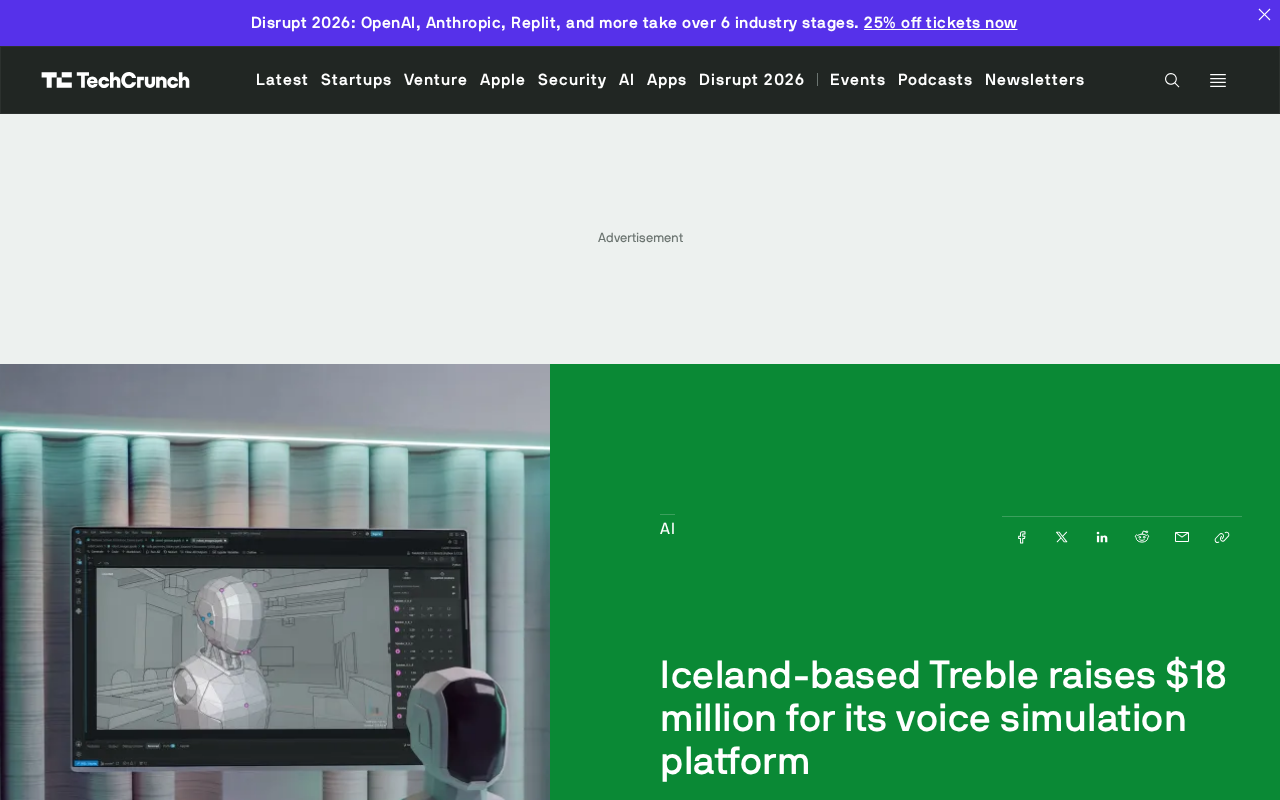
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
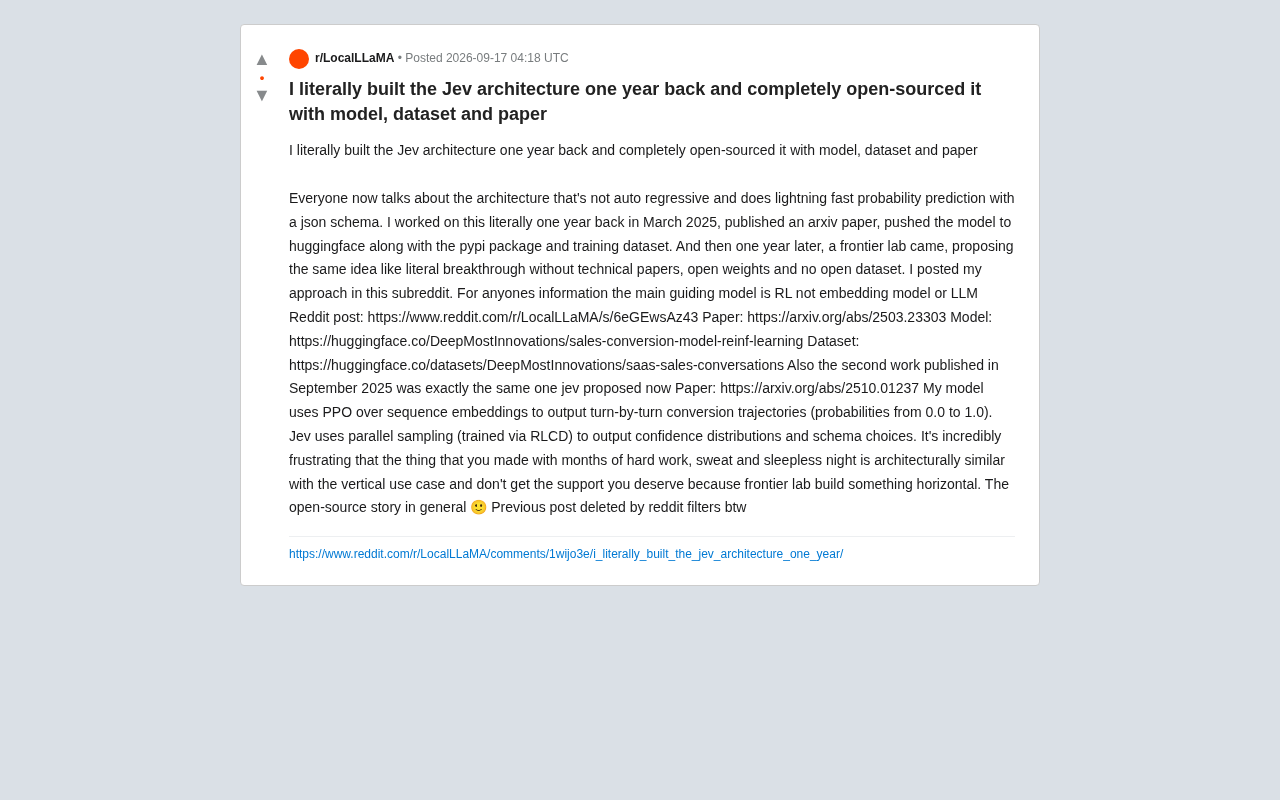
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
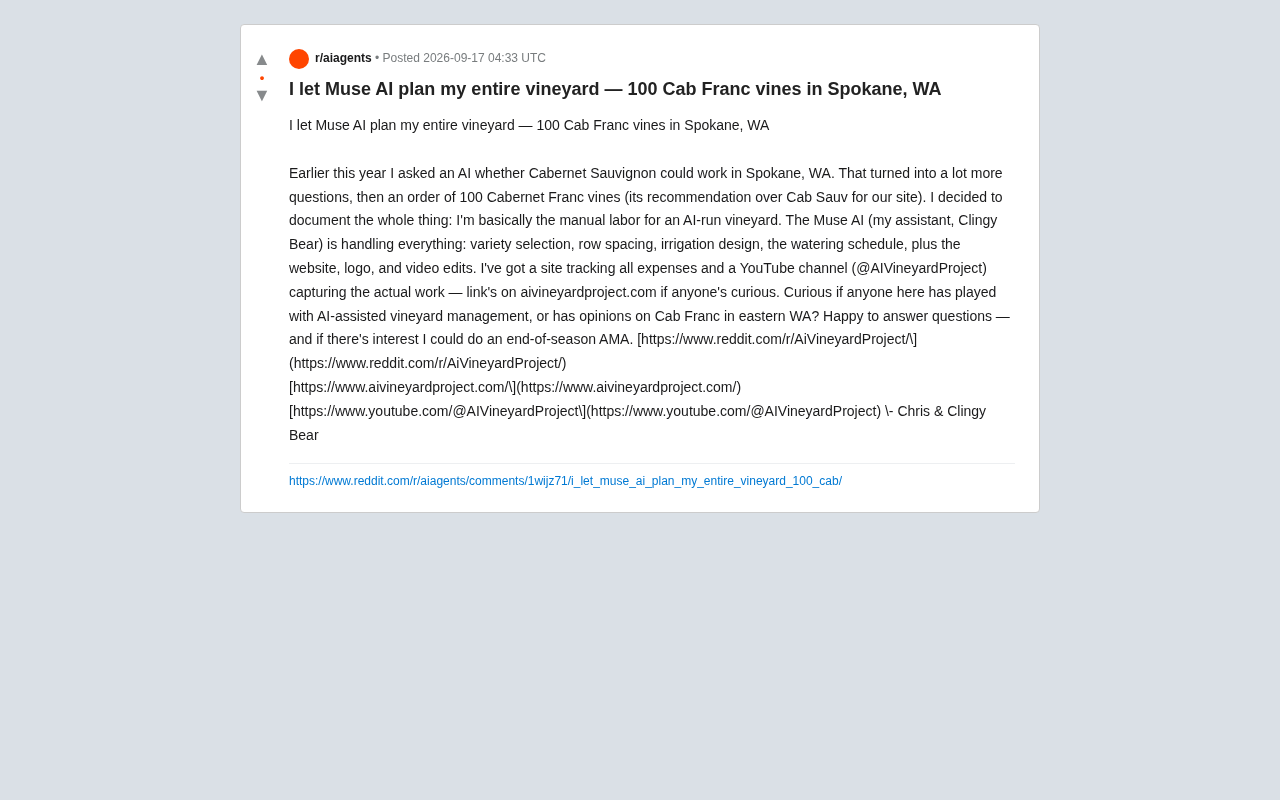
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。