Oído:5美元单片机实现开放词汇语音识别

5美元ESP32-S3上跑通开放词汇语音识别,WER低至3.7%,甚至超过笔记本上的Whisper tiny。
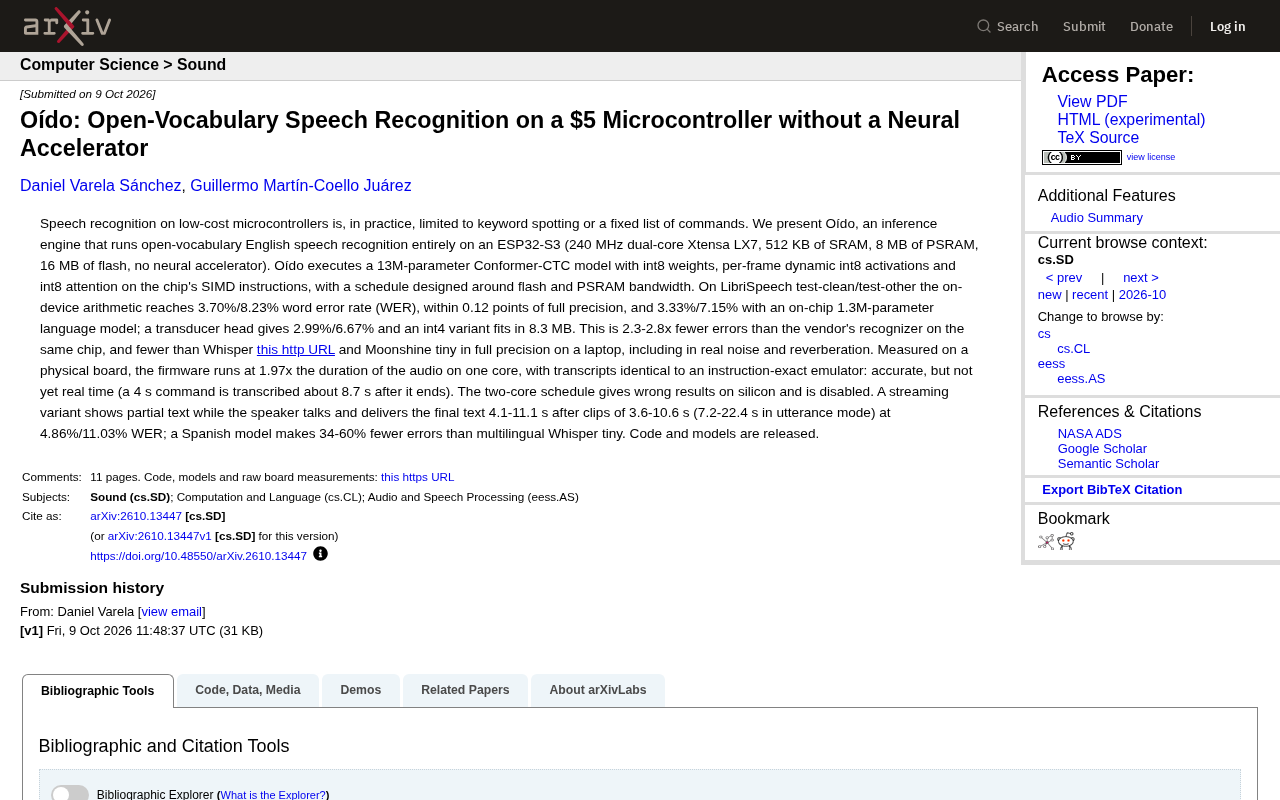
研究项目 Oído 在一颗售价约 5 美元、无任何神经网络加速器的 ESP32-S3 微控制器上,实现了完整的开放词汇英语语音识别。其核心是一个 1300 万参数的 Conformer-CTC 模型,通过 int8 量化与带宽感知调度,在 LibriSpeech test-clean/test-other 上取得 3.70%/8.23% 的词错误率,与全精度版本仅差 0.12 个百分点。横向对比中,Oído 的准确度不仅比同芯片厂商方案少 2.3–2.8 倍错误,甚至优于在 x86 笔记本上全精度运行的 Whisper tiny.en。当前主要制约是延迟——单核推理速度约为音频时长的 1.97 倍,尚未达到实时。项目代码与模型均已开源,为低功耗、离线、隐私保护的边缘语音 AI 场景提供了可直接参考的工程样本。
把语音识别塞进5美元的芯片
在低成本微控制器上做语音识别,长期以来只能停留在关键词唤醒或固定命令集的层面——你喊“开灯”“关灯”它能听懂,但想让它逐字转写一整句自由表达的英文,几乎是不可能的任务。研究项目 Oído 打破了这个边界:它是一套完整的推理引擎,能在一颗 ESP32-S3 上运行**开放词汇(open-vocabulary)**的英语语音识别。
这颗芯片的配置相当朴素:240 MHz 双核 Xtensa LX7,512 KB SRAM,8 MB PSRAM,16 MB flash,而且没有任何神经网络加速器。换句话说,所有的算力都来自通用 CPU 核心和它的 SIMD 指令集。能在这样的硬件上跑通端到端语音转写,本身就是一次工程上的硬仗。
模型与量化:13M 参数如何挤进单片机
Oído 的核心是一个 1300 万参数的 Conformer-CTC 模型。为了让它在内存和带宽都极为有限的芯片上运行,团队采用了激进但精细的量化策略:
- 权重 使用 int8
- 激活值 采用逐帧动态 int8
- 注意力机制 同样跑在 int8 精度上,直接利用芯片的 SIMD 指令
更关键的是,整个计算调度是围绕 flash 和 PSRAM 带宽设计的。在没有专用加速器的情况下,内存带宽往往才是真正的瓶颈,而非纯算力。合理安排数据搬运的节奏,是让这类模型跑得起来的前提。
精度几乎无损
量化通常意味着精度损失,但 Oído 的表现令人意外。在 LibriSpeech 的 test-clean/test-other 数据集上,设备端的运算达到了 3.70% / 8.23% 的词错误率(WER),与全精度版本仅相差 0.12 个百分点。
如果再加上一个片上运行的 130 万参数语言模型,WER 进一步降至 3.33% / 7.15%;换用 transducer 头部结构可达到 2.99% / 6.67%;而一个 int4 变体甚至能压缩到 8.3 MB 的体积。
Conformer-CTC 是当前语音识别领域的主流架构之一。Conformer(Convolution-augmented Transformer)在标准 Transformer 的注意力机制之外,引入了卷积模块来捕捉局部音频特征,两者互补使得模型既能建模长程依赖又能感知短时声学细节。CTC(Connectionist Temporal Classification)则是一种序列对齐方式,允许模型在不需要帧级标注的情况下直接预测文字序列,避免了传统 HMM-DNN 流水线的复杂性。这种组合在离线批处理与流式推理上都有良好表现,是 Whisper 之外另一条被广泛验证的端到端语音识别路线。选择 Conformer-CTC 而非 Whisper 的编码器-解码器结构,对于边缘部署有实际意义:CTC 的解码过程计算量更低,不需要自回归逐步生成,天然适合算力受限的场景。
WER(词错误率,Word Error Rate)是语音识别领域最通用的评测指标,计算方式是将识别结果与参考文本进行对齐,统计替换、删除和插入错误的总词数,再除以参考文本的总词数。LibriSpeech 是由 LibriVox 有声读物录音构建的标准英语语音数据集,test-clean 子集为发音清晰、噪声较少的样本,test-other 则包含口音较重或录音质量较差的挑战性样本。行业惯例上,低于 5% 的 WER 在 test-clean 上已属于竞争力较强的结果,而能在 test-other 上保持 8% 左右的系统通常需要显著更大的模型或更多训练数据。Oído 在资源极度受限的设备端取得这一成绩,意味着量化引入的信息损失被精细的训练与校准策略大幅弥补。
和竞品比,谁更准
Oído 真正令人印象深刻的地方在于横向对比。在同一颗芯片上,它的错误率比芯片厂商自带的识别器少 2.3 到 2.8 倍。
更夸张的是跨平台对比:在包含真实噪声和混响的条件下,Oído 的识别准确度甚至优于在笔记本电脑上全精度运行的 Whisper tiny.en 和 Moonshine tiny。一个跑在 5 美元单片机上的模型,错误数比运行在 x86 笔记本上的轻量级 Whisper 还少,这确实颠覆了“小硬件只能跑小能力”的直觉。
西班牙语模型的表现同样亮眼——相比多语言版 Whisper tiny,它的错误减少了 34% 到 60%。
Whisper 是 OpenAI 于 2022 年发布的开源语音识别模型系列,以大规模弱监督训练著称,覆盖多语言与多任务场景。其中 Whisper tiny.en 是专为英语优化的最小版本,参数量约 39M,在笔记本 CPU 上运行尚需数倍于实时的时间。Moonshine tiny 是 Useful Sensors 针对边缘设备优化的轻量级语音识别模型,同样定位低延迟场景。Oído 能在噪声与混响条件下超越这两个在更强硬件上运行的模型,一定程度上得益于 Conformer-CTC 架构对声学特征的精细建模,以及针对目标场景专门优化的训练数据配比,而非单纯依赖参数规模取胜。这也说明在特定任务和部署场景下,架构与训练策略的适配度往往比绝对参数量更具决定性。
速度:准确,但还不是实时
工程的另一面是性能。在真实开发板上实测,固件在单核上以音频时长 1.97 倍的速度运行。也就是说,一段 4 秒的指令,在说完约 8.7 秒后才能得到转写结果。这是“准确但尚未实时”的状态。
团队诚实地披露了一个遗憾:双核调度方案在实际硅片上会给出错误结果,因此被禁用了。能跑通单核已属不易,双核的并行调度显然还有待解决。
流式识别缓解延迟
为了改善体验,Oído 还提供了流式(streaming)变体:在说话者还在讲话时就显示部分文本,并在 3.6–10.6 秒的片段结束后 4.1–11.1 秒给出最终结果(整句模式下则是 7.2–22.4 秒),WER 为 4.86% / 11.03%。流式方案牺牲了一点准确率,换来了可感知的即时反馈。
为什么这件事重要
Oído 的意义不只是一个跑分数字。它证明了在没有专用 AI 加速器的廉价通用微控制器上,开放词汇的连续语音识别是可行的。这为大量嵌入式、离线、低功耗的场景打开了想象空间——完全本地运行意味着不依赖云端、不上传语音、保护隐私,且无网络延迟与成本。
从技术路线看,它的价值在于把“量化 + 带宽感知调度 + SIMD 利用”这套组合拳打到了极致,而不是依赖硬件堆料。项目的代码和模型均已开源,这对于希望在边缘设备上落地语音能力的开发者来说,是一份可直接参考与复现的实践样本。
当然,延迟问题和双核调度的硅片 bug 说明它距离产品级实时体验仍有距离。但作为研究与工程的结合体,Oído 清晰地标出了低成本语音 AI 的新上限。
相关推荐

AI红利仅限科技圈?非科技行业难见回报
Apollo分析指出,AI的经济回报目前高度集中在科技行业,非科技领域尚无可量化收益迹象。本文梳理其核心论点、Hacker News上的分歧观点,以及对企业AI投入与衡量的实际启示。

AI时代,BBC《蓝色星球III》为何刻意保留“不完美”镜头?
BBC《蓝色星球III》在AI时代反其道而行,刻意保留不完美镜头以证明画面真实性。本文分析这一策略背后的信任逻辑,以及它对内容创作者在AI时代的启示。

FreeDNS:免费动态DNS服务的经典之选
FreeDNS 是一个提供免费动态 DNS 托管服务的平台,支持共享域名池和 HTTP 更新。本文介绍其核心功能、社区评价、适用场景及与其他 DNS 方案的对比。