Oído开源语音识别:5美元单片机跑赢Whisper-tiny
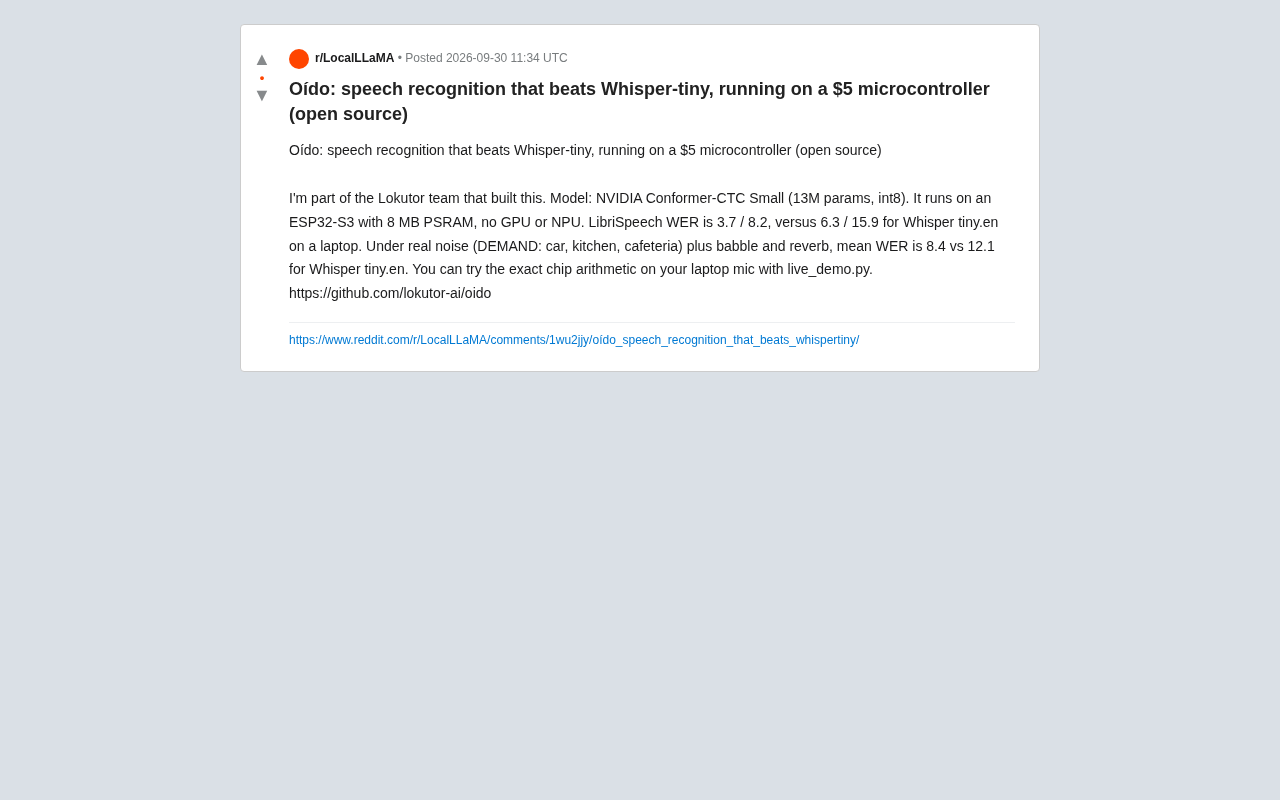
5美元ESP32-S3芯片上跑13M参数量化模型,语音识别精度超越笔记本端Whisper-tiny
Oído 是 Lokutor 团队开源的边缘语音识别项目,将 NVIDIA Conformer-CTC Small(13M参数,int8量化)部署在约5美元的 ESP32-S3 微控制器(配8MB PSRAM)上,无需GPU或NPU。在 LibriSpeech 基准上,其词错误率(WER)为3.7/8.2,远低于笔记本端 Whisper-tiny.en 的6.3/15.9;在叠加 DEMAND 噪声、多人交谈背景音和混响的真实噪声环境下,平均WER同样以8.4对12.1胜出。这一结果表明,通过选择结构上适合低延迟流式推理的 Conformer-CTC 架构并精准适配硬件,可以在成本极低的嵌入式设备上实现超越更大型通用模型的识别精度,为离线、隐私保护的边缘语音应用提供了务实的技术路径。项目已在 GitHub 开源,并提供本地复现脚本。
边缘AI的一个长期难题是:如何在没有GPU、没有NPU、内存以MB计的微控制器上跑出可用的语音识别?由Lokutor团队开源的 Oído 项目给出了一个颇具说服力的答案——它在一颗售价约5美元的ESP32-S3芯片上运行,识别精度还超过了在笔记本上运行的Whisper-tiny.en。
用13M参数模型撬动边缘语音识别
Oído 采用的是 NVIDIA 的 Conformer-CTC Small 模型,参数量约1300万(13M),并经过 int8 量化处理。相比动辄数千万乃至上亿参数的主流语音模型,这个体量已经相当轻巧,而 int8 量化进一步压缩了内存与算力需求,使其能够塞进资源极度受限的嵌入式环境。
运行平台是 ESP32-S3 配 8MB PSRAM——一颗典型的物联网级微控制器,没有独立GPU,也没有专用神经网络加速单元(NPU)。整套推理完全依赖芯片本身的算术能力完成。这意味着语音识别不再必须依托云端或高性能终端,而可以真正下沉到成本极低的硬件上。
Conformer-CTC 是两项技术的结合:Conformer 是 Google 于2020年提出的架构,在 Transformer 的自注意力机制基础上融入卷积模块,能同时捕捉语音的长距离依赖和局部声学特征,在语音识别任务上显著优于纯 Transformer 或纯 CNN 方案。CTC(Connectionist Temporal Classification,联结时序分类)则是一种解码策略,无需对输入帧与输出字符做显式对齐,直接端到端优化序列概率,推理时可逐帧输出而无需等待完整语句,天然适合低延迟的流式场景。与 Whisper 采用的自回归解码器相比,CTC 的计算量更可预期、延迟更低,这正是在资源受限的微控制器上能够落地的关键原因之一。int8 量化则是将模型权重和激活值从32位或16位浮点压缩为8位整数,内存占用和计算量均可降低约4倍,精度损失通常在可接受范围内,是边缘部署的标准手段。
精度对比:小芯片跑赢笔记本上的Whisper-tiny
项目最引人注目的地方,是它在标准数据集和真实噪声环境下的表现,都优于运行在笔记本上的 Whisper tiny.en。
LibriSpeech 干净语音测试
在 LibriSpeech 基准上,Oído 的词错误率(WER)为 3.7 / 8.2(分别对应 clean 与 other 两个子集),而 Whisper tiny.en 在笔记本上的成绩是 6.3 / 15.9。数字越低越好,Oído 在两项指标上都实现了近乎一半的错误率下降。
LibriSpeech 是目前语音识别领域最通用的英语基准数据集,来源于有声书录音,共约1000小时。其测试集分为 test-clean(录音质量良好、口音标准)和 test-other(录音条件较差或口音较重)两个子集,后者被视为更具挑战性的衡量指标。词错误率(WER,Word Error Rate) 的计算方式是将识别结果与参考文本之间的替换、插入、删除操作数之和除以参考文本总词数,数值越低代表识别越准确。3.7% 的 clean WER 在13M量级的小模型中属于相当出色的成绩,接近许多参数量大一个数量级的模型水平。
真实噪声环境测试
实验室干净语音并不能代表真实使用场景。团队进一步引入 DEMAND 噪声数据集(涵盖汽车、厨房、餐厅等环境),并叠加了多人交谈背景音(babble)和混响(reverb)。在这种更贴近现实的条件下,Oído 的平均 WER 为 8.4,而 Whisper tiny.en 为 12.1。
值得关注的是,一颗5美元芯片在噪声鲁棒性上反超了跑在笔记本上的通用模型,这对边缘设备的实用性是很强的信号。
DEMAND(Diverse Environments Multichannel Acoustic Noise Database)是一个专为语音增强与噪声鲁棒性研究设计的噪声数据库,包含办公室、地铁、餐厅、厨房等16种真实环境录制的背景噪声,常被用于将干净语音与噪声混合后评估模型的抗噪能力。Babble噪声指多人同时交谈产生的背景人声,对语音识别系统尤为棘手,因为其频谱特征与目标语音高度重叠。**混响(Reverb)**则模拟声波在封闭空间内的多次反射,会造成语音波形"拖尾",使帧级声学特征模糊。这两类干扰是真实家居和公共场所部署中最常见的挑战,Oído 在此条件下仍保持领先,说明 Conformer 的卷积模块对局部时频扰动具有一定的内在鲁棒性。
为什么这件事重要
主流语音识别方案通常有两条路:要么走云端API,带来延迟、隐私和联网依赖问题;要么在本地跑较大的模型,对硬件要求偏高。Oído 展示的路径则是把一个针对性优化的小模型部署到极廉价的硬件上,同时保持可接受甚至更优的精度。
这背后有几点技术选择值得琢磨。其一,Conformer-CTC 架构在流式、短时语音识别上本就有结构优势,配合 CTC 解码在低延迟场景下比自回归的 Whisper 更从容。其二,针对特定芯片做 int8 量化并复现芯片上的精确算术,意味着开发者可以在笔记本上通过 live_demo.py 直接体验与真实芯片一致的推理结果,降低了验证门槛。
对于智能家居、可穿戴设备、离线语音助手等场景,这种"低成本+离线+高精度"的组合极具吸引力。设备无需联网即可完成本地语音理解,既保护隐私又削减了持续的云端成本。
如何上手
项目已在 GitHub 开源(lokutor-ai/oido)。团队提供了 live_demo.py,可以用笔记本麦克风直接跑通与芯片一致的推理流程,方便开发者在投入硬件之前先行评估效果。
需要提醒的是,目前的对比数据来自项目团队自述,感兴趣的开发者可以通过开源代码自行复现验证。对于评估任何"跑赢某某模型"的声明,独立复测始终是最稳妥的做法。
小结
Oído 用一个13M参数的量化 Conformer-CTC 模型,在5美元级别的 ESP32-S3 上实现了超越笔记本端 Whisper-tiny 的语音识别精度,无论是干净语音还是嘈杂环境都占优。它代表了边缘语音AI的一种务实方向:不追求参数规模,而是把合适的模型精准适配到极低成本的硬件上。对做嵌入式语音产品的团队来说,这个开源项目值得一试。
相关推荐

n8n入门实战:从零搭建你的第一个AI工作流
n8n入门实战教程:从自动化基本概念讲起,一步步教你用n8n搭建第一个AI工作流,连接Gemini模型,实现自动智能回复。涵盖节点、触发器、API Key配置、系统提示词等核心知识,适合零基础学习者。

AI自动修复生产崩溃:n8n+Dify打造自愈运维流水线
一个生产环境崩溃的真实案例:如何用 n8n 工作流、Dify AI 调试代理和 ChatGPT 构建自愈式运维流水线,自动捕获错误、修复代码并重新部署。附技术栈拆解与落地风险分析。

Anthropic向警方举报日记内容:AI隐私边界引发争议
Anthropic被曝将用户日记内容上报警方,导致一名女性面临重罪指控,在Hacker News引发热议。本文探讨AI隐私边界、服务商举报义务与用户信任之间的深层矛盾。