Ollama v0.35.0-rc1 发布:MLX 拉取重试优化
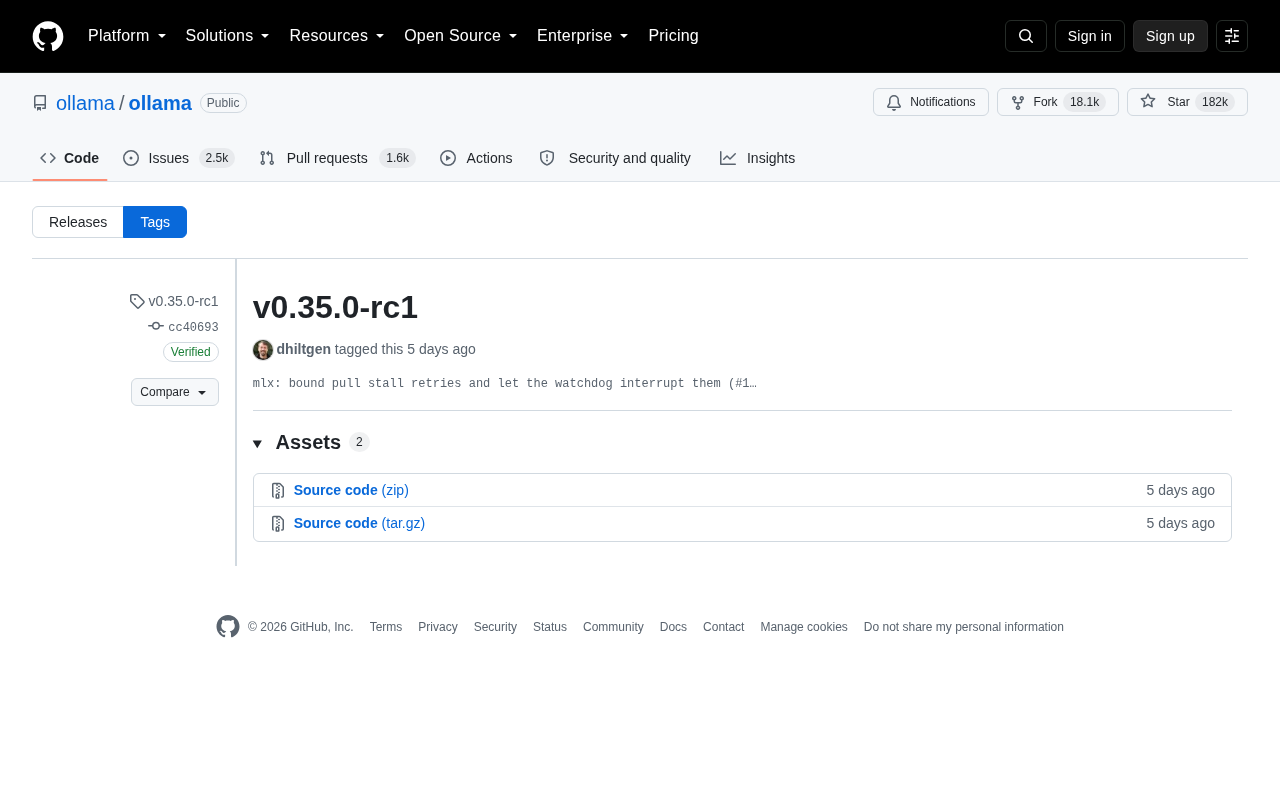
Ollama 发布 v0.35.0-rc1,核心改进 MLX 后端拉取稳定性,引入看门狗机制防止下载卡死。
本地大模型运行框架 Ollama 发布了 v0.35.0-rc1 候选版本,标志着新版本进入正式发布前的最终测试阶段。此次版本的核心改动聚焦于 MLX 后端:为模型拉取过程中的停滞重试设置次数上限,并引入看门狗机制在重试卡死时主动中断,解决了网络不稳定环境下下载进程长时间挂起的问题。MLX 是苹果专为 Apple Silicon 设计的机器学习框架,Ollama 对其持续优化体现了对 Mac 平台本地推理场景的重视。该版本通过 GitHub 验证签名发布,来源可信,但作为 rc1 候选版本,主要面向进阶测试用户,生产环境建议等待正式版后再升级。
Ollama 发布 v0.35.0-rc1 预览版
本地大模型运行框架 Ollama 近日在 GitHub 上标记了新的候选版本 v0.35.0-rc1。作为一个已经收获超过 18.2 万 Star、被广泛用于本地部署开源大语言模型的工具,Ollama 的每次版本迭代都会受到开发者社区的密切关注。此次发布的 rc1(Release Candidate 1,第一候选版本)意味着该版本已进入发布前的最终测试阶段。
从 GitHub 的提交记录来看,该版本的标签由维护者 dhiltgen 创建,并通过 GitHub 的验证签名(Verified)确认,GPG 密钥 ID 为 B5690EEEBB952194。这种签名机制保证了发布包的来源可信,对于需要在生产环境部署的用户而言是一项重要的安全保障。
本次更新的核心改动
从公开的提交信息中可以看到,本次候选版本的一项关键改动与 MLX 后端相关:
mlx: bound pull stall retries and let the watchdog interrupt them(为 MLX 的拉取停滞重试设置上限,并允许看门狗机制中断它们)
这项改动针对的是模型拉取(pull)过程中可能出现的停滞问题。在实际使用中,当网络不稳定或远程仓库响应缓慢时,模型下载可能陷入反复重试而无法推进的状态。此次更新为重试次数设置了边界(bound),并引入看门狗(watchdog)机制在重试卡死时主动中断,从而避免进程长时间挂起。
为什么 MLX 值得关注
MLX 是苹果推出的面向 Apple Silicon 芯片的机器学习框架,充分利用了 M 系列芯片的统一内存架构。Ollama 对 MLX 的持续优化,反映出其对 Mac 平台本地推理场景的重视。对于在 MacBook 或 Mac Studio 上运行本地模型的用户来说,拉取流程的稳定性直接影响部署体验。
MLX 的统一内存架构(Unified Memory Architecture)是理解其性能优势的关键。传统桌面平台中,CPU 与 GPU 拥有各自独立的内存,数据在两者之间传输会带来额外延迟与带宽瓶颈。Apple Silicon 则将 CPU、GPU、神经网络引擎(Neural Engine)的内存合并为单一内存池,消除了数据拷贝开销。这使得大语言模型的权重可以被 GPU 直接访问,对运行参数量较大的模型(如 7B、13B 量级)时尤为有利。MLX 正是专门围绕这一架构设计的,支持懒惰计算(lazy evaluation)和函数变换(function transformations),其 API 风格兼顾了 NumPy 与 PyTorch 的习惯,便于开发者迁移现有代码。Ollama 集成 MLX 后端,意味着 Mac 用户在本地推理时可以绕过通用的 CPU 路径,直接利用 M 系列芯片的硬件优势,获得更低延迟和更高吞吐量。
看门狗(watchdog)机制是软件工程中一种经典的可靠性模式,最初源于嵌入式系统。其核心思想是设置一个独立的监控进程或定时器,若被监控的任务在规定时间内未完成或未发出心跳信号,看门狗便主动介入并强制终止或重启该任务。在网络 I/O 场景下,重试逻辑若缺乏上限约束,容易陷入"活锁"(livelock)状态——进程持续运行但毫无进展,既占用资源又无法被外部感知为失败。此次 Ollama 的改动结合了两层防护:一是为重试次数设置硬性上限(bound),防止无限循环;二是让看门狗拥有中断权限,确保即便重试逻辑本身出现异常也能被兜底处理。这种双重机制在分布式系统和客户端工具中均属最佳实践,能显著提升用户在网络不稳定环境下的体验确定性。
候选版本意味着什么
需要明确的是,rc1 属于候选版本而非正式稳定版。这类版本主要面向愿意提前测试新功能、帮助发现�ign题的进阶用户。对于追求稳定性的生产环境,通常建议等待正式版发布后再升级。
版本发布页面提供了对应的构建产物(Assets),用户可以下载并进行测试。社区在这一阶段的反馈,往往会决定正式版本能否顺利推出以及是否需要进一步修复。
对开发者的实际意义
Ollama 作为本地化部署大模型的主流工具之一,其优势在于简化了模型下载、管理与推理的全流程。此次围绕拉取稳定性的改进虽然属于细节优化,但对日常频繁拉取和切换模型的开发者而言,能够有效减少因网络问题导致的卡顿与等待。
考虑到本地大模型运行对硬件和网络环境的高要求,这类底层可靠性改进的价值往往不亚于新增功能。建议关注 Ollama 的用户持续留意后续正式版的发布说明,以获取完整的变更列表。
注:本文基于 Ollama 官方 GitHub 发布页面的公开信息整理,由于 rc1 为候选版本,完整更新内容以最终正式版发布说明为准。
相关推荐
从空气中制造汽油:合成燃料为何尚未普及?
合成燃料能用空气中的二氧化碳、水和电力制造汽油、甲烷和火箭推进剂。本文解析萨巴蒂埃反应与费托合成的化学原理、热力学税、碳中和账本,以及合成燃料为何尚未普及、又将如何重塑能源地缘格局。
Router Rumble:用WiFi路由器演示梯度下降为何败给NSGA-II
Router Rumble 是一个开源 Python 项目,通过在模拟房间摆放 WiFi 路由器,直观对比梯度下降与 NSGA-II 进化算法在离散目标函数上的表现,揭示无梯度优化方法的优势。
CSL-Core:给LangChain智能体工具调用加上可验证的安全策略
开源CLI工具CSL-Core为LangChain智能体的每次工具调用加上经Z3验证的安全策略,支持扫描权限、生成策略、log观察模式与CI审计,不改动提示词即可拦截危险操作。