Ollama v0.40.0-rc4 发布:MLX 版本升级要点解析

Ollama 发布 v0.40.0-rc4,主要升级 Apple MLX 框架版本并优化单元测试内存占用。
Ollama 发布了 v0.40.0 正式版前的第 4 个候选版本 v0.40.0-rc4,本次迭代以框架维护和工程优化为主旋律。核心改动是跟进升级 Apple MLX 机器学习框架版本,MLX 专为 Apple Silicon 统一内存架构设计,此次升级预计为 Mac 用户带来推理性能优化和更好的模型格式兼容性。另一项改动是为单元测试引入更细粒度的 scopes,通过缩短测试夹具的生命周期来降低 CI 运行时的内存压力,属于提升项目工程质量的基础设施维护。该版本经 GitHub GPG 签名验证,适合愿意尝鲜的开发者参与测试反馈,生产环境建议等待正式版发布。
Ollama 发布 v0.40.0-rc4 预览版
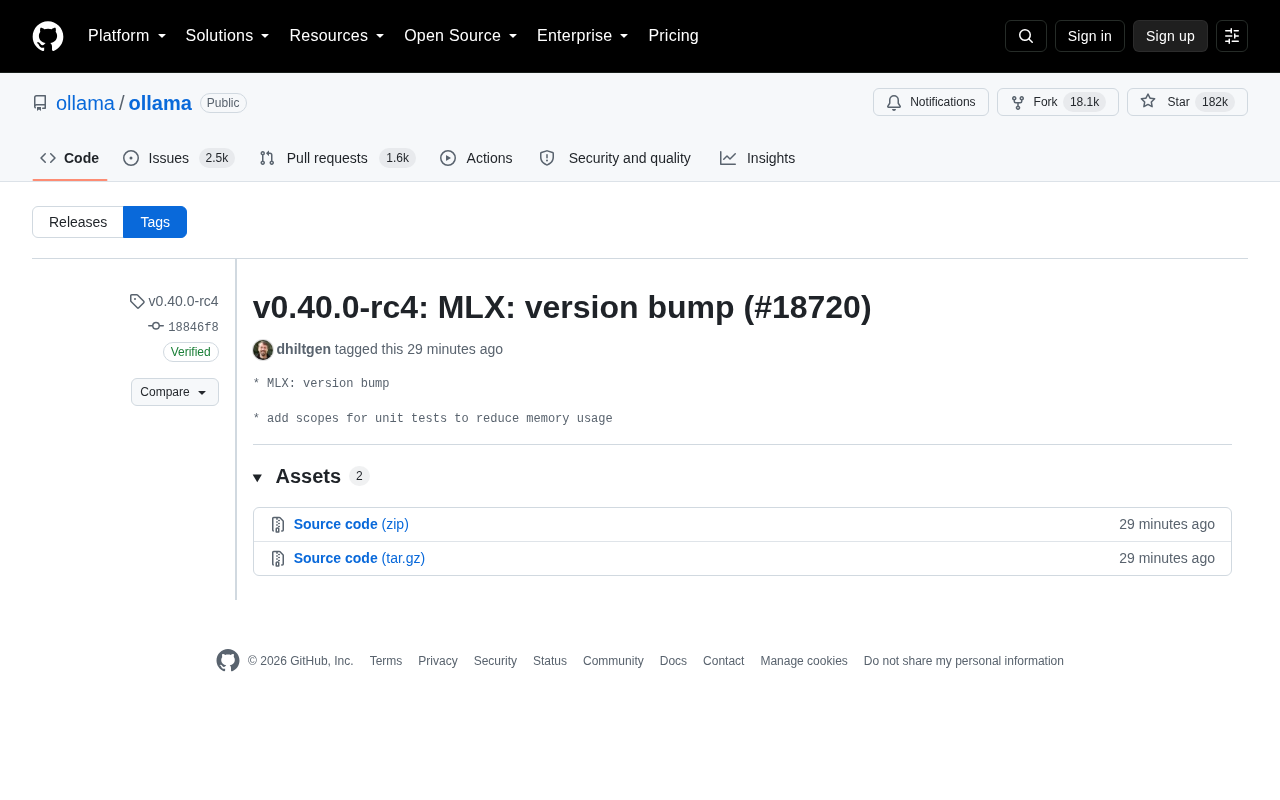
Ollama 作为目前最流行的本地大模型运行框架之一,在 GitHub 上已积累超过 18 万 Star 和 1.8 万 Fork,是开源 AI 社区的重要基础设施。近期该项目发布了 v0.40.0-rc4 预览版(Release Candidate 4),由维护者 dhiltgen 完成标记。该版本经 GitHub 验证签名(GPG key ID: B5690EEEBB952194),属于正式发布前的候选测试版本。
从命名可以看出,这是 v0.40.0 大版本正式发布前的第 4 个候选版本,意味着该版本的功能已基本冻结,主要进行稳定性验证和细节打磨。对于习惯使用 Ollama 部署本地模型的开发者而言,关注 rc 系列版本有助于提前适配即将到来的正式版。
本次更新的核心改动
根据发布说明,v0.40.0-rc4 包含两项主要改动:
MLX 版本升级
本次更新的核心是 MLX 版本升级(version bump)。MLX 是 Apple 推出的机器学习框架,专为 Apple Silicon(M 系列芯片)优化,能够充分利用统一内存架构和 GPU 加速能力。Ollama 对 MLX 的持续跟进,意味着在 Mac 设备上运行本地模型的性能和兼容性有望进一步提升。
对于使用 MacBook、Mac Studio 等 Apple Silicon 设备的用户来说,MLX 后端的更新通常会带来推理速度优化或对新模型格式的支持。版本号升级往往伴随上游框架的 bug 修复和特性引入,是保持生态同步的必要维护工作。
MLX 由 Apple 于 2023 年底开源,其设计哲学借鉴了 NumPy、PyTorch 和 JAX 等主流框架,但针对 Apple Silicon 的统一内存(Unified Memory)架构做了根本性适配。传统机器学习框架需要在 CPU 内存与 GPU 显存之间频繁复制数据,而 Apple Silicon 的统一内存允许 CPU、GPU 和 Neural Engine 共享同一物理内存池,MLX 正是利用这一特性实现了零拷贝的跨处理器计算,显著降低了推理延迟。MLX 还支持懒执行(lazy evaluation)计算图,只在真正需要结果时才触发运算,进一步提升了大模型推理时的内存利用率。对 Ollama 而言,跟进 MLX 的版本迭代意味着可以及时获得上游对新型量化格式(如 4-bit、8-bit)的支持,以及对最新 M 系列芯片特性的适配。
单元测试内存优化
另一项改动是「为单元测试添加 scopes 以降低内存占用」。这是一项面向项目工程质量的改进,通过限定测试作用域(scopes),减少测试运行时的内存消耗。这类改动虽然不直接影响终端用户体验,但对项目的持续集成(CI)效率和维护成本有实际帮助,也侧面反映了项目在工程规范上的成熟度。
测试中的「scopes」概念源于编程语言中变量作用域的思想,在测试框架(如 Go 的 testing 包或 Python 的 pytest)中,scope 决定了测试夹具(fixture)的生命周期:函数级 scope 在每个测试用例结束后立即释放资源,而模块级或全局级 scope 则在整个测试套件结束后才释放。Ollama 的底层涉及大量模型权重加载与 GPU 内存分配操作,若测试夹具的生命周期管理不当,多个测试用例共用的模型上下文会在内存中长期驻留,导致 CI 环境在运行完整测试套件时出现内存溢出或测试速度骤降。通过为单元测试引入更细粒度的 scopes,每个测试用例能在执行完毕后及时释放占用的内存,使得在资源受限的 CI Runner 上也能稳定完成全量测试,降低了因内存压力导致测试失败的概率。
对开发者的实际意义
作为候选版本,v0.40.0-rc4 更适合愿意尝鲜、参与测试反馈的开发者使用。生产环境建议仍以稳定版为主,等待 v0.40.0 正式发布。
如果你是 Apple Silicon 用户,可以关注本次 MLX 升级后在本地模型推理上的表现变化。Ollama 一贯以简化本地模型部署流程著称,用户只需简单命令即可拉取并运行各类开源大模型,而底层框架的持续优化正是保证这种易用性的关键。
如何获取与反馈
该版本已在 GitHub Releases 页面提供资产(Assets)下载。开发者可通过官方仓库获取对应二进制或源码,并在测试过程中向项目提交 issue 或 PR。rc 版本的价值正在于社区的广泛验证——越多用户参与测试,正式版的稳定性就越有保障。
整体来看,v0.40.0-rc4 是一次以框架维护和工程优化为主的迭代,没有颠覆性的功能变化,但 MLX 的持续跟进对 Mac 生态用户具有积极意义。建议关注后续正式版的完整更新日志以了解全貌。
相关推荐

用 Claude AI 构建银行 KYC 文档管理模块实战
一位开发者使用 Claude AI 将银行贷款应用的 KYC 文档管理模块从模拟数据改造为真实数据库后端,涵盖两段式 Prompt 策略、文件落地与完整文档审核闭环实测,为 AI 辅助企业级开发提供参考。
为什么越来越多开发者开始反感 AI 编程?
AI 编程助手虽提升效率,但也引发开发者担忧。本文梳理反感 AI 编程的核心理由:隐性调试成本、技能侵蚀、代码质量疑问与创作乐趣流失,并探讨如何理性使用这类工具。

EmbeddingGemma 2 浏览器端图文检索:WebGPU 本地推理实践
EmbeddingGemma 2 将图像与文本映射到同一 768 维向量空间,实现图文检索。开发者借助 WebGPU 推理库 ruNNtime,让图片语义搜索完全在浏览器 GPU 本地运行,兼顾隐私与零部署成本。