Ollama v0.40.0发布:Apple Silicon默认启用MLX加速

Ollama v0.40.0 让 Apple Silicon Mac 默认通过苹果 MLX 框架运行大模型,用户无需任何配置即可获得更优推理性能。
Ollama v0.40.0(预发布)的核心变化是:在搭载 Apple Silicon 的 Mac 上,受支持的模型架构将默认通过苹果官方 MLX 框架运行,替代原有的 llama.cpp 通用后端。MLX 专为苹果统一内存架构深度优化,在推理吞吐和内存利用率上更具优势。本次更新还新增了 gemma4、qwen3.6、qwen3.5 等模型的 MLX 支持,并将 Nimble、tev1、clef、clef-flash 等决策模型也纳入其中。整个切换过程对用户完全透明,使用方式与以往相同,体现了 Ollama "开箱即用"的产品哲学。由于版本仍为预发布状态,生产环境用户建议先在测试环境中评估后再升级。
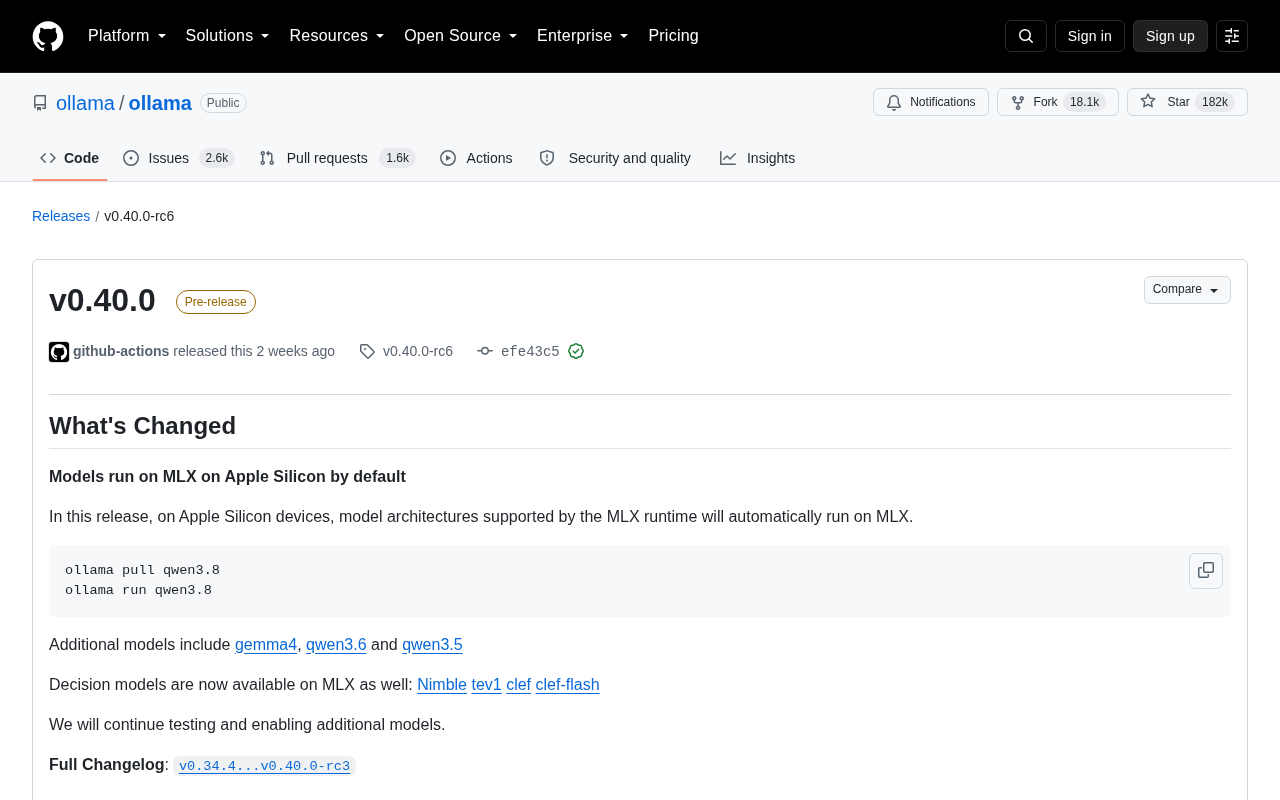
Ollama 发布了 v0.40.0 版本(当前仍处于 Pre-release 预发布阶段),本次更新最大的变化在于:在搭载 Apple Silicon 芯片的 Mac 设备上,受支持的模型架构将默认通过 MLX 运行时执行。这一改动对使用 Mac 本地部署大模型的开发者和爱好者来说,意味着更贴合苹果硬件的推理性能。
MLX 成为 Apple Silicon 的默认运行时
MLX 是苹果官方推出的机器学习框架,专为 Apple Silicon 的统一内存架构和 GPU/神经引擎做了深度优化。在以往版本中,Ollama 主要依赖 llama.cpp 系的推理后端,而 v0.40.0 让支持 MLX 的模型架构在苹果芯片上自动切换到 MLX 执行,无需用户手动配置。
对于普通用户来说,使用方式并没有变化,依旧是熟悉的命令行操作:
ollama pull qwen3.8
ollama run qwen3.8
底层运行时的切换对用户是透明的——拉取并运行模型时,Ollama 会自动判断该架构是否受 MLX 支持,若支持则默认走 MLX 路径。这种“默认即最优”的设计思路,降低了本地推理的调优门槛。
MLX 由苹果机器学习研究团队于 2023 年底开源,其核心设计理念是"统一内存优先":在 Apple Silicon 上,CPU、GPU 和神经引擎共享同一块物理内存,无需在设备间拷贝数据,这与传统 NVIDIA GPU 需要通过 PCIe 总线传输数据的模式有本质区别。对于大语言模型推理场景,这意味着模型权重可以直接在内存中被 GPU 和神经引擎访问,省去了显存与内存之间的搬运开销。相比之下,llama.cpp 虽然也支持 Metal 加速(苹果 GPU API),但属于通用跨平台实现,并未专门针对统一内存架构进行深度调优。MLX 的 API 设计借鉴了 NumPy 和 PyTorch 的风格,对熟悉 Python 机器学习生态的开发者较为友好,也方便模型开发者直接适配。
新增模型支持范围
根据官方 Release Notes,本次除了核心的 MLX 默认化之外,还扩充了可在 MLX 上运行的模型清单。文中提及的模型包括 gemma4、qwen3.6 和 qwen3.5 等。
此外,官方还将一批被称为“Decision models(决策模型)”的模型纳入 MLX 支持,具体包括:
- Nimble
- tev1
- clef
- clef-flash
官方同时表示,将持续测试并逐步开放更多模型架构在 MLX 上的支持。这意味着当前的支持列表只是一个起点,后续版本大概率会覆盖更广的模型生态。
"Decision models(决策模型)"是一类专为结构化决策、推理链规划或工具调用场景优化的轻量级模型,区别于通用对话大模型,它们通常参数量更小、延迟更低,适合在边缘端或本地环境中频繁调用。Nimble、clef、clef-flash 等名称目前在主流公开模型社区中知名度有限,可能属于 Ollama 与特定合作方联合测试或内部命名的实验性模型,官方将其纳入 MLX 支持清单,也体现了对本地 Agent 工作流和工具调用场景的提前布局。
对本地部署用户意味着什么
这次更新的实际价值,主要体现在 Mac 用户的本地推理体验上。MLX 针对苹果芯片的统一内存做了专门优化,在内存占用和推理吞吐方面相比通用后端往往更有优势,尤其在运行较大参数量模型时,能更充分地利用 M 系列芯片的算力。
Ollama 作为目前最流行的本地大模型运行工具之一(GitHub 上已拥有超过 18 万 Star),其对 MLX 的原生支持,进一步巩固了 Mac 作为本地 AI 开发平台的地位。对于习惯在 MacBook 上做模型实验、原型开发的用户,升级到 v0.40.0 后几乎可以“零成本”获得性能收益。
需要留意的是,v0.40.0 目前标记为 Pre-release(预发布版本),功能和稳定性仍在持续验证中。生产环境或对稳定性有较高要求的用户,建议先在测试环境中评估,再决定是否升级。
小结
Ollama v0.40.0 的核心是让 MLX 在 Apple Silicon 上成为默认运行时,并扩充了 MLX 支持的模型范围。它延续了 Ollama 一贯“开箱即用”的产品哲学——用户无需关心底层运行时,就能在 Mac 上获得更贴近硬件的推理性能。随着官方后续逐步开放更多模型支持,MLX 与 Ollama 的结合值得持续关注。
相关推荐

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
LLM应用越改越糟?三步构建有效评估体系
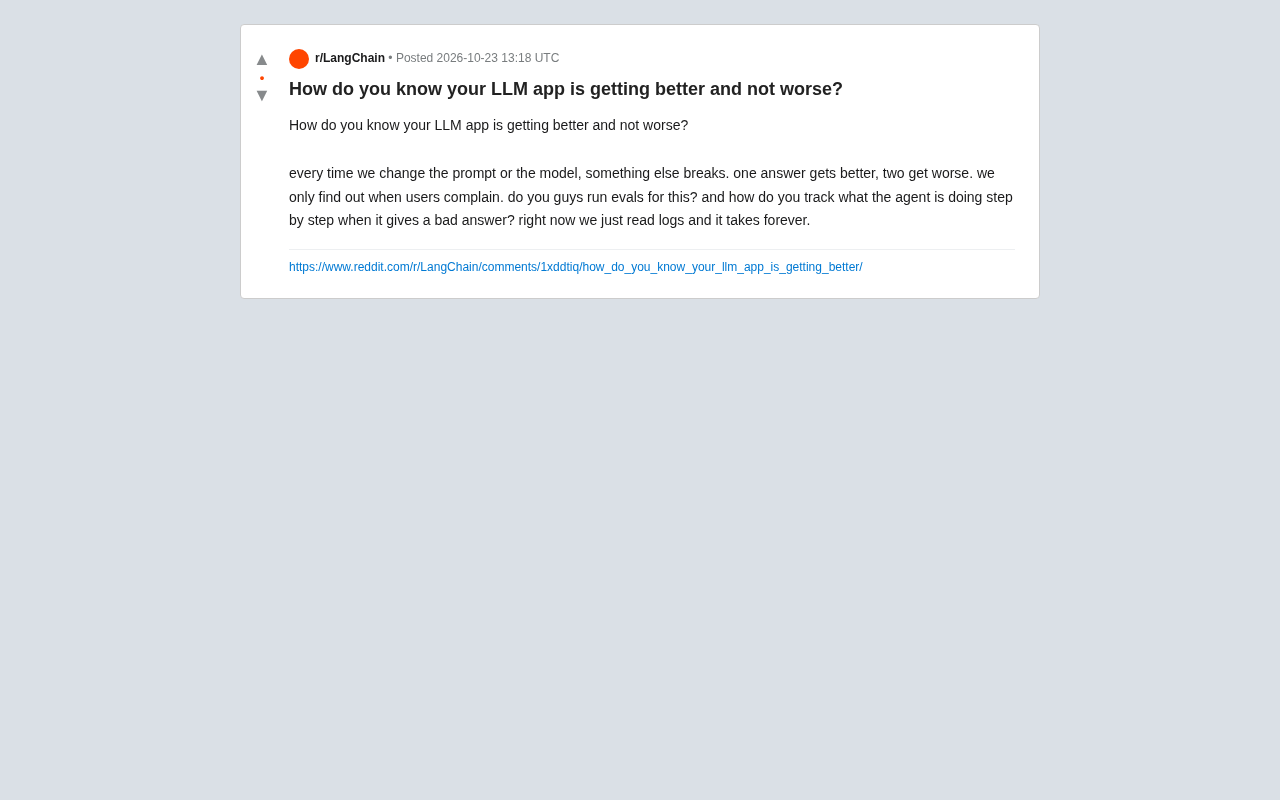
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。
瑞典政府封杀ChatGPT与Claude:AI工具治理的转折点
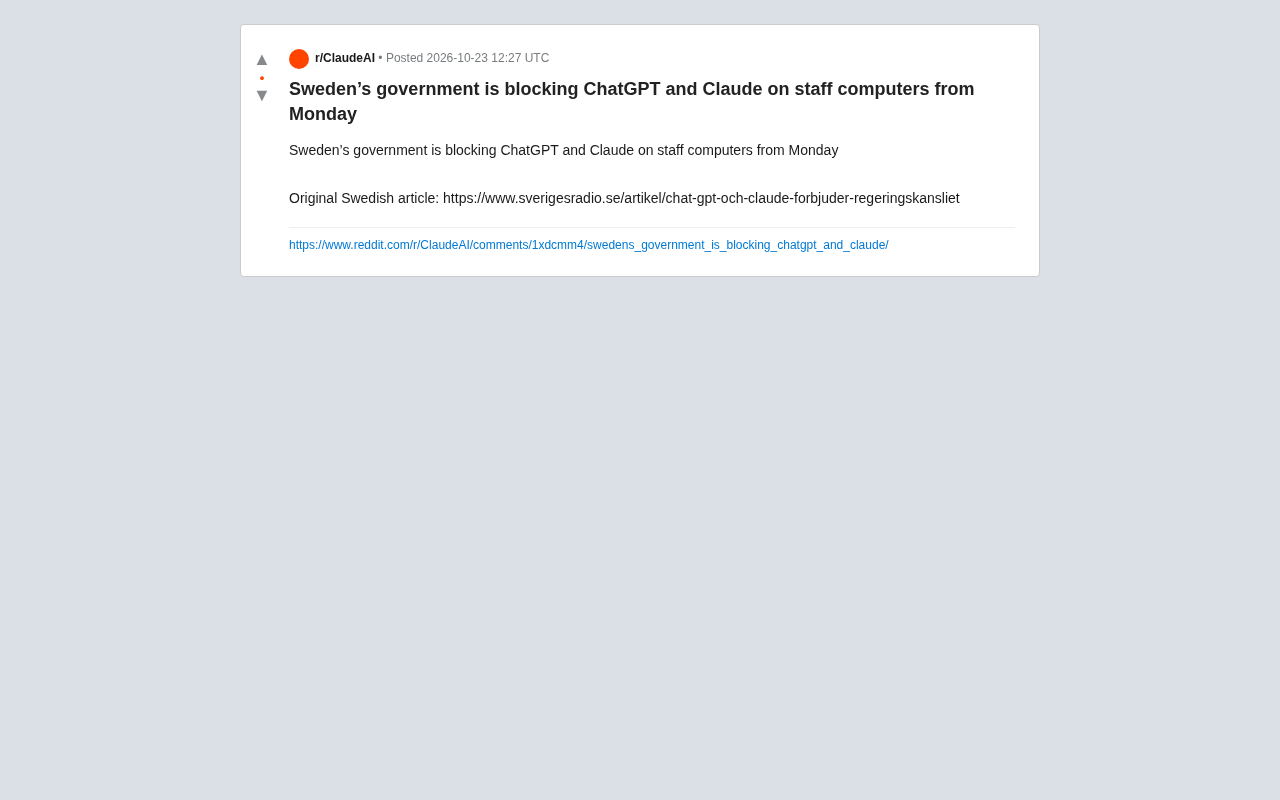
瑞典政府宣布禁止在员工电脑上使用ChatGPT和Claude,出于信息安全考虑。本文分析禁令细节、数据主权焦虑及对AI行业的影响。