Ollama v0.40.10 更新 Gemma 渲染器,支持投机解码
Ollama v0.40.10 新增 Gemma 4 渲染器并为 MLX 后端接入投机解码,属低风险维护更新。
Ollama 发布 v0.40.10(提交 f52b9e7),是一次围绕 Gemma 模型家族的底层维护更新,包含两处改动。其一,renderers 模块新增 gemma4-nemotron 渲染器,将助手内容渲染在工具调用之前,以匹配 Nemotron 等微调模型训练时的上下文布局,并附带 chat template 作为 Jinja parity 检查的测试夹具。其二,MLX 后端支持以 DFlash 为草稿模型、Gemma 4 为目标模型的投机解码,同时暴露 hidden-state taps 与原始 logits,并解耦 safetensors 目标精度与量化草稿权重的上报。gemma4 自动检测逻辑未变,现有用户升级后行为不变,属低风险更新;投机解码的实际加速幅度需在自身负载上实测。
一次小而关键的版本迭代
Ollama 发布了 v0.40.10 版本,提交号为 f52b9e7,由开发者 dhiltgen 于 10 月 23 日打上标签。从提交信息看,这并非一次大功能发布,而是围绕 Gemma 模型家族的两处底层改进:新增一个渲染器变体,以及在 MLX 后端上打通 Gemma 4 与 DFlash 投机解码的配合。对于跑本地大模型的用户来说,这类更新往往不显眼,却直接影响输出格式正确性和推理速度。
新增 gemma4-nemotron 渲染器
本次提交的第一个改动是在 renderers 模块中新增 gemma4-nemotron 渲染器。它的核心差异在于消息渲染顺序:助手内容会被放在工具调用之前,而不是放在工具响应之后。
这听起来只是排版问题,但对结构化工具调用的模型来说,顺序决定了模型看到的上下文形态。部分基于 Gemma 4 微调的模型(如 Nemotron 系列)在训练时就采用这种前置布局,若用默认渲染器套用,可能出现工具调用格式错位、解析失败等情况。模型可以通过 RENDERER gemma4-nemotron 显式选用该渲染器,而 gemma4 的自动检测逻辑保持不变,因此现有用户不会受到行为变化的影响。
提交同时附带了一份对应的 chat template,作为 Jinja parity 检查的测试夹具。这意味着渲染器的输出会与模板渲染结果做一致性校验,降低模板与实际推理行为脱节的风险。
聊天模板(chat template) 是推理框架把多轮对话、系统提示和工具调用序列转换成模型输入 token 的规则层,通常以 Jinja2 模板形式随模型权重一起分发。不同模型家族对角色标记、特殊 token 和工具调用块的排布有各自约定,模板必须与训练时的格式严格一致,否则模型会看到分布外的输入,表现为工具调用解析失败、角色混淆或输出截断。Jinja parity 检查 即用同一份模板分别渲染参考实现与框架内渲染器,逐字节比对输出,确保二者等价。Ollama 为每个渲染器附带测试夹具,正是把这种一致性校验纳入 CI,避免渲染器与模板在后续改动中悄然漂移。
MLX 后端支持 Gemma 4 投机解码
第二个改动落在 MLX 后端:支持以 DFlash 草稿模型为 Gemma 4 目标模型做投机解码。
投机解码的思路是用一个小而快的草稿模型先猜出若干 token,再由目标模型一次性验证,从而减少大模型的串行前向次数。DFlash 是这套机制中的草稿模型类型。本次改动做了几件事:当草稿模型的配置需要独立的输出头时,加载草稿自有的输出头,同时保留现有 DFlash 模型所用的目标头路径,避免破坏已有模型;为投机解码暴露 Gemma 4 的 hidden-state taps 和原始 logits;并让 safetensors 目标精度的上报与量化后的草稿权重相互独立。
最后一点容易被忽略。草稿模型常被量化以节省显存,但目标模型的精度信息若被草稿的量化状态污染,用户就难以判断实际推理精度。把两者解耦,能让精度报告更可信。
投机解码(Speculative Decoding) 是一种在保持输出分布不变的前提下加速自回归生成的技术。其基本流程是:先用一个参数量小、速度快的草稿模型(draft model)自回归地生成 k 个候选 token,再把这些候选连同原始上下文一次性送入目标大模型做并行前向,由目标模型对每个位置给出概率并逐一接受或拒绝。被接受的 token 直接保留,遇到第一个拒绝位置即从该处重新采样,并从拒绝点继续下一轮。由于目标模型只需一次前向就能验证多个 token,串行步数显著减少。加速比取决于草稿命中率:草稿与目标分布越接近、任务越规整(如代码补全、摘要),接受率越高,通常可获得 1.5–3 倍加速;反之若频繁拒绝,额外开销可能抵消收益。草稿模型常被量化以降低显存占用,这也是文中强调精度上报需与草稿量化状态解耦的原因。
对本地部署用户意味着什么
如果你在 Ollama 上跑 Gemma 4 系列模型,这次更新的价值主要体现在两方面。使用 Nemotron 风格微调模型的用户,可以用新渲染器获得与训练时一致的工具调用布局,减少格式类报错;在 Apple Silicon 上通过 MLX 后端推理的用户,则有机会借助 DFlash 草稿模型加速 Gemma 4 的生成。
需要说明的是,自动检测逻辑未变,普通 gemma4 用户升级后行为不变,属于低风险更新。投机解码的实际加速幅度取决于草稿模型与目标模型的匹配度以及任务类型,提交本身并未给出基准数据,建议在自身负载上实测后再决定是否启用。
小结
v0.40.10 是一个典型的维护型版本:一个渲染器补齐了特定微调模型的格式兼容性,一组 MLX 改动让 Gemma 4 接入已有的投机解码链路。两处改动都不改变默认行为,却扩展了 Ollama 对 Gemma 生态的支持边界。对关注本地推理工具链的开发者,这类提交比版本号更值得读一读。
相关推荐
达芬奇如何证明太阳是热的?一段被忽视的科学史
达芬奇如何用凹面镜实验推翻亚里士多德的冷太阳理论?本文梳理这段被忽视的科学史,揭示科学思维在十五世纪的萌芽,以及达芬奇对太阳发热和生命本质的冷峻观察。
SharpLogic:用k-CNF为LangGraph路由图做形式化查错
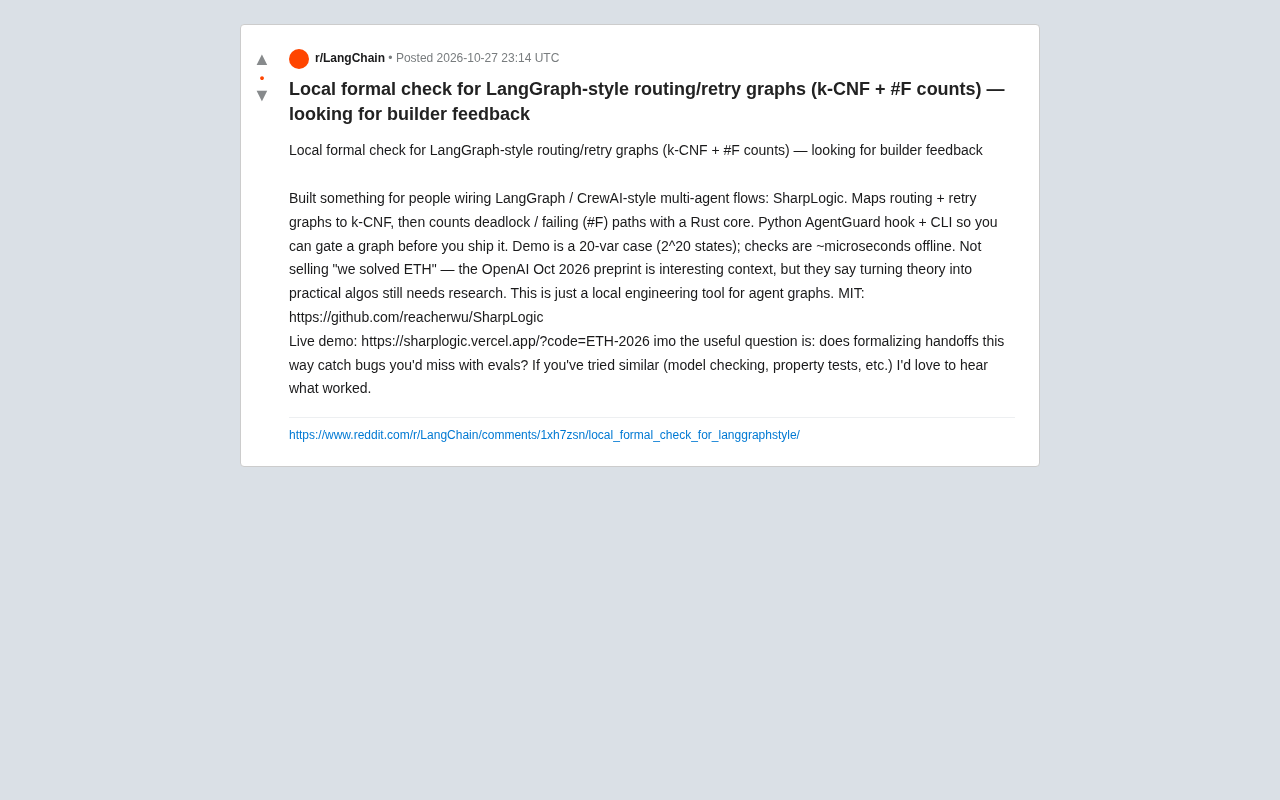
SharpLogic开源项目将LangGraph风格的多智能体路由与重试图映射为k-CNF,用Rust内核统计死锁与失败路径(#F计数),提供Python AgentGuard钩子与CLI,在发布前做形式化门禁检查。本文分析其原理、与评测的互补关系及社区关注的建模成本问题。
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
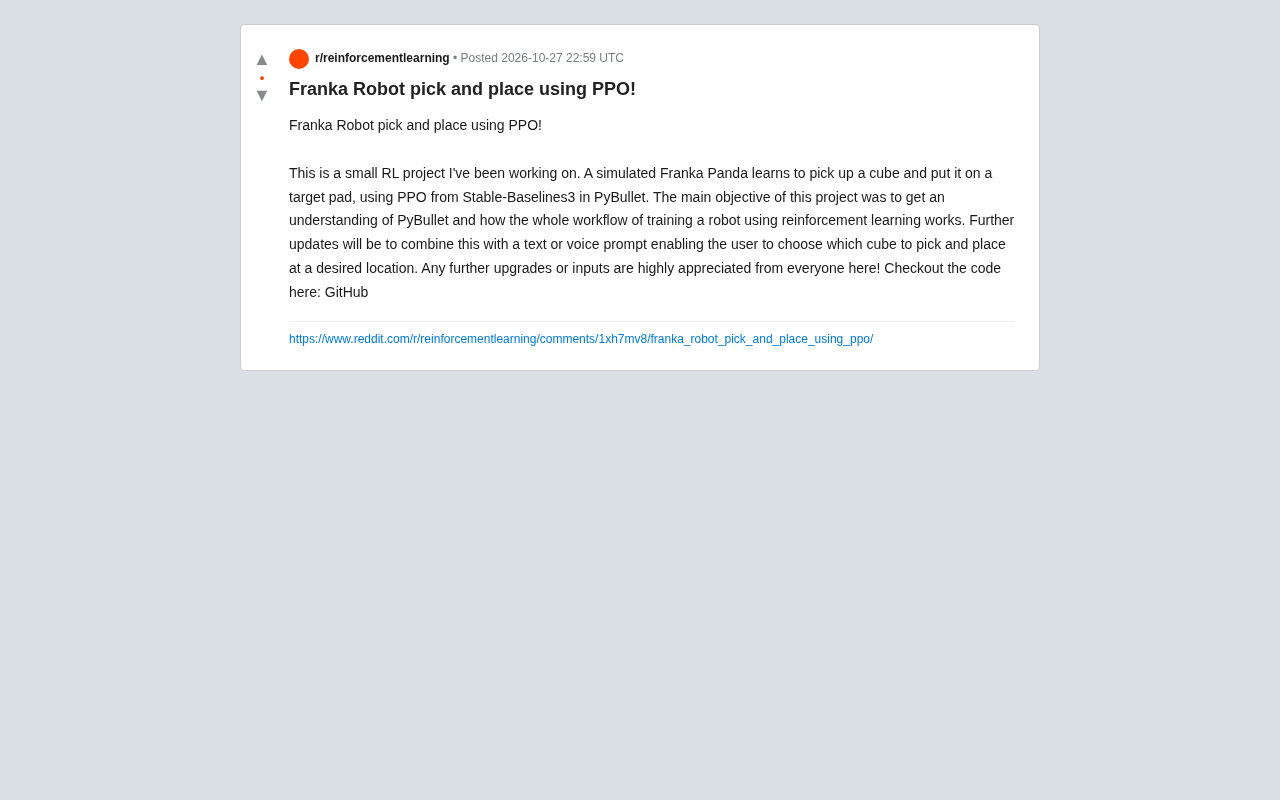
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。