Ollama v0.40.4-rc0 发布:MLX 版本升级意味着什么
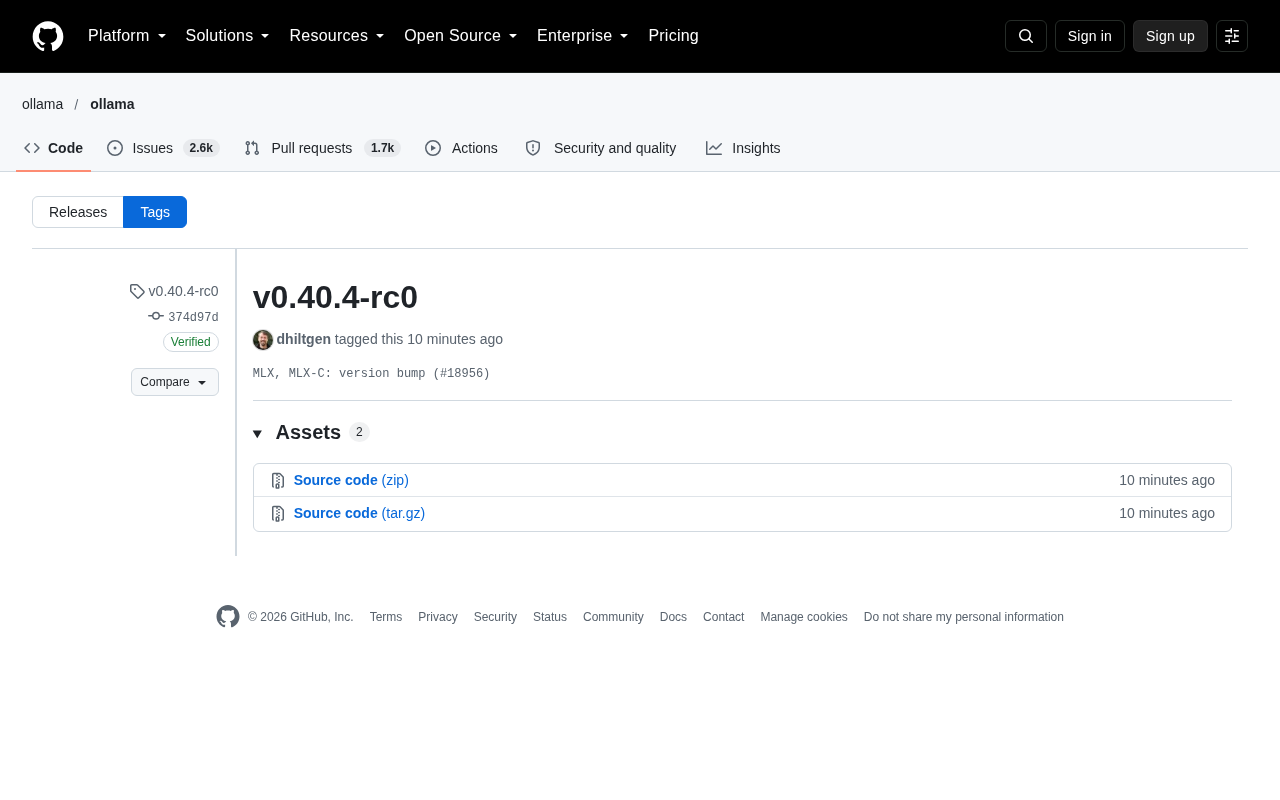
Ollama v0.40.4-rc0 虽仅升级 MLX,却关系 Mac 本地推理性能与兼容性。
Ollama 发布 v0.40.4-rc0 预发布版本,表面只是版本号 patch 位跳动,核心变更仅为 MLX 和 MLX-C 的版本升级,没有新功能或破坏性改动。但 MLX 是 Apple 为 M 系列芯片打造、针对统一内存架构优化的机器学习框架,是 Ollama 在 macOS 上推理的关键后端;MLX-C 则是其 C 语言绑定,连接 Go 主体与底层计算。因此这次升级直接影响 Mac 用户的推理性能、内存占用与模型兼容性,实际影响可能远大于版本号所示。RC 后缀意味着需真实环境验证,不同代 Apple 芯片表现可能有差异。文章建议生产环境暂不升级 RC,但 Mac 用户可关注其对推理异常的修复,团队宜等正式版。
Ollama 发布了 v0.40.4-rc0 预发布版本,这次更新看起来只是一个小版本号跳动,但背后的信号值得关注。
一次"低调"的版本更新
从 GitHub 上的发布记录来看,v0.40.4-rc0 对应的提交是 374d97d,由开发者 dhiltgen 打上标签。整个发布的变更内容可以用一句话概括:MLX 和 MLX-C 的版本升级(PR #18956)。
没有新功能,没有 API 变更,没有破坏性改动。从表面上看,这更像是例行维护。
但如果你了解 Ollama 在 Apple Silicon 上的技术路线,就会知道 MLX 的版本升级绝不是无关紧要的小事。
MLX 为什么对 Ollama 这么重要
MLX 是 Apple 为自家芯片(M 系列)打造的机器学习框架,专门针对统一内存架构做了优化。Ollama 在 macOS 上运行本地大模型时,MLX 是关键的推理后端之一。
MLX-C 则是 MLX 的 C 语言绑定层,Ollama 的核心是用 Go 写的,但推理部分需要调用底层的高性能计算库。MLX-C 就是这个桥梁。
换句话说,MLX 和 MLX-C 的版本升级,直接影响 Ollama 在 Mac 上的推理性能、内存占用和模型兼容性。对于大量在 MacBook 上跑本地模型的用户来说,这个改动的实际体感可能比版本号看起来要大得多。
统一内存架构(Unified Memory Architecture) 是 Apple Silicon 的一项根本性设计:CPU、GPU 和神经引擎共享同一块物理内存池,而非像传统 PC 那样在 CPU 内存与独立显存之间搬运数据。这对本地大模型推理意义重大——模型权重加载后无需在设备间反复拷贝,避免了 PCIe 传输瓶颈,也让可用"显存"不再受独立显卡容量限制。MLX 正是围绕这一特性设计的框架,它采用惰性计算与统一内存寻址,让算子调度能同时利用 CPU 和 GPU 而无需显式数据搬移。这也是为什么 Ollama 在 Mac 上能以相对有限的统一内存运行较大规模模型,而同样的内存在独显平台上往往捉襟见肘。理解这一点,才能明白 MLX 版本升级为何会直接牵动推理性能与内存占用。
MLX-C 是 MLX 的 C 语言接口层,它的存在解决的是跨语言调用问题。Ollama 主体使用 Go 编写,负责模型管理、HTTP 服务、调度等上层逻辑,但高性能张量计算必须依赖底层库。Go 通过 cgo 机制调用 C 接口,因此 MLX 需要先暴露一套稳定的 C API,再由 Ollama 的 Go 代码绑定调用。这层间接性带来两个后果:一是 MLX-C 的接口若发生变更,Ollama 侧的绑定代码必须同步适配,否则可能编译失败或行为异常;二是 C 接口层的抽象可能屏蔽部分 MLX 新特性,导致底层能力无法立即被上层利用。因此每次 MLX 与 MLX-C 同步升级,实际上是一次跨越 Python、C、Go 三层的联动,其验证复杂度远高于单纯的版本号变化。
预发布版本的信号
-rc0 后缀说明这是第一个候选发布版本。Ollama 团队选择先放出 RC 版本,通常意味着改动需要更多真实环境验证——尤其是涉及底层计算库升级时,不同型号的 Apple 芯片(M1/M2/M3/M4)可能表现出不同的兼容性。
从工程实践角度看,这种谨慎是合理的。MLX 本身的迭代速度很快,每次版本跳跃都可能引入 API 变化或数值精度的微调,这些在 CI 环境中很难完全覆盖。
数值精度是底层计算库升级中最容易被忽视却影响直接的问题。大模型推理涉及大量浮点运算,MLX 在不同版本间可能调整算子实现、累加顺序或采用不同的低精度格式(如 bf16、fp16 的舍入策略)。这些改动在数学上等价,但在有限精度下会产生微小差异,经过数十层网络累积后可能表现为输出文本的措辞变化、重复或乱码。这也是为什么底层库升级必须经过真实环境的长文本、多模型验证,仅靠单元测试和短 prompt 的 CI 难以覆盖。M1 到 M4 各代芯片在矩阵单元、内存带宽和指令集上存在差异,同一份 MLX 代码在不同芯片上触发的算子路径可能不同,进一步放大了回归风险。
用户现在应该做什么
如果你在用 Ollama 跑本地模型,尤其是 Mac 用户,有几点值得注意:
- 生产环境不建议立刻升级 RC 版本。预发布版本的价值在于帮开发者发现问题,而不是追求稳定。
- 关注 MLX 版本号的变化。如果你之前遇到过某些模型在 Mac 上推理异常、输出乱码或性能波动,新版本可能修复了这些问题。
- Apple Silicon 各代芯片表现可能有差异。M4 系列和早期 M1 在 MLX 上的优化路径不完全相同,升级后值得留意实际推理速度的变化。
对于使用 Ollama 作为开发工具或 AI 应用基础设施的团队,可以等正式版发布后再跟进。但如果你的项目对 Mac 本地推理性能敏感,提前在测试环境验证 RC 版本是值得的。
小结
v0.40.4-rc0 是一个典型的"小版本、大依赖"更新。版本号只跳了 patch 位,但 MLX 的升级对 Apple Silicon 用户的实际体验影响可能不小。Ollama 在本地推理这条路上持续打磨 Mac 端的性能,这个方向本身就说明了 Apple 芯片在本地 AI 推理场景中的重要性。
相关推荐

FlexBudget:在统一算力预算下公平比较KV缓存淘汰策略
AMD工程师在PyTorch Conference提出FlexBudget,通过固定kernel和显存预算、只替换KV缓存淘汰规则,实现training-free的公平方法比较,全部基于核心PyTorch实现。

Anthropic 2万亿估值拆解:AI上市潮为何接连折戟
Anthropic寻求2万亿美元估值,相当于史上最大十起科技IPO估值总和。但利率飙升、IPO撤回、TAM通胀、循环融资闭环正在动摇AI上市潮的定价基础。本文拆解2万亿估值背后的逻辑漏洞,以及英伟达为何反而便宜。
Anthropic IPO倒计时:2万亿美元估值背后的算力账本
Anthropic IPO进入倒计时,目标估值最高2万亿美元,较半年前H轮融资翻倍。本文梳理从秘密交表到投资者日的完整时间线,分析2万亿估值背后的算力成本逻辑,以及投资者日真正要回答的核心问题。