Ollama v0.40.4 预发布:llama.cpp 升级与 MLX 优化

Ollama v0.40.4 预发布:升级 llama.cpp 支持 EmbeddingGemma 2,优化服务端与 MLX。
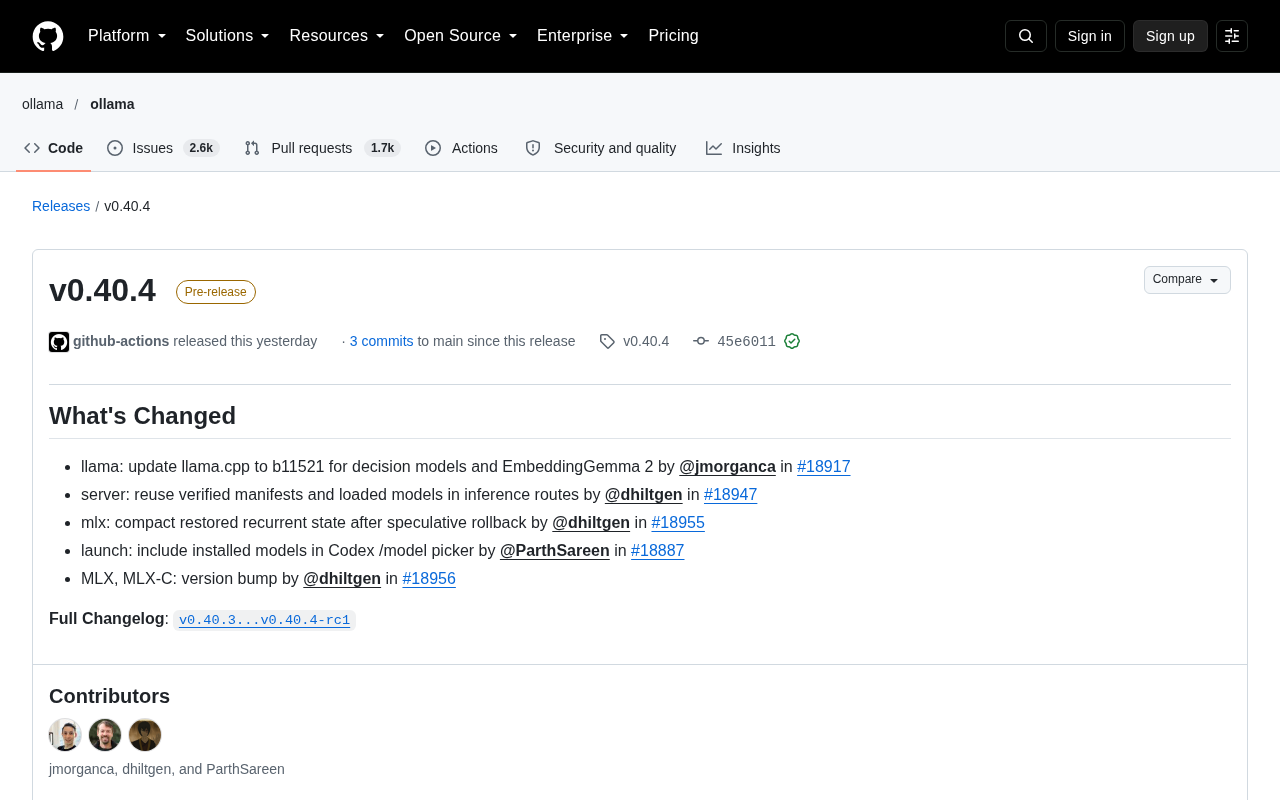
Ollama 发布 v0.40.4 预发布版本,虽仅含 3 个提交、涉及 4 位贡献者,但改动方向明确。核心是将底层推理引擎 llama.cpp 升级至 b11521,新增对决策模型和 EmbeddingGemma 2 嵌入模型的支持,后者对 RAG 与语义搜索开发者尤为重要。服务端由 dhiltgen 优化推理路由,复用已验证的 manifest 与已加载模型,减少多请求场景下的重复加载开销。Apple Silicon 方面有三项 MLX 相关改进,包括投机解码回滚后的状态压缩与 MLX/MLX-C 版本同步。此外,Codex 的 /model 选择器开始纳入本地已安装模型,改善工具链衔接。整体体现 Ollama 在多平台支持与推理效率上的持续投入。
Ollama 发布了 v0.40.4 预发布版本,这次更新虽然提交数量不多,但涉及推理引擎升级、服务端路由优化以及 Apple Silicon 平台上的 MLX 状态管理改进。对于依赖 Ollama 本地部署模型的开发者来说,这些改动值得关注。
核心更新:llama.cpp 与 EmbeddingGemma 2 支持
本次更新中最关键的改动是将 llama.cpp 升级至 b11521 版本,由 jmorganca 提交。这一升级主要面向决策模型(decision models)和 EmbeddingGemma 2 的支持。
llama.cpp 作为 Ollama 底层推理引擎的核心组件,其版本迭代直接影响模型加载效率和推理表现。将底层引擎推进到较新的构建版本,意味着 Ollama 能够兼容更多新发布或即将发布的模型架构,EmbeddingGemma 2 的加入尤其值得注意——嵌入模型在 RAG(检索增强生成)和语义搜索场景中扮演着基础性角色,Ollama 对这类模型的支持完善程度会直接影响下游应用的开发体验。
llama.cpp 是一个用 C/C++ 编写的大语言模型推理框架,由 Georgi Gerganov 发起,核心目标是让 LLM 能在消费级硬件(笔记本、桌面机、树莓派等)上高效运行,而不依赖昂贵的 GPU 集群。它通过 GGUF 量化格式、针对不同 CPU 指令集(AVX、NEON 等)的优化内核以及 Metal、CUDA 等后端来实现跨平台加速。Ollama 本身并不从零构建推理能力,而是以 llama.cpp 作为底层引擎,因此其版本号(如 b11521 中的 b 代表 build)会直接影响 Ollama 支持的模型架构、量化类型和推理性能。社区常以 llama.cpp 的构建号作为“能跑哪些新模型”的事实标准。
EmbeddingGemma 2 属于 Google Gemma 系列的文本嵌入模型,专门用于把文本映射成稠密向量,而非生成式对话。EmbeddingGemma 主打小体积、多语言和端侧部署,适合在本地生成语义向量。它与生成式模型的关键区别在于输出是固定维度的向量而非 token 序列,因此在 RAG、语义检索、聚类、去重等任务中充当“索引层”。Ollama 支持这类模型,意味着开发者可以在同一套本地工具链里完成“向量化 + 生成”两步,无需再额外部署独立的 embedding 服务。
服务端优化:复用已验证清单与已加载模型
dhiltgen 提交的 server 端改动聚焦于推理路由的性能优化——复用已验证的 manifest 和已加载的模型。
这个改动解决的是一个实际问题:在多请求场景下,如果每次推理请求都重新验证模型清单或重新加载模型,会带来不必要的延迟和资源消耗。通过缓存和复用机制,Ollama 在连续推理请求中能够更快地响应,这对生产环境中高频调用的场景尤为重要。模型加载往往是本地推理流程中最耗时的环节之一,减少重复加载可以直接改善用户的等待体验。
manifest 在 Ollama 中指的是描述一个模型的文件清单,包含模型各层、权重摘要(digest)、量化格式、模板和参数等元数据,通常以 JSON 形式存储并由内容哈希寻址。每次加载模型前,Ollama 需要校验 manifest 是否完整、对应 blob 是否已存在于本地缓存中,这一过程涉及文件读取与哈希比对。
在高并发或连续请求场景下,如果每个请求都重新走一遍“读取 manifest → 校验 digest → 加载权重”的流程,累积的 I/O 与解析开销会非常可观。dhiltgen 的改动让服务端缓存已验证的 manifest 和已经驻留内存的模型实例,后续请求可直接复用。这是典型的推理服务优化思路:把“启动成本”从每次请求摊薄到进程生命周期内。其代价是需要更细致的内存管理策略,比如在显存/内存压力下决定何时卸载闲置模型,否则可能因长期驻留而占满资源。
MLX 相关改进:Apple Silicon 平台的持续打磨
本次更新包含三项与 MLX 直接相关的改动,显示 Ollama 在 Apple Silicon 平台上的持续投入。
推测回滚后的状态压缩(dhiltgen 提交):在投机解码(speculative decoding)发生回滚后,对恢复的循环状态进行压缩处理。投机解码是一种加速推理的技术,通过小模型快速生成草稿再由大模型验证,但验证失败时需要回滚状态。这个改动让回滚后的状态管理更加紧凑,有助于减少内存占用。
MLX / MLX-C 版本升级(dhiltgen 提交):同步推进 MLX 和 MLX-C 的依赖版本,确保底层框架与上层实现保持一致。
这两项改动虽然技术细节较深,但共同指向一个方向——让 Ollama 在 Mac 设备上的推理更稳定、更高效。
MLX 是 Apple 机器学习研究团队推出的开源数组计算与深度学习框架,专为 Apple Silicon 的统一内存架构设计,并提供 Python、C++(MLX-C)及 Swift 接口。与 CUDA 生态不同,MLX 采用惰性计算图和统一内存模型,CPU 与 GPU 可共享同一块内存,避免数据在设备间反复拷贝,因此在 Mac 本地推理时能获得更好的能效与延迟表现。
投机解码(speculative decoding) 是一种在不改变输出分布的前提下加速生成的技术:先由一个小而快的“草稿模型”一次性生成若干候选 token,再由目标大模型一次性并行验证。若全部通过,则相当于用一次大模型前向替代多次;若在某个位置被拒绝,则需要丢弃已接受的后续 token 并把状态回滚到拒绝点之前。回滚涉及 KV Cache、循环状态等缓存的截断与重建,若处理不当会造成内存碎片或占用膨胀。Ollama 此次针对回滚后状态做压缩,正是为了降低这条加速路径的额外开销。
启动体验:Codex 模型选择器集成
ParthSareen 提交的 launch 改动将已安装模型纳入 Codex 的 /model 选择器中。这是一个面向开发者体验的改进,让用户在 Codex 环境下能够直接看到本地已安装的 Ollama 模型,无需额外配置即可切换使用。
这个改动虽小,但降低了工具链之间的摩擦。对于同时使用 Ollama 和 Codex 的开发者来说,模型发现和选择的流程变得更加顺畅。
Codex 在此处指的是 OpenAI 推出的编码代理/命令行工具(Codex CLI),它支持连接不同的模型后端来执行代码生成、编辑和终端任务。其 /model 是交互式会话中的斜杠命令,用于列出并切换当前可用的模型。
Ollama 与 Codex 的集成意义在于打通“本地模型”与“编码代理”两条工具链。此前用户若想在 Codex 中使用 Ollama 拉取的本地模型,往往需要手动配置 base URL、模型名等参数;本次改动把已安装的 Ollama 模型直接暴露在 /model 选择器中,相当于让 Codex 自动发现本地模型清单。对开发者而言,这降低了在隐私敏感或离线场景下使用编码代理的门槛——代码不必离开本机,同时仍能享受代理式的自动化编辑体验。这也反映出 Ollama 正从单纯的“模型运行器”向“本地 AI 工具链中枢”延伸。
版本迭代节奏观察
从 v0.40.3 到 v0.40.4,三个提交、四位贡献者,这个预发布版本的改动相对克制。但细看之下,每个改动都有明确的指向:底层引擎跟进、服务端性能优化、平台特定改进、开发工具集成。
Ollama 作为本地大模型运行工具,其更新节奏反映了团队在多平台支持(尤其是 Apple Silicon 的 MLX 路径)和推理效率上的持续投入。这次 EmbeddingGemma 2 的支持值得做 RAG 应用的开发者留意,而服务端的 manifest 复用优化则可能在长时间运行的服务中体现出价值。
预发布版本通常意味着正式版即将跟进,关注 Ollama 的开发者可以留意后续正式版本的发布。
相关推荐

JobRunner MCP服务器:AI智能体可修复失败的Java任务
JobRunner 推出开源 MCP 服务器,让 AI 智能体直接查看集群状态、诊断失败原因并恢复 Java 任务,运维人员可在云编码环境或已有智能体中完成故障响应。

MLAI Digital推出9大安全智能体:MCP服务器守护Agentic AI全生命周期
MLAI Digital推出Security MCP Server,内置九个专业安全智能体,覆盖漏洞发现、攻击模拟、Prompt注入检测、API与基础设施评估及修复加速,将安全验证嵌入Agentic AI开发到生产的完整生命周期。

H100 GPU运行Isaac Lab:更优方案探讨
探讨在NVIDIA H100 GPU上运行Isaac Lab的优化方法,包括MIG配置、混合精度、TensorRT加速及社区经验,帮助提升机器人仿真与强化学习效率。