Ollama 新增三款模型适配 /v1/systemone 接口
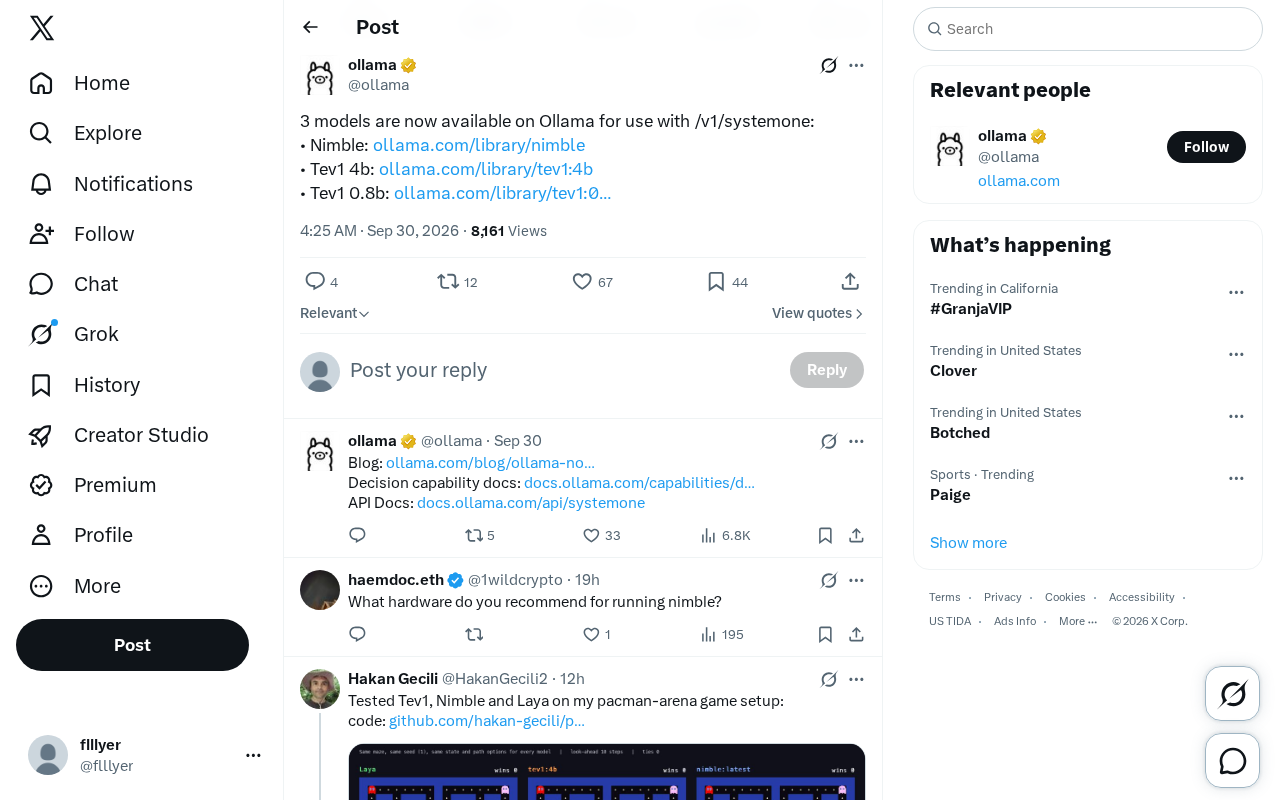
Ollama 新增 Nimble、Tev1 4b、Tev1 0.8b 三款本地可运行模型,统一通过 /v1/systemone 接口调用。
本地大模型运行工具 Ollama 宣布上线三款新模型:轻量敏捷的 Nimble、约 40 亿参数的 Tev1 4b,以及约 8 亿参数的 Tev1 0.8b。三款模型均通过 `/v1/systemone` 接口提供服务,开发者无需修改现有工作流即可切换尝试。Tev1 系列的两档参数规模覆盖了从配置较强的本地工作站到资源受限的笔记本乃至边缘设备的多种场景。此次更新的核心价值在于:为开发者提供更多可在本地免费、私密运行的模型选项,同时通过统一接口降低切换成本。目前官方公告较为简略,训练数据、基准表现及许可协议等细节尚待披露。
Ollama 平台新增三款可用模型
本地大模型运行工具 Ollama 近期宣布,有三款新模型已登陆平台,可通过 /v1/systemone 接口调用。这一更新为希望在本地部署和测试不同规模模型的开发者提供了更多选择。
根据官方发布的信息,本次上线的三款模型分别为:
- Nimble:定位轻量、快速响应的模型
- Tev1 4b:参数规模约 40 亿的中型模型
- Tev1 0.8b:参数规模约 8 亿的小型模型
从命名可以看出,Tev1 系列提供了两种不同参数量级的版本,方便开发者根据硬件条件和性能需求做出权衡。
三款模型的定位差异
Nimble:主打敏捷响应
从名称 "Nimble"(敏捷)来看,这款模型的设计重点在于低延迟和快速推理。这类模型通常适合对响应速度敏感、但对复杂推理要求不高的场景,比如交互式对话、实时辅助等。
在大模型领域,"轻量快速"通常通过几种技术路径实现:减少参数总量、采用量化压缩(将模型权重从 float16 压缩为 int8 甚至 int4)、或针对推理路径做剪枝优化。以参数量衡量,Nimble 的具体规模尚未披露,但从命名定位推测,其优先级是首字节响应时间(Time to First Token)而非复杂任务的推理深度。这类模型在实际部署中常被用作"前置路由层"——先快速响应用户,再视需要调用更大模型处理复杂请求,从而在用户体验和算力消耗之间取得动态平衡。
Tev1 4b 与 Tev1 0.8b:覆盖不同算力需求
Tev1 系列的两个版本形成了明显的梯度:
- Tev1 4b(约 40 亿参数)在能力和资源占用之间取得平衡,适合有一定 GPU 或较强 CPU 资源的本地环境。
- Tev1 0.8b(约 8 亿参数)体积更小,内存占用低,适合在资源受限的设备上运行,例如笔记本甚至边缘设备。
这种分层设计是当前开源模型生态的常见做法——用同一系列、不同参数量的模型满足从个人实验到轻量生产的多样化需求。
/v1/systemone 接口的意义
此次三款模型均面向 /v1/systemone 接口提供服务。接口化的调用方式意味着开发者可以用统一的方法接入不同模型,降低切换成本。对于已经在使用 Ollama 的用户而言,这类更新可以直接在现有工作流中尝试新模型,无需大幅改动代码。
Ollama 一直以"在本地便捷运行大模型"为核心卖点,持续扩充模型库是其保持竞争力的关键。每新增一批模型,都为本地推理用户提供了更多可对比、可组合的选项。
Ollama 的接口设计与 OpenAI 的 /v1/chat/completions 规范高度兼容,这是本地大模型工具链的一种主流策略。兼容统一接口意味着开发者可以用相同的客户端代码(如 LangChain、LlamaIndex 或自定义脚本)在不修改业务逻辑的前提下,随时切换底层模型。/v1/systemone 作为专属端点,可能针对系统级调用场景做了特定优化,但目前官方尚未公布该端点与标准聊天接口在行为上的具体差异。开发者在集成时建议参考 Ollama 官方 API 文档,确认请求格式与参数字段是否与现有工作流完全兼容。
对开发者的实际价值
对于关注本地部署的开发者和爱好者,这次更新带来几点现实好处:
- 更多选择:从 Nimble 到 Tev1 系列,覆盖了不同的速度与规模偏好。
- 易于试用:通过 Ollama 拉取即可本地运行,无需依赖云端 API。
- 成本可控:本地运行避免了按调用计费,适合反复实验与隐私敏感场景。
需要说明的是,官方公告信息较为简略,关于这三款模型的具体训练数据、基准测试表现、许可协议等细节尚未在原始内容中披露。建议有意使用者通过 Ollama 官方模型页面获取完整的参数说明和使用文档,再根据自身场景做评估。
小结
Ollama 新增的 Nimble、Tev1 4b、Tev1 0.8b 三款模型,进一步丰富了本地大模型的可选项,并统一通过 /v1/systemone 接口提供。虽然目前公开细节有限,但这类持续更新体现了本地 AI 工具生态的活跃度。想第一时间体验的开发者,可前往 Ollama 平台查看对应模型的详细信息。
相关推荐
写代码就能出片:Code-to-Video开源项目全解析
web-video-produce 是一个 Code-to-Video 开源项目,用 React 和 Remotion 把做视频变成写代码:分段脚本自动生成配音、字幕、时间轴,支持 Canvas 图表、Three.js 三维、14种中文音色及自动音频验收。

LightOn OCR-3 上线 OpenDocRouter:开源 OCR 的性价比新标杆
LightOn OCR-3 现已上线 OpenDocRouter,定价每百万输入 token $0.28、输出 $1.40,约 $3.19/千页。ParseBench 测试显示其位于开源 OCR 帕累托前沿,性能接近 Gemini 3.8 flash low 且价格低约 45%。

LegalOn 如何将 Codex 成本砍半:模型分级与预算管控实战
法律科技公司 LegalOn 通过按任务匹配 Astra、Sol、Luna 等不同模型并战略性管理预算,在保持开发速度的同时将 Codex 每日成本削减约 65%。本文解析其模型分级与预算管控的实战经验。