Ollama对比OpenAI决策模型:本地推理速度实测
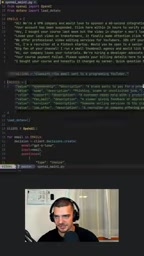
实测显示本地Ollama模型分类邮件仅需1.1秒,反超云端API的2.5秒。
文章记录了同一邮件分类任务在 OpenAI Decisions API、Ollama 本地模型和 Jeff 三种后端下的耗时对比。结果显示,OpenAI API 约 2.5 秒,Jeff 约 2.9 秒,而 Ollama 本地模型在首次加载后仅约 1.1 秒,速度约为云端的两倍以上。本地推理的唯一代价是冷启动需将模型载入内存,之后延迟稳定且完全免费,测试者用搭载 GB10 的 Dell Pro Max 运行,并判断单卡 GPU 甚至普通 PC 即可支撑。作者指出邮件分类属于输入短、类别有限的决策类任务,正是本地小模型的速度优势区间,同时天然保护数据隐私,并给出高频轻量任务本地化、复杂推理留给云端的选型原则。
同一套邮件分类任务,交给OpenAI Decisions API、Ollama本地模型和Jeff分别跑一遍,速度会差多少?一位YouTube创作者用自己内容管理工具中的真实需求做了这组对比,结果指向一个越来越清晰的趋势:在特定任务上,本地小模型的响应速度已经可以反超云端API。
同一任务,三种跑法
测试任务本身很朴素:给定几封邮件和一段指令,让模型判断每封邮件属于赞助邀约、垃圾推广、粉丝来信、服务咨询还是职位邀请中的哪一类。这套分类逻辑来自创作者自己的管理工具,因此需求非常具体——不是跑分,而是日常真正要用的功能。
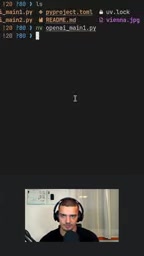
三个版本的代码结构几乎一致,只是后端不同:调用OpenAI Decisions API的版本、调用Ollama本地模型的版本,以及跑在Jeff上的版本。指令和候选类别完全相同,保证对比公平。
文中提到的「OpenAI Decisions API」并非 OpenAI 官方公开的通用产品名称,而更可能指代一类面向结构化决策任务的 API 封装:开发者传入指令与候选选项,模型直接返回其中一个离散类别(类似分类或路由),而不是自由生成文本。这类接口的典型特征是把输出约束在有限标签集合内,减少后处理解析成本。需要注意,不同平台对「Decisions」的命名和实现差异较大,有的基于函数调用(function calling),有的基于 JSON schema 约束解码。理解这一点有助于判断对比的公平性:如果三方都采用相同的候选类别与指令格式,耗时差异主要来自推理后端而非提示工程。
实测耗时:本地推理反超云端
用time命令计时后,三者的差距相当直观:
- OpenAI Decisions API:约2.5秒
- Jeff:约2.9秒
- Ollama本地模型:首次运行较慢(需要把模型加载进内存),加载完成后约1.1秒
也就是说,模型常驻内存之后,本地Ollama的响应速度大约是云端API的两倍以上。对于需要连续处理多封邮件的场景,这个差距会被进一步放大——每次分类省下一秒多,批量处理时的体验差异是数量级的。
首次加载是唯一的代价
本地推理唯一的短板出现在冷启动。第一次调用时模型需要从磁盘加载到内存,这一步会明显拖慢首轮响应。但之后所有请求都直接命中已加载的模型,延迟稳定在低位。这个特性意味着本地方案特别适合常驻服务的形态:服务跑起来之后,边际成本几乎为零。
冷启动(cold start) 指模型进程尚未加载权重时的首次推理,需要把数 GB 的模型文件从磁盘读入内存/显存,耗时通常在数秒到数十秒不等,取决于磁盘速度与模型大小。与之相对的热启动(warm start) 则直接复用已加载的权重,延迟大幅下降。工程上常见的缓解手段包括:让服务常驻不退出、使用 keep_alive 参数延长模型驻留时间、预热请求(warm-up)以及在服务启动阶段主动加载模型。对于批处理场景,还可以把多封邮件合并为一次请求,摊薄单次调用开销。理解冷热启动的差异,是评估本地方案是否适合自身业务的关键前提。
成本结构完全不同
Ollama方案的另一层优势是费用。测试者明确提到Ollama模型是免费的,运行在自己的Dell Pro Max(搭载GB10)上,并且判断单张GPU也足以支撑这个负载,普通PC同样可以跑。相比之下,云端API按调用计费,Jeff则介于两者之间。对于高频、任务固定的分类场景,本地部署在成本上的优势会随时间持续累积。
Ollama 是一个开源的本地大模型运行框架,提供类似 Docker 的命令行与 REST API,可一键拉取并运行 Llama、Mistral、Qwen 等开源权重模型。它的核心价值在于把模型量化、GPU/CPU 调度、显存管理等底层细节封装起来,开发者只需 ollama run 即可启动服务。文中「把模型加载进内存」正对应 Ollama 的模型常驻机制:首次请求触发权重从磁盘载入显存或内存,之后请求复用同一进程。这也是本地推理冷启动慢、热启动快的根本原因。Ollama 默认监听本地端口,因此数据不出本机,天然具备隐私优势。
这组对比说明了什么
有意思的是任务类型。邮件分类属于典型的"决策模型"场景:输入短、类别有限、输出是离散选择,对模型的通用推理能力要求不高,但对延迟敏感。这类任务恰好是本地小模型的主场——参数规模可以压得很低,推理速度快,而且完全不需要把邮件内容发送到第三方服务器,数据隐私天然有保障。
这并不意味着本地模型可以全面替代云端API。复杂推理、长上下文、多模态理解等任务仍然依赖更强的模型。但这组实测给出了一个实用的选型原则:先把任务拆开,固定分类、抽取、路由这类高频轻量任务交给本地模型,复杂任务留给云端,整体延迟和成本都能显著优化。
测试者透露专门的Ollama决策模型视频已经在制作中,说明围绕本地模型做任务级部署的实践正在从实验走向常规。对开发者来说,用Ollama跑决策类模型的门槛已经低到可以随手验证——一个脚本、一张显卡,就能跑出比云端API更快的响应。
决策模型任务(decision-making task)在工程语境下通常指输出空间有限且离散的任务,例如分类、意图识别、路由分发、实体抽取等。这类任务与开放式生成的根本区别在于:模型不需要长链推理或创造性表达,只需在给定标签集中做判断。因此小参数模型(如 1B–8B 级别)往往就能达到可接受准确率,而延迟与成本远低于大模型。这也解释了为何本地小模型在此类场景能反超云端 API——云端调用的网络往返、排队调度和通用大模型的推理开销,在短输入任务上反而成为主要瓶颈。选型时应以任务复杂度而非模型名气为依据。
相关推荐
Gemini 4 Carbon登顶智能指数 谷歌首次开放攻防模型
谷歌Gemini 4 Carbon以59分登顶Artificial Analysis智能指数,网络安全能力首次向防御方开放;OpenAI每月返还最高500美元API额度反击,开源阵营语音、小模型与智能体工程密集迭代。

Gemini 4 Carbon登顶AI基准,成本比榜首低72%
谷歌DeepMind发布Gemini 4 Carbon,在Archital Analysis Intelligence Index B5榜单以59分登顶,Arena文本榜第一1528分,中位任务成本仅80美元,比榜首Cloud Office 1.5低72%。

Gemini 4 Carbon实测:最强AI模型?对比Claude Opus 5.5
谷歌Gemini 4 Carbon发布,Artificial Analysis榜单第一,CW Bench达71%,Vending Bench登顶。实测对比Claude Opus 5.5,前端设计惊艳但Web开发略逊,价格优势明显。