Ollama入门指南:零基础本地免费运行AI大模型
Ollama 让你用几行命令在本地免费运行大语言模型,兼顾隐私、零成本与快速原型开发。
这篇文章以一期面向零基础学习者的泰米尔语教程为基础,系统介绍了 Ollama 这一本地大语言模型运行工具的核心价值与使用场景。文章用「复印店」类比阐明云端 AI 服务在数据隐私、调用成本和可用性上的天然局限,进而说明 Ollama 如何通过本地部署彻底规避这些约束——无需互联网、无需 API 密钥、零费用。在此基础上,文章介绍了安装流程的简洁性、可灵活选用不同开源模型的自由度,以及以聊天助手为起点构建真实 AI 应用的可能性。同时也坦率指出局限:本地硬件算力和内存是性能天花板,无法替代云端集群处理超大规模任务。整体逻辑形成从动机、工具认知、上手路径到边界认知的完整闭环。
为什么需要 Ollama
当 ChatGPT、Claude 这些强大的云端 AI 工具已经触手可及时,为什么还要在本地部署开源模型?答案藏在实际的工程约束里。如果你想用公司内部文档搭建一个 AI 助手,或者开发一款面向用户的聊天机器人,那么数据隐私、成本控制和调用限制会立刻成为绕不开的问题。
这也是这期泰米尔语教程的核心切入点:Ollama 让你无需互联网连接、无需 API 密钥、无需任何费用,就能在自己的笔记本电脑上运行大语言模型。对于打算转型 AI 工程师的人来说,理解这一层约束比会调用某个 API 更重要。
一个复印店的比喻
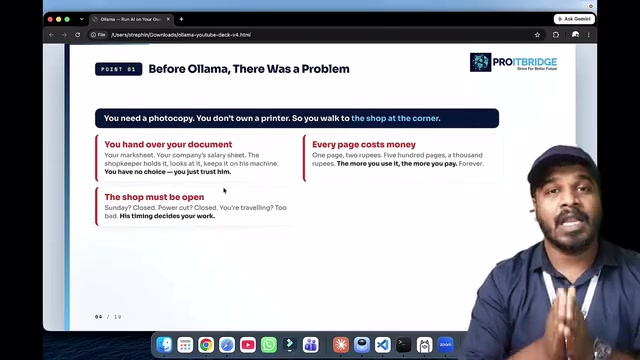
教程里用了一个通俗的类比来解释本地部署的价值。假设你需要复印一份机密文件,但家里没有打印机,只能拿到街角的商店去。你得把文件交给店家、按页付费,还得等店铺开门营业——一旦当地停电、发电厂出问题,整个流程就瘫痪了,你什么都控制不了。
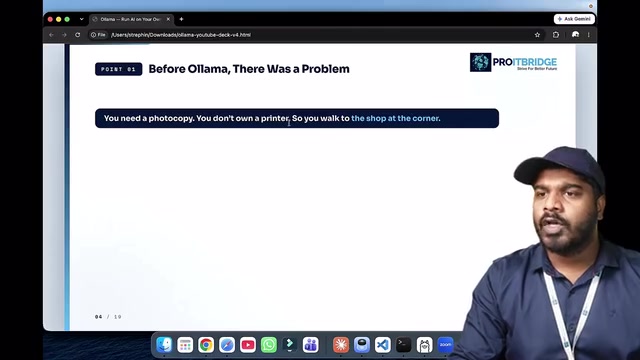
把「复印店」换成「云端 AI 服务」,逻辑完全一致:你的数据要交出去、每次调用都要花钱、服务可用性完全依赖第三方。而 Ollama 相当于把这台「打印机」直接搬回家——文件不出本地、调用零成本、随时可用。
Ollama 是什么
AI(人工智能)指的是开发能够执行通常需要人类智能才能完成任务的计算机系统。Ollama 则是让这类模型「跑起来」的工具:它把大语言模型的下载、加载和推理封装成极简的命令,你在终端里几行指令就能启动一个本地模型。
它的关键特性可以概括为三点:
- 离线运行:不依赖互联网,模型完全跑在本地设备上
- 零费用:没有 API 调用计费,用多少都不额外花钱
- 无密钥门槛:不需要注册申请任何 API Key
对刚接触 AI 工程的初学者而言,这意味着可以在几乎零成本的环境里反复试验,不必担心账单或额度耗尽。
从技术架构角度看,Ollama 的核心工作是管理模型的量化版本(quantized models)。所谓量化,是指将模型权重从高精度浮点数(如 float32)压缩为低精度整数(如 int4、int8),从而大幅减少内存占用和计算量,使原本需要数十 GB 显存的模型能在普通笔记本电脑上运行。Ollama 还内置了一个本地 HTTP 服务器,默认监听 11434 端口,对外提供与 OpenAI API 兼容的接口。这意味着许多已经支持 OpenAI SDK 的应用,只需更改一行 base URL,就能无缝切换到本地 Ollama 模型。目前支持的模型涵盖 Llama 3、Mistral、Gemma、Phi 等主流开源系列,可以通过 ollama pull <模型名> 直接下载。
如何安装并运行
教程给出的路径非常直接:先在终端中完成 Ollama 的安装,然后拉取并运行一个模型即可开始使用。整个流程无需复杂配置,装好之后模型就能在本地待命。
值得强调的是可选模型的灵活性——你可以根据项目需要挑选不同的开源模型,也可以根据自己的数据量和场景来权衡「用哪个模型、用多少数据、要考虑哪些因素」。这正是 AI 工程师在真实项目中反复面对的决策。
打造你自己的应用
Ollama 的真正用途在于让你构建属于自己的 AI 应用。教程演示了一个基于聊天界面的助手:本质上就是一个聊天界面,背后由本地模型驱动。
在此基础上,你可以进一步喂入公司文档,做出一个懂业务的内部 AI 助手;或者面向用户发布一款聊天机器人产品,甚至以此为起点搭建自己的公司。开源模型 + 本地部署,为这类想法提供了低门槛的起跑线。
Ollama 的局限在哪里
本地部署并非万能。教程也坦率地指出了它的边界:你的笔记本电脑就是运行上限。
换句话说,模型能跑多大、推理有多快,完全受限于本地硬件的算力和内存。在个人设备上,你很难运行那些参数量极大的顶级模型,性能表现也无法与云端集群相比。理解这条约束很重要——它决定了 Ollama 适合做原型验证、隐私敏感场景和轻量应用,而在需要超大规模算力的场景下,云端方案仍不可替代。
影响本地模型性能的核心瓶颈是统一内存(Unified Memory)或显存(VRAM)大小,而非 CPU 主频。以参数量为参考:7B 参数的量化模型(Q4 精度)大约需要 4-5 GB 内存,13B 模型需要约 8 GB,70B 模型则需要 40 GB 以上。这意味着配备 16 GB 内存的 MacBook 可以流畅运行 7B 至 13B 量化模型,但对更大规模的模型则力不从心。Apple Silicon 芯片(M1/M2/M3 系列)因为 CPU 和 GPU 共享内存,在本地推理上比同价位的 x86 笔记本更有优势。了解这些硬件约束,有助于在项目初期就做出合理的模型选型决策。
小结
这期教程面向零基础学习者,把 Ollama 的价值讲得相当接地气:从复印店的类比出发,说明本地部署在隐私、成本和可控性上的优势,再落到安装、构建应用和认清局限的完整闭环。对于想入门 AI 工程的人来说,Ollama 是一个既省钱又能快速上手的实验平台,关键是要清楚它「能做什么」和「做不到什么」。
相关推荐

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。

构建语义代码搜索的RAG管道:原理与实践
本文解析如何为语义代码搜索构建RAG管道,涵盖代码分块、向量化、检索重排与生成四大环节,并探讨分块策略、embedding模型选择和索引维护等落地挑战。