OmniGround:用注意力一致性训练补齐全模态时序定位短板
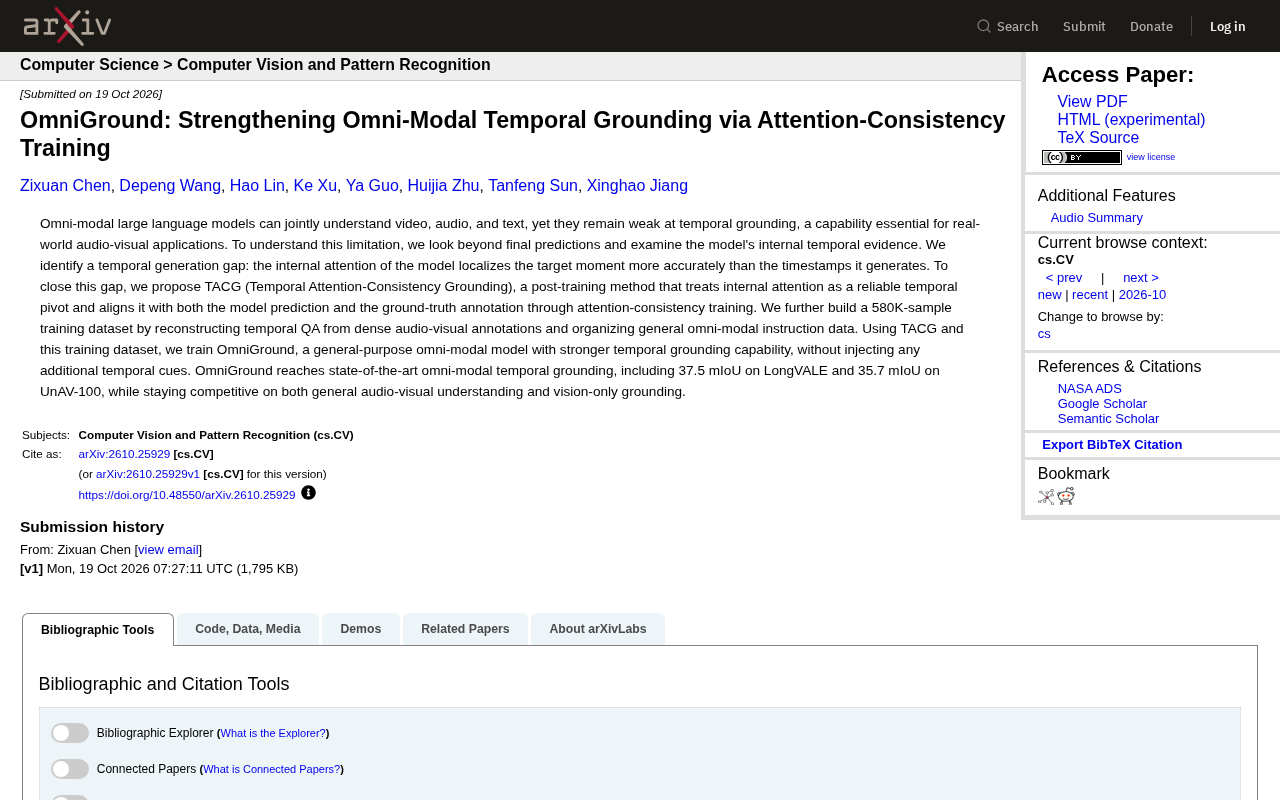
OmniGround 发现模型注意力比输出时间戳更准,用 TACG 校准后刷新全模态时序定位 SOTA。
全模态大模型能同时理解视频、音频和文本,但在时序定位任务上表现不佳。OmniGround 团队深入模型内部发现,注意力机制对目标时刻的定位精度显著高于模型实际生成的时间戳,并将这一错位命名为“时序生成鸿沟”。为此,团队提出 TACG 后训练方法,通过注意力一致性训练让内部注意力分布同时对齐预测结果和真实标注,不引入额外时序线索、不修改模型架构。团队还构建了 580K 样本训练数据集,训练出 OmniGround 模型,在 LongVALE 上达到 37.5 mIoU、UnAV-100 上达到 35.7 mIoU,刷新全模态时序定位 SOTA,同时保持通用音频-视觉理解和纯视觉定位的竞争力。
全模态大模型能同时理解视频、音频和文本,但在时序定位任务上始终表现不佳。OmniGround 团队发现,模型内部的注意力机制其实比它输出的时间戳更准,于是提出 TACG 方法,通过注意力一致性训练将这一内部信号对齐到预测结果,并构建 580K 样本数据集训练出 OmniGround 模型,在 LongVALE 和 UnAV-100 上刷新了全模态时序定位的 SOTA。
时序生成鸿沟:注意力比预测更准
研究团队没有停留在最终预测结果上,而是深入模型内部检查时序证据。他们发现了一个反直觉的现象:模型内部注意力对目标时刻的定位精度,显著高于它实际生成的时间戳。换句话说,模型“心里知道”答案在哪里,但“嘴上说不准”。
这个发现指向一个关键洞察——时序定位的瓶颈不在于模型缺乏理解能力,而在于内部表征与输出生成之间存在错位。作者将这一现象命名为“时序生成鸿沟”(temporal generation gap)。它解释了为什么全模态模型在视频理解基准上表现不错,却在需要精确时间定位的任务上频频失手。
对于音频-视觉应用而言,时序定位是基础能力:从视频中检索特定声音事件、定位对话片段、对齐多模态事件边界,都依赖这一能力。鸿沟的存在意味着现有全模态模型距离实用还有一段距离。
全模态时序定位(Temporal Grounding) 指的是给定一段视频或音视频内容与一句自然语言查询,模型需要输出该查询所对应事件在时间轴上的起止区间(start/end timestamp)。评价指标通常使用 mIoU(mean Intersection over Union),即预测时间区间与真实区间交并比的平均值。与视频检索、视频问答等只需输出语义标签或文本的任务不同,时序定位要求模型具备细粒度的时间感知能力,输出的是连续时间坐标而非离散类别,因此对模型内部时间表征的精度要求更高。全模态模型需要同时处理视觉帧序列、音频波形和文本查询三种模态,并在统一的时间轴上完成对齐,这正是该任务的核心难点。
TACG:把内部注意力当作时序支点
针对这一鸿沟,团队提出 TACG(Temporal Attention-Consistency Grounding),一种后训练方法。其核心思路是把模型内部注意力视为可靠的时间支点,通过注意力一致性训练,让注意力分布同时对齐模型预测和真实标注。
TACG 的设计巧妙之处在于不引入任何额外的时序线索。它不依赖外部时间戳编码器,也不修改模型架构,而是在训练阶段利用注意力与预测、标注之间的一致性约束来“校准”模型。这相当于让模型学会把自己内部已经掌握的时间信息,更准确地翻译成输出时间戳。
这种后训练策略的工程价值很高:不需要从头训练,不需要额外模态输入,可以直接叠加在现有全模态模型之上,降低了落地门槛。
注意力一致性训练(Attention-Consistency Training) 是一种利用模型内部注意力分布作为监督信号的后训练策略。在全模态模型中,注意力权重反映了查询 token 对视频/音频帧的依赖程度,峰值位置往往对应查询所指事件的时间位置。TACG 的做法是构造约束,使注意力分布、模型输出的时间戳预测以及真实标注三者趋于一致:注意力峰值应落在真实区间内,预测时间戳也应与注意力峰值对齐。这种训练不需要额外标注,也不改变推理时的模型结构,本质上是把模型已有的内部知识显式化。类似思路在视觉定位和可解释性研究中已有先例,但将其用于全模态时序定位尚属首次。
580K 样本数据集与 OmniGround 模型
方法之外,团队还从稠密的音频-视觉标注中重建时序问答,并组织通用全模态指令数据,构建了一个 580K 样本的训练数据集。这个数据集的规模在全模态时序定位领域相当可观,为训练提供了充足监督。
基于 TACG 和该数据集,团队训练出 OmniGround——一个通用全模态模型,具备更强的时序定位能力。实验结果显示了明确的提升:在 LongVALE 上达到 37.5 mIoU,在 UnAV-100 上达到 35.7 mIoU,均达到全模态时序定位的 SOTA 水平。
更关键的是,OmniGround 在通用音频-视觉理解和纯视觉定位任务上保持了竞争力,没有因为专攻时序定位而牺牲其他能力。这说明 TACG 的校准是“无损”的,不会破坏模型原有的多模态理解基础。
mIoU(mean Intersection over Union) 是时序定位任务的核心评价指标。对每个样本,计算预测时间区间与真实时间区间的交集长度除以并集长度,得到 IoU;再对所有样本取平均即为 mIoU,取值范围 0 到 1,通常以百分比表示。mIoU 越高,说明预测区间与真实区间重叠度越好。LongVALE 和 UnAV-100 是两个常用的音视频时序定位基准:LongVALE 侧重视觉-音频-语言联合理解,UnAV-100 则聚焦音频事件定位。OmniGround 在这两个基准上分别达到 37.5 和 35.7 mIoU,这一数值在精确时间定位任务中属于较高水平,因为时间区间预测对边界误差非常敏感。
对全模态模型训练的启示
OmniGround 的工作提供了一个值得关注的范式:与其在输出端堆叠复杂的解码策略,不如回到模型内部,检查中间表征是否已经包含了被浪费的信息。时序生成鸿沟的发现提醒研究者,全模态模型的评估不应只看最终指标,内部注意力的诊断价值同样重要。
从应用角度看,时序定位能力的增强会直接惠及视频检索、音视频事件检测、多模态内容理解等场景。OmniGround 在不注入额外时序线索的前提下实现 SOTA,也意味着现有全模态模型可能普遍存在类似的“注意力-输出错位”问题,TACG 或许能推广到更广泛的模型家族。
当然,论文目前披露的细节有限,TACG 在不同架构上的泛化性、注意力一致性约束的具体形式、以及 580K 数据集的数据分布,都还有待进一步验证。但就现有结果而言,这条“向内看”的训练思路为全模态时序定位提供了一个清晰且可复现的方向。
相关推荐

Product Hunt 推出可视化发布编辑器,告别繁琐填写
Product Hunt 推出可视化发布编辑器,支持点击原位编辑名称、标语、画廊和 maker 信息,自动保存草稿,并用检查清单引导创作者完成发布。本文解析其编辑逻辑与对发布体验的影响。

泽连斯基亲述:俄军2000万人压境,我们如何守住基辅
泽连斯基访谈回顾俄乌战争初期:俄军200,000兵力直扑基辅,乌军主力却在东部。他讲述动员如何将军队从200,000扩张到800,000,以及基辅州、切尔尼戈夫州如何被收复。

Ovren Live Preview:用自然语言实时预览产品改动
Ovren Live Preview 是一款用自然语言描述改动、在真实页面上实时预览的 AI 开发工具。了解其核心功能、工作流、市场定位与潜在挑战。