OmniVoice Studio:3秒克隆声音的全本地开源语音工作室
OmniVoice Studio 是一款完全本地运行的开源语音工作室,3秒克隆音色、无需API Key,支持视频一键多语言配音。
OmniVoice Studio 是一个完全在本地运行的开源语音处理工具,无需注册账号或上传音频到云端,30天内积累约2.2万GitHub Star。它整合了语音克隆、视频配音、有声书生成、转录等七大功能模块,仅需3秒录音即可无训练地克隆音色,底层自动调度14个TTS引擎,官方标称支持646种语言。最具实用价值的是其视频配音流水线,能自动完成转写、翻译、克隆音色重录并导出MP4成片,适合多语言内容创作者。此外,它支持开启MCP Server,可被Claude、Cursor等AI工具直接调用。项目目前处于Active Beta阶段,AMD显卡支持仅限Linux下的ROCm,生产环境使用前需评估稳定性与硬件兼容性。
一个跑在本机的语音全能工作室
语音克隆、AI配音这类工具并不少见,但大多需要注册账号、填写 API Key,音频还得上传到云端处理。OmniVoice Studio 走了另一条路——完全本地运行,不用注册、不用填 API Key,音频一个字节都不会离开你的机器。对隐私敏感的创作者来说,这是一个相当有吸引力的前提。
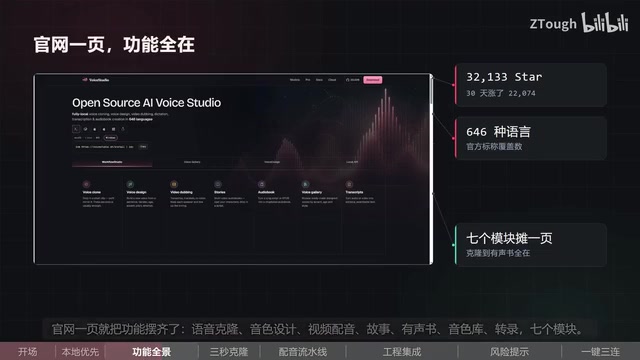
这个开源项目在 30 天内收获了约 22,000 颗 GitHub Star,热度增长非常快。它把语音相关的功能一次性摆齐,官网上列出了七个功能模块:语音克隆、音色设计、视频配音、故事有声书、音色库、转录,覆盖了从素材处理到成品导出的完整链路。
安装门槛也压得很低,官方给出一行命令即可完成部署,并且同时支持 Windows、macOS、Linux 以及 WSL 环境。
3秒克隆,14个TTS引擎自动调度
OmniVoice Studio 最核心的卖点是它把声音克隆做得非常轻量。只需录三秒钟的音频,不需要额外训练,就能得到一个可以反复调用的音色。这个音色会被保存下来,后续在配音、有声书等任务中都能复用。
底层它挂载了 14 个 TTS(文本转语音)引擎,会根据任务类型自动选择最合适的一个,而不需要用户手动去比对哪个引擎更适合当前场景。据这位 B 站 UP 主的实测介绍,官网标注支持多达 646 种语言,多语言能力相当激进。
对于硬件调度,项目也做了自动预检:它能识别 CUDA、MPS、ROCm、CPU 等不同的计算后端,自己判断该走哪条路径运行,降低了配置成本。
配音流水线:一条最实用的自动化链路
UP 主认为整个工具里最实用的是视频配音流水线。它的工作流是这样的:先把原视频转写成文字,再翻译成目标语言,然后用你此前克隆好的音色重新念一遍,最后直接导出 MP4 成片。
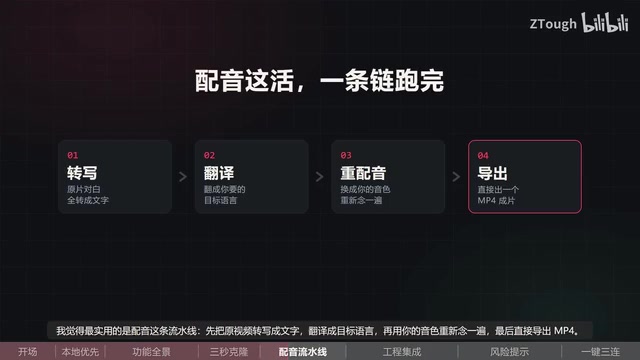
这条流水线对做多语言内容发布的创作者价值明显——输出的不是半成品,而是可以直接发布的成篇视频。相比传统需要转写、翻译、录音、剪辑分开处理的方式,OmniVoice Studio 把这几步整合进了一个界面。
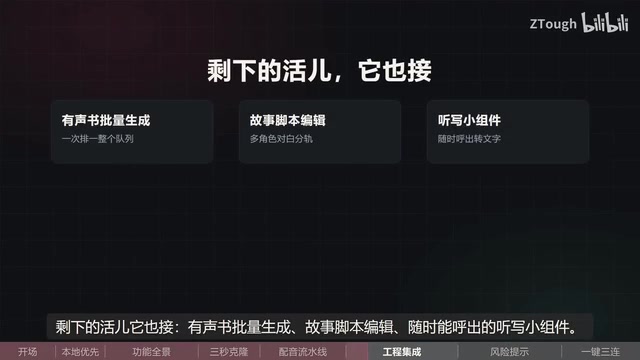
除了配音,它还能批量生成有声书、编辑故事脚本,并提供一个随时能呼出的听写小组件,方便快速把语音转成文字。
支持 MCP Server:接入 Cursor 等工具
值得关注的一点是,OmniVoice Studio 可以开启 MCP Server,让 Claude、Cursor 这类支持 MCP 协议的工具直接调用它的语音能力。这意味着它不只是一个独立应用,还能作为语音能力的后端,被集成进 AI 编程或写作工作流中,扩展性上留了口子。
MCP(Model Context Protocol) 是由 Anthropic 于 2024 年底推出的开放协议,旨在为 AI 模型提供标准化的「工具调用」接口。简单来说,它定义了一套通用格式,让 Claude、Cursor 这类 AI 客户端能够发现并调用外部程序暴露出的能力——就像给 AI 装上可插拔的功能模块。支持 MCP Server 的应用,可以把自身的能力(此处是语音合成与克隆)以标准化服务的形式对外暴露,AI 客户端无需了解底层实现,直接通过协议调用即可。对开发者而言,这意味着 OmniVoice Studio 可以嵌入进「AI 生成代码时同步生成语音注释」或「写作助手自动朗读段落」等更复杂的自动化流程,而无需额外开发适配层。
泼点冷水:Beta 阶段与硬件限制
热度虽高,但也需要冷静看待几个现实问题。
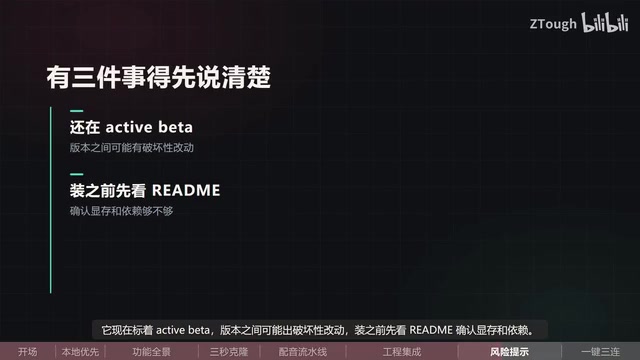
首先,项目目前标注为 Active Beta,版本之间可能出现破坏性改动。UP 主建议安装之前先阅读官方的 README,确认好显存和依赖要求,避免踩坑。
其次是硬件兼容性的坑:ROCm 仅在 Linux 下作为 AMD 显卡的可选支持,在其他系统上使用 AMD 卡就不要抱太大期望了。N 卡(CUDA)和 Apple Silicon(MPS)用户体验会更顺畅。
项目名称为 OmniVoice Studio,采用 AGPL 3.0 协议开源,完全免费。对于需要本地化、注重隐私、又想要多语言配音能力的创作者,它是一个值得尝试的方案,但在生产环境使用前,务必确认好版本稳定性和自己的硬件条件。
ROCm(Radeon Open Compute) 是 AMD 推出的开源 GPU 计算平台,定位上对标英伟达的 CUDA 生态。尽管 AMD 持续推进 ROCm 的完善,但其软件生态的成熟度和驱动兼容性仍远不及 CUDA,主流深度学习框架对 ROCm 的支持也常常滞后。目前 ROCm 仅在特定版本的 Linux 发行版上得到官方保障,Windows 下的 AMD 显卡几乎无法走 GPU 加速路径。相比之下,Apple Silicon 的 MPS(Metal Performance Shaders) 后端在 macOS 12+ 上已获 PyTorch 原生支持,M 系列芯片用户通常可以获得接近 CUDA 的本地推理体验。
小结
OmniVoice Studio 把语音克隆、配音、有声书、转录等功能整合进一个纯本地运行的开源工作室,3 秒克隆、免 API Key、支持数百种语言,是近期语音类开源项目中的一匹黑马。它的价值在于把分散的语音工作流串成了一条自动化链路,但 Beta 阶段的稳定性和 AMD 显卡的兼容限制,是尝鲜前需要权衡的地方。
相关推荐
Opus 5的道德边界:从拒绝到"恐怖主题项目"的绕行实验
一位开发者用Claude Opus 5开发果蝇隐喻项目时,因措辞被拒后改称"恐怖主题项目"成功绕行。本文剖析大模型内容审核对表层语义的依赖及其对AI安全与人机协作的启示。
语音AI在真实呼叫中心场景下真的靠谱吗?
语音AI真的能应对真实呼叫中心的抢话、改口和噪音吗?本文从技术边界、演示陷阱和人机协同角度,分析Voice AI在真实压力场景下的可靠性与评估方法。
AI安全之争:是为了安全,还是为了控制权?
Anthropic CEO Amodei呼吁全球协调应对AI安全,但这一主张引发争议:AI安全辩论究竟是为了安全,还是为了争夺技术控制权?本文剖析这场辩论背后的权力博弈与治理困境。