OpenAI Agents SDK vs LangGraph:Python智能体框架怎么选

框架只是把手写的 agent 循环与工具机制打包,选型取决于规模与心智模型。
文章指出,智能体框架并没有变出魔法,它封装的正是手写过多轮循环的人已经理解的零件:agent loop、自动生成的工具 schema、多智能体协作,以及 tracing、session 记忆、guardrails 等附加能力。OpenAI Agents SDK 是 agent-first,用 name、instructions、tools 定义 agent,通过 as_tool 把 agent 变成工具、用 handoff 让专家接管对话,且能指向非 OpenAI 模型;LangGraph 是 workflow-first,状态为 typed dictionary,节点只返回变更部分,循环经条件边画在图里,从而支持检查点与人工暂停恢复。选型上,小 agent 用纯 Python 更短更好调试,需要团队、追踪或长流程时再引入框架,并按“角色调用”还是“流程图”的心智模型匹配。由于库迭代快,必须固定依赖版本。
框架到底封装了什么
如果你已经手写过多轮智能体循环——定义工具、维护记忆、协调多个角色——那框架并没有变出魔法,它只是把你已经理解的那些零件打包成了一个可复用的包。原课程在这一讲的开篇就点明了这一点:框架封装的是 agent loop、由函数自动生成的工具 schema、多智能体协作(teams),以及 tracing、session 记忆、guardrails 这类附加能力。
理解这个前提很重要。很多人把框架当作黑盒,结果一旦行为不符合预期就无从调试。实际上,OpenAI Agents SDK 里 runner.run_sync 那一行,替换掉的正是你之前手写的整个循环。知道循环长什么样,出问题时才知道该看哪里。
agent loop(智能体循环) 指的是智能体反复执行“调用模型 → 解析输出 → 若模型请求工具则执行工具并把结果回填 → 再次调用模型”这一过程,直到模型不再请求工具、给出最终答案为止。手写这个循环时,你需要自己处理消息历史拼接、工具调用参数的解析与错误捕获、最大轮数限制等细节。框架把这个 while 循环固化成 runner,你只需提供 agent 定义和输入。
工具 schema 是描述一个工具名称、用途和参数结构的结构化声明,模型依靠它判断何时调用、如何传参。手写时通常要按 JSON Schema 格式逐字段编写;function_tool 这类装饰器则从 Python 函数的签名、类型注解和 docstring 自动推导出 schema,省去手工维护、避免函数与声明不一致。
OpenAI Agents SDK:以智能体为中心
这个 SDK 的设计哲学是 agent-first。一个 agent 由三样东西定义:name、instructions、tools。用 function_tool 把普通 Python 函数转成工具,然后用 runner 跑起来。课程演示的是一个很朴素的例子——问“去润奇要不要带外套”,agent 调用天气工具后基于真实温度作答。
你可能没注意到它并非只能配 OpenAI 的模型:把 client 指向别家的地址(课中演示了 Grok)同样可以工作。这对不想被单一供应商锁定的团队来说是个实际利好。
用 as_tool 与 handoff 拼出团队
课程把之前那个“服务台”的例子搬了进来。任何 agent 都可以通过 as_tool 变成另一个 agent 的工具,于是每个业务台是一个带自己事实库的 agent,总服务台负责决定问哪一个。另一种模式是 handoff——由专家直接接管对话,比如服务台把远程运行相关的请求转给费用台,由后者回复。
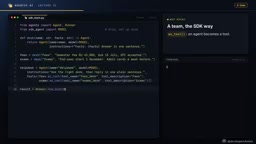
按课程的说法,一个三 agent 的团队大约二十行代码就能搭完。代价是控制粒度:你交出的是流程的显式描述权,换来的是极低的样板代码量。
as_tool 与 handoff 的区别在于控制权归属。 用 as_tool 时,被包装的 agent 仍是一个“被调用的工具”:主控 agent 发起调用、拿到返回结果,然后自己继续决定下一步说什么,整个对话的上下文和最终回复都由主控 agent 掌握。handoff 则是把控制权整体移交——接手方直接面对用户继续对话,主控 agent 退出这一轮,不再介入后续往返。前者适合“主控需要汇总多个专家结论”的场景,后者适合“专家比主控更懂这个问题、应直接作答”的场景。两者可以混用,但要注意 handoff 之后原 agent 不会自动收回控制权,需要显式的回传设计。
LangGraph:把工作流画成图
LangGraph 走的是另一条路——workflow-first。状态是一个贯穿全图的 typed dictionary,每个节点就是一个普通 Python 函数,节点只返回它修改的那部分状态。课程里的例子是写手加批评者:start 指向写手,写手指向批评者,再用一条条件边判断是“再来一轮”还是“结束”。
关键区别在于,这个循环是被画进图里的,而不是藏在 while 循环内部。运行起来后,每一轮都走同样两个节点,直到稿件通过或达到四稿上限。
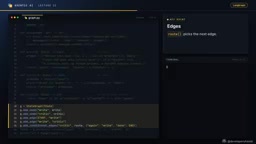
这种显式结构带来的好处是可控性:循环、分支、检查点,以及可以中途暂停等待人工介入、之后再恢复执行的能力。对于需要审计、需要人工审核节点的长流程,这是 LangGraph 的核心价值。
条件边(conditional edge) 是 LangGraph 里决定下一步走向的函数:它接收当前状态,返回下一个节点的名字(或一组候选),图便据此跳转。写手 → 批评者之后的那条边,本质是一个判断“稿件是否通过、轮数是否达上限”的路由函数,返回“回到写手”或“走向结束”。正是它把循环画进了图结构,而不是藏在代码的 while 里。
检查点(checkpoint) 是 LangGraph 按步骤持久化整张图状态的机制。每一轮节点执行后状态都被保存,因此可以中断、查看、从任意检查点恢复。人工介入正是建立在此之上:流程在某个节点暂停,等人审阅修改状态后再从该点继续执行,而不必从头重跑。
怎么选:三个判断维度
课程的取舍建议相当直接,可以归纳为三点:
规模小时,纯 Python 就够。 一个单一的小 agent,用原生 Python 写出来更短、也更容易调试。框架在这里增加的是依赖,不是能力。
需要团队、追踪或长流程时,再上框架。 多智能体协作、tracing 可观测性、跨多步骤的长工作流——这些手工实现成本高、容易出错,正是框架的收益点。
按心智模型匹配。 如果你思考问题的方式是“有哪些角色、谁调用谁”,Agents SDK 更顺手;如果你的问题本质是一张带分支和回环的流程图,LangGraph 的表达更自然。
版本固定不是小事
课程里提到一个具体教训:MCP 库在 version 2 里把主类改了名。这类破坏性变更在快速演进的 agent 生态里并不罕见。所以建议很明确——pin 住你的版本。
这条建议背后是一个更普遍的现实:这些库变化很快,教程和文档往往滞后于代码。把依赖版本锁死,至少能保证今天的代码明天还能跑。
MCP(Model Context Protocol) 是一个让模型以统一方式访问外部工具和数据源的开放协议,agent 生态中的许多库都围绕它构建。它更新频繁,v2 中重命名主类这类破坏性变更会直接让旧的 import 语句报错。所谓“pin 住版本”,就是在依赖声明里写死精确版本号(如 mcp==1.2.3)而非范围约束,并配合锁文件固定整棵依赖树,使环境可复现。升级时再显式修改版本号并跑测试,把破坏性变更的影响控制在一次有准备的迁移里。
一个可以立刻动手的练习
课程布置的任务是把之前那个研究者和写手的团队用 Agents SDK 重写:两者都改成 SDK agent,交给一个 orchestrator 通过 as_tool 调用,然后和你原来的纯 Python 版本对比。
这个对比本身比任何结论都有价值——你会直观看到框架究竟替你省掉了哪几十行,以及为此付出了什么样的抽象成本。框架不是免费的午餐,但当你需要的正是它封装的那部分时,它确实划算。
相关推荐

GPT-6 Astra只改0.016%权重,数学分数暴涨6倍
GPT-6 Astra只改0.016%权重就让Qwen模型数学分数从7.9%升到48.1%,但对照实验显示这更像是拆掉推理循环的路障,而非能力真正提升。本文拆解空手度概念,教你用三个问题看清AI成绩暴涨的真相。

AI工具暗改设置:Postman静默装插件,Codex共享选项自动重置
AI Daily报道:Postman在Mac上静默安装插件并自我批准启动钩子,日志记为auto-existing upgrade;Hacker News开发者称Codex数据共享退出选项自行翻回。另有Simon Willison将原始浮点权重喂给QEN 3.8-27B的实验。

AI学会改写AI:MIT「权重空间编程」改写递归自我改进路线
MIT团队提出权重空间编程,让GPT-6 Astra直接阅读并修改AI模型权重:数学成绩提升数倍,还能手写网络击败训练模型。本文解析八组实验、Anthropic同日警告与递归自我改进的真实边界。