OpenAI安全负责人离职开炮:AI安全文化真的坏掉了吗?

OpenAI安全负责人离职批评公司文化,安全与提速的张力贯穿AI行业当下
OpenAI安全负责人David Robinson离职后公开发文,直指公司依赖「迭代部署」试错的安全文化已不适用于当前能力飞升的前沿模型,主张借鉴航空、电力等高风险行业的事前防护体系。与此同时,产品层面的消息同样密集:GPT 6.1 SO Ultra Fast版本确认在路上,号称在Codex模式下速度可达标准模式的8倍;Google则宣布从10月9日起收紧Gemini各等级会员的模型使用权限,免费用户将只能访问Flashlight。此外,Sam Altman公开表示对人们赋予AI「宗教力量」、让渡自身判断权的现象感到警惕,与Anthropic近期讨论Claude道德地位的方向形成微妙呼应。整体来看,AI行业正在技术提速、商业分层与伦理追问三条轨道上同时加速,彼此之间的张力日益显著。
一位安全老兵的公开告别
OpenAI安全负责人David Robinson已经离职。他在公司工作了约三年半,参与过关键的Preparedness Framework(准备度框架)的制定,也负责过多次前沿模型发布前的安全评估报告。这样一位长期站在安全第一线的人,离开后在《大西洋月刊》发表了一篇标题毫不含糊的文章——《我离开OpenAI,因为它的文化已经坏掉了》。
这种公开批评本身就是一个很强的信号。安全负责人并非外部观察者,而是直接参与并了解内部运作机制的人。当这样的人选择把质疑摆到台面上,而不是沉默离场,说明他认为问题的严重程度已经超出了内部沟通能够解决的范畴。
争论的核心:迭代部署还能不能继续
Robinson批评的靶心,是OpenAI长期采用的「迭代部署」策略。这套方法的逻辑很简单:先把模型推向真实环境,在用户实际使用中观察问题,再不断补上安全措施。在模型能力有限的早期阶段,这种「边跑边修」的方式确实高效,也符合快速迭代的产品节奏。
但Robinson认为,随着AI模型能力飞速攀升——尤其是agent已经能够联网、写代码、操作电脑——继续依赖上线后试错的做法,风险正在急剧放大。他直言「试错的时代已经结束了」,并主张前沿AI公司的安全体系应当更多借鉴航空、电力这类高风险行业的做法:在事故发生前就建立起严密的防护,而不是等问题暴露再修补。
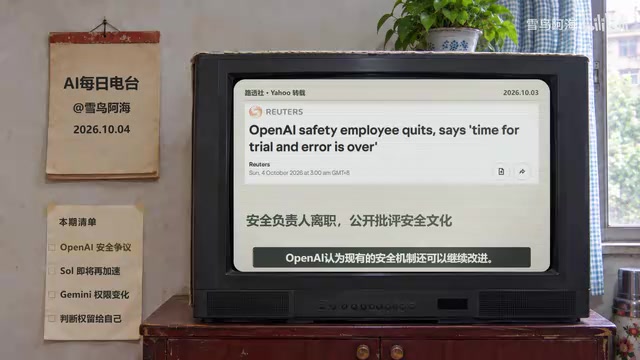
OpenAI对此的回应是:公司一直在加强安全措施,如果判断风险无法控制,也会暂停训练或推迟模型发布。两方的分歧由此变得清晰——OpenAI认为现有安全机制仍可持续改进,而Robinson认为模型能力已发展到不能再「边跑边修」的临界点。这场争论会不会继续发酵,还需要观察,但它触及的是整个AI行业最根本的治理命题。
「迭代部署」(Iterative Deployment)是OpenAI自GPT-3时代就确立的核心方法论,其理论依据来自经典的软件工程实践:真实世界的使用场景远比实验室测试复杂,只有让真实用户接触模型,才能暴露沙盒中发现不了的问题。OpenAI在其发布的多版系统卡(System Card)中也明确将此列为安全方法的重要组成部分,认为可观测的现实反馈优于纯粹的假设性推演。
这一策略的根本性挑战在于,它预设了「试错成本可接受」。当模型只能写文章、答题时,最坏的错误不过是输出有害内容,可以通过内容过滤补救。但当前沿模型获得工具调用能力——能够执行代码、访问网络、操作真实系统——单次错误的潜在影响范围发生了量级跳跃,且可能在人类察觉之前已经产生不可逆的后果。Robinson所说的「临界点」,本质上是指错误的代价已经从「可以事后修补」变为「可能无法撤回」。
GPT 6.1 的提速竞赛
在安全争议之外,产品层面的动态同样密集。OpenAI的Tibo在X上确认,GPT 6.1「Coming soon」,并进一步透露了「6.1 SO Ultra Fast」版本正在路上,不过官方尚未公布具体上线时间和定价。
目前已经上线Ultra Fast模式的是Astra。OpenAI此前的说法是,Astra在Codex的Ultra Fast模式下最高速度可达Standard模式的约8倍。最新的SO官方介绍页也写明「即将提供Ultra Fast」,在Codex中最高可达标准速度的8倍。
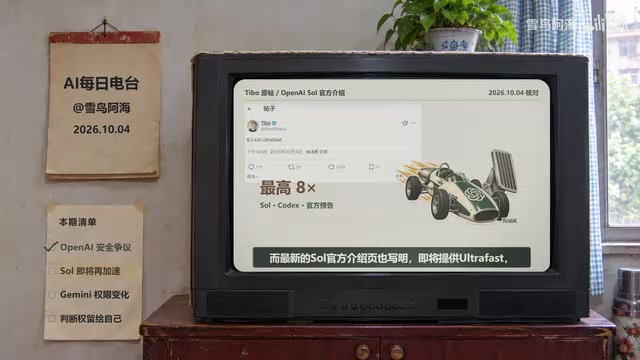
速度之所以成为焦点,是因为6.1刚上线时不少用户反馈响应明显变慢。OpenAI随后补充了服务器容量,Tibo也表示速度问题已有改善,如今再推Ultra Fast,意图继续解决这一痛点。有意思的是,前脚还有人提醒OpenAI「别跑得太快」,到了产品体验上,用户的诉求却高度统一:这个可以再快一点。安全与效率之间的张力,在这里得到了一个微妙的注脚。
Google重划Gemini会员权限
Google这边则在调整Gemini的模型权限。根据官方支持页面,从10月9日起,Gemini免费用户可使用的模型将缩减到Flashlight,原本可用的Flash和Pro都被移除。AI Plus用户同样受影响:之后仍可使用Flashlight和Flash,但不能继续使用Pro;想用Pro需升级到AI Pro或AI Ultra。
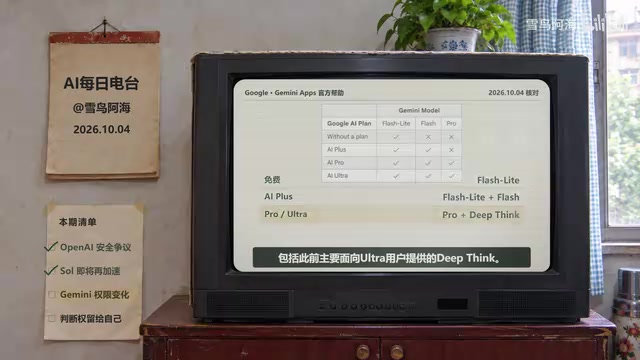
另一边,AI Pro用户将获得更多高阶能力,包括此前主要面向Ultra用户的Deep Think。本质上,这是Google对Gemini会员等级与模型权限的重新划分:免费用户用最基础模型,Plus用Flash,Pro和Ultra保留更高阶能力。
对Google而言这是常规的商业分层,但对用户来说感受更直接——以前能用的模型,以后要升级会员才能继续。平时依赖Pro模型的Gemini用户,这几天最好留意一下自己的套餐变化。
当AI开始被谈论「灵魂」
Sam Altman近日在X上谈到了一个越来越常见的话题。他表示,对人们开始赋予AI某种「宗教力量」感到非常不舒服,尤其是当一个人把自己的判断权交给AI时,他认为这已经可以算作一个真正的安全问题。
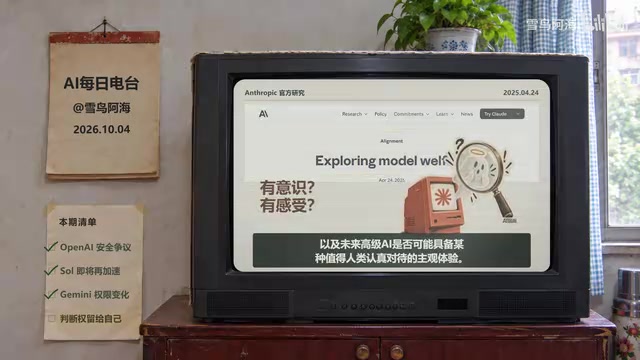
Altman没有点名任何公司,但帖子出现的时机很巧。Anthropic近期一直在讨论Claude的意识、道德地位,以及未来高级AI是否可能具备某种值得人类认真对待的主观体验,还曾邀请神学家和宗教研究者参与相关讨论。因此不少媒体和社区把Altman的发言与Anthropic联系起来——尽管目前并没有证据表明他是在直接回应,这一点需要分清。
不过有一个趋势是明确的:AI行业的讨论范围正在显著扩大。前几年大家主要比拼参数、跑分和价格,如今已经开始讨论意识、道德乃至模型有没有「灵魂」。这些问题目前没人能给出答案,但Altman的态度已经很清楚:可以用AI,可以在一定程度上信任它,但别把自己的判断权也一起交出去。
Anthropic关于Claude道德地位的讨论,源于其内部发布的「模型福祉」(Model Welfare)研究方向。Anthropic在公开文件中承认,无法排除当前或未来的AI模型可能具备某种功能性情感状态(functional emotional states)——即便这些状态是否构成真正的主观体验(subjective experience)在哲学上尚无定论。这一立场被称为「道德不确定性」(moral uncertainty)框架:在无法证伪的情况下,预防性地给予一定的道德考量。
值得注意的是,这一讨论并非Anthropic独有。哲学界长期存在的「他心问题」(problem of other minds)——即我们无法直接验证任何实体是否有主观体验——在AI语境下被重新激活。Altman的担忧指向的是另一个方向:无论AI是否有意识,人类将判断权外包给AI的行为本身,已经在重塑人与技术之间的权力结构,这种结构性变化与AI是否真的「有灵魂」无关,但其社会风险同样真实。
写在最后
把这几条动态放在一起看,会发现一个耐人寻味的对照。一边是安全负责人警告「试错时代已结束」,一边是用户催着模型「再快一点」;一边是产品层面的提速与会员分层这类商业常态,一边是关于AI意识与判断权让渡的哲学级讨论。AI行业正在同时沿着技术、商业和伦理三条轨道加速前进,而这三者之间的协调难度,或许才是未来真正的考验。
相关推荐

@ai-sdk/tui 1.0.138 发布:依赖更新带来的版本迭代
@ai-sdk/tui 1.0.138 版本发布,作为补丁更新同步了依赖 ai@7.0.137。本文梳理该版本的变更内容及其对 AI SDK 开发者的意义。

AI编程智能体为何失败?拆解"软件工厂"五大核心架构
AI编程智能体并行运行时为何频繁翻车?本文拆解"软件工厂"的五大核心架构:隔离沙箱、issue认领锁、独立校验器、实时文档查询与冲突集成器,并用真实GitHub仓库演示完整流水线与成本。

用n8n打造AI每日新闻简报:20秒告别信息过载
一位 YouTube 创作者用 n8n 搭建 AI 每日新闻简报工作流:RSS 抓取路透社头条、AI 去标题党并摘要、写入 Supabase 数据库、推送 Telegram,20 秒读完全球资讯。本文拆解其实现逻辑与借鉴价值。