OpenAI断供Cursor始末:国产AI加速开源平价布局

OpenAI与马斯克阵营的公开决裂
本周AI圈最引人瞩目的事件,莫过于OpenAI与马斯克阵营的正面冲突。OpenAI宣布自11月12日起正式终止编程工具Cursor对旗下模型的访问权限,甚至连下一代ASTA模型也将完全不予开放。
Cursor是一款基于VS Code架构深度改造的AI原生代码编辑器,由Anysphere公司开发,将大语言模型能力深度集成到编程工作流中,支持代码补全、跨文件编辑、自然语言生成代码等功能。VS Code(Visual Studio Code)是微软于2015年推出的开源代码编辑器,基于Electron框架构建,凭借轻量、可扩展和跨平台等特性,已成为全球开发者使用率最高的代码编辑器。Cursor在VS Code的开源代码基础上进行深度改造,将AI能力从插件级别提升到编辑器内核级别,实现了代码上下文的深度感知和跨文件语义理解。这种「AI原生」的设计理念意味着AI不是后期附加的功能,而是从底层架构就被设计为编辑器的核心能力。自2023年推出以来,Cursor迅速在开发者社区走红,被视为传统IDE向AI时代演进的标杆产品。其商业模式高度依赖后端大模型API的调用,因此模型供应商的选择直接关系到产品体验和运营成本。
事件的导火索直指资本层面的变动:SpaceX收购了Cursor,将其纳入马斯克的AI技术版图,这也直接触发了OpenAI的断供决定。马斯克通过SpaceX收购Cursor,是其构建AI全栈技术版图的重要一步。马斯克旗下的xAI公司已开发了Grok系列大模型,而Cursor作为开发者高频使用的编程入口,能为xAI提供宝贵的代码生成场景和真实用户反馈数据。这一收购逻辑类似于微软投资OpenAI后将其能力整合进GitHub Copilot——控制开发者工具入口,就能形成「模型-工具-数据」的商业闭环。OpenAI认定马斯克旗下团队存在多次「蒸馏模型」的前科——即通过调用他人模型输出来训练自家模型——属于违反服务条款的行为。
所谓「模型蒸馏」(Model Distillation),是机器学习领域中一种知识迁移技术,最早由Geoffrey Hinton等人在2015年提出。Hinton被誉为「深度学习之父」,2024年获得诺贝尔物理学奖。他与Jeff Dean等人在2015年发表的论文《Distilling the Knowledge in a Neural Network》奠定了知识蒸馏技术的理论基础。其核心原理是利用一个已经训练好的大型「教师模型」的输出结果(包括概率分布等软标签信息),来指导训练一个规模更小的「学生模型」。蒸馏的关键创新在于利用教师模型输出的「软标签」——即对所有类别的概率分布,而非仅仅是最终答案——软标签中包含了类别间相似性等丰富的「暗知识」(dark knowledge),学生模型通过学习这些分布信息,能以远小于教师模型的参数规模达到接近的性能水平。在合法场景下,蒸馏是一种高效的模型压缩手段。但在商业竞争中,如果一方未经授权大量调用对手的API接口,将返回结果作为训练数据来训练自家模型,则本质上是在窃取对方模型中凝结的知识产权——这正是OpenAI指控马斯克团队的核心争议所在。这一指控背后,实质上是两大AI阵营长期竞争关系的集中爆发。
值得玩味的是,Cursor方面对此毫不畏惧。其CEO直接回怼称,OpenAI模型仅占Cursor约5%的用户流量,主力早已切换到Anthropic的Claude系列以及自研模型,断供并不会造成实质影响。
Anthropic成立于2021年,由前OpenAI研究副总裁Dario Amodei和Daniela Amodei兄妹联合创办,是OpenAI最直接的竞争对手。公司以「AI安全」为核心理念,开发了Claude系列大语言模型。Claude在代码生成、长文本理解和指令遵循等方面表现尤为突出,这使其在编程工具领域获得了开发者的高度认可。Cursor CEO的这一表态揭示了一个行业现实:在AI编程工具这一垂直赛道,Claude已经建立起相当稳固的领先地位。截至目前,Anthropic已获得Google、亚马逊等巨头超过百亿美元的投资,技术和商业护城河持续加深。
竞争对手趁势入场与舆论交锋
Anthropic随即表态将继续加大Claude在Cursor中的算力支持,颇有「趁虚而入」的意味。马斯克本人也亲自下场,公开指责OpenAI CEO奥特曼「不值得信任」,并反咬对方才是真正窃取OpenAI资产与技术的人。
这场口水战,本质上反映了当前顶级AI公司在商业化落地阶段的白热化竞争。当模型能力逐渐趋同——GPT-4、Claude、Gemini等顶级模型在基准测试中的差距日益缩小——决定商业胜负的关键因素不再是单纯的模型能力,而是谁能占据更多的应用入口和用户触点。Cursor作为日活跃开发者数以百万计的高频工具,本质上是一个极具价值的分发渠道。控制了工具入口,就控制了模型调用量、用户数据反馈和商业化收入。谁能绑定更多的应用入口——比如Cursor这类高频开发工具——谁就能在生态战争中占据主动,这正是各方争夺如此激烈的根本原因。
国产AI模型集体转向开源平价
与海外阵营的激烈内斗形成鲜明对比,本周国内AI模型圈呈现出「百花齐放」的态势,且方向高度一致——开源与平价。
阿里巴巴开源了千问(Qwen)3.8 Flash Next模型,并提前披露了千问4的全新架构信息,展现出持续的技术迭代能力。千问系列是阿里旗下通义实验室开发的大语言模型家族,自2023年首次发布以来已迭代多个版本,覆盖从轻量级Flash到全尺寸大模型的完整产品线。阿里选择将千问系列在Apache 2.0等宽松许可协议下开源,使其成为全球开源模型社区中最活跃的中国力量之一。千问4提前披露的「全新架构」尤为值得关注——Transformer架构由Google团队在2017年的论文《Attention Is All You Need》中提出,其核心创新是自注意力机制(Self-Attention),能够并行处理序列中任意位置之间的依赖关系。此后,GPT、BERT、LLaMA等几乎所有主流大语言模型都建立在Transformer基础之上。然而,Transformer的二次方计算复杂度在处理超长上下文时面临效率瓶颈。近年来,Mamba(基于状态空间模型SSM)、RWKV(融合RNN与Transformer优势)等替代架构不断涌现。千问4如果在架构层面有所突破,可能涉及线性注意力、混合架构或全新的序列建模范式,任何架构层面的创新都可能带来效率和能力的跃升,这也是观察国产模型能否实现技术突破的重要窗口。
此前在社区爆火的神秘模型「牛来」也终于揭开身份——正是智谱的GLM-5.3 Flash。智谱AI由清华大学计算机系知识工程实验室孵化,是国内最早一批布局大模型的创业公司,其GLM(General Language Model)系列采用独特的自回归填空训练范式,在中英文理解与生成任务中表现出色。GLM-5.3 Flash以「牛来」的匿名身份在社区流传并引发热议,说明其在盲测环境下已获得用户的高度认可。该模型能力对标Anthropic的Opus 4.8,但调用成本仅为对方的几十分之一——这种极端的成本优势体现了国产模型通过工程优化大幅降低推理成本的技术实力。其中,混合专家架构(Mixture of Experts, MoE)是降低推理成本的关键技术之一,其核心思想是将模型拆分为多个专家子网络,每次推理时通过门控网络(Gating Network)只激活其中少量专家,从而在保持总参数量不变的前提下,大幅减少每次推理的实际计算量。例如,Mixtral 8x7B模型虽有约46.7B总参数,但每次推理仅激活约12.9B参数。结合INT4/INT8量化推理(将模型权重从32位浮点压缩为4位或8位整数)、推测解码(Speculative Decoding)、PagedAttention等技术,国产模型得以实现极致的推理效率优化。
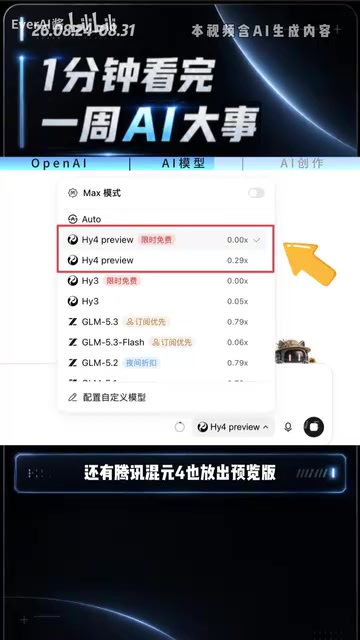
此外,腾讯的混元4也放出了预览版本。整体来看,国产赛道正在集体朝着「开源+平价」的方向演进,这对广大开发者而言无疑是重大利好。
平价策略背后的战略考量
国产模型选择开源平价路线,并非单纯的价格战。一方面,通过开源降低使用门槛,能够快速积累开发者生态和应用场景,形成技术反哺——开发者在实际使用中产生的反馈数据和应用创新,反过来推动模型持续优化迭代;另一方面,在成本上做到海外顶级模型的几十分之一,意味着大量对成本敏感的中小企业和创业团队将获得可负担的AI能力。
当GLM-5.3 Flash这类模型能以极低成本提供接近Opus级别的能力时,AI应用的商业化门槛将被大幅拉低。过去只有资金充裕的大型企业才能负担得起的顶级模型调用费用,如今中小团队也能轻松接入,这将极大释放AI应用层的创新活力。这种「能力对标、成本碾压」的打法,可能成为国产模型在全球竞争中弯道超车的关键路径。
AI创作工具迎来多点突破
除了大语言模型的密集更新,本周AI创作工具领域同样进展显著。
谷歌的Gemini Omni 1.1 Flash视频模型正式上线。只需给它看10秒的开头画面,模型就能自然地续写后续剧情。这种视频续写能力,标志着生成式AI在视频创作领域从「片段生成」向「连贯叙事」的重要进化。传统的AI视频生成工具(如Runway Gen系列、Pika等)主要依赖文本描述或单帧图像来生成短视频片段,各片段之间往往缺乏叙事连贯性。而视频续写要求模型不仅理解画面内容,还需把握运动轨迹、物理规律、角色行为逻辑和故事发展脉络,本质上是对「世界模型」能力的考验。「世界模型」(World Model)概念由Yann LeCun等人推广,指的是AI系统对物理世界运行规律的内在理解和模拟能力。在视频生成领域,世界模型要求AI不仅能生成视觉上逼真的画面,还需理解重力、碰撞、流体运动等物理规律,以及人类行为的因果逻辑。OpenAI的Sora、Google的Veo等模型都在朝这个方向努力。Gemini Omni 1.1 Flash的视频续写能力本质上是在有限信息下进行时序推理——根据10秒画面推断场景语义、运动趋势和叙事意图,然后在保持物理一致性的前提下生成后续帧,这对模型的时空理解能力提出了极高要求。这项技术一旦成熟,将深刻改变影视预制作、短视频内容生产和游戏过场动画等领域的创作流程。
话说回来,AI会议工具Meet Jamie推出了图像编辑模型,用户通过对话即可完成修图操作。这类「对话式修图」进一步降低了图像编辑的技术门槛,让普通用户也能轻松完成过去需要Photoshop等专业软件才能实现的操作。从技术角度看,对话式修图背后涉及多项前沿AI技术的协同工作。首先,大语言模型需要准确理解用户的自然语言修图意图(如「把背景换成海滩」),并将其转化为结构化的编辑指令。然后,图像分割模型(如Meta的SAM——Segment Anything Model)负责精确识别和分离图像中的目标区域。最后,局部重绘技术(Inpainting)基于扩散模型(Diffusion Model)在指定区域生成符合上下文语义的新内容。这一流程将传统图像编辑中需要手动操作图层、蒙版、笔刷等复杂步骤,压缩为一句自然语言描述,代表了人机交互方式从「学习工具」到「描述意图」的范式转变。
分裂与融合并存的AI产业格局
综合本周动态,全球AI产业正呈现出一种耐人寻味的双重格局:海外顶级公司在商业利益与阵营站队中日趋分裂,OpenAI与马斯克的决裂只是冰山一角;而国内模型圈则在开源平价的共识下加速融合,形成对开发者更加友好的生态环境。
对于开发者和企业用户而言,这种格局意味着更多的选择空间。无论是绑定Claude的编程工作流,还是采用GLM、千问等平价国产模型,抑或尝试谷歌的多模态创作工具,AI能力的普惠化趋势已经不可逆转。接下来值得关注的是,随着千问4等新架构的落地,国产模型能否在能力上真正追平乃至超越海外第一梯队。当技术差距持续缩小而成本优势显著扩大,全球AI产业的竞争天平,或许正在悄然发生倾斜。
核心要点
核心要点
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。