OpenAI命名逻辑揭秘:模型代号与版本号背后的规则
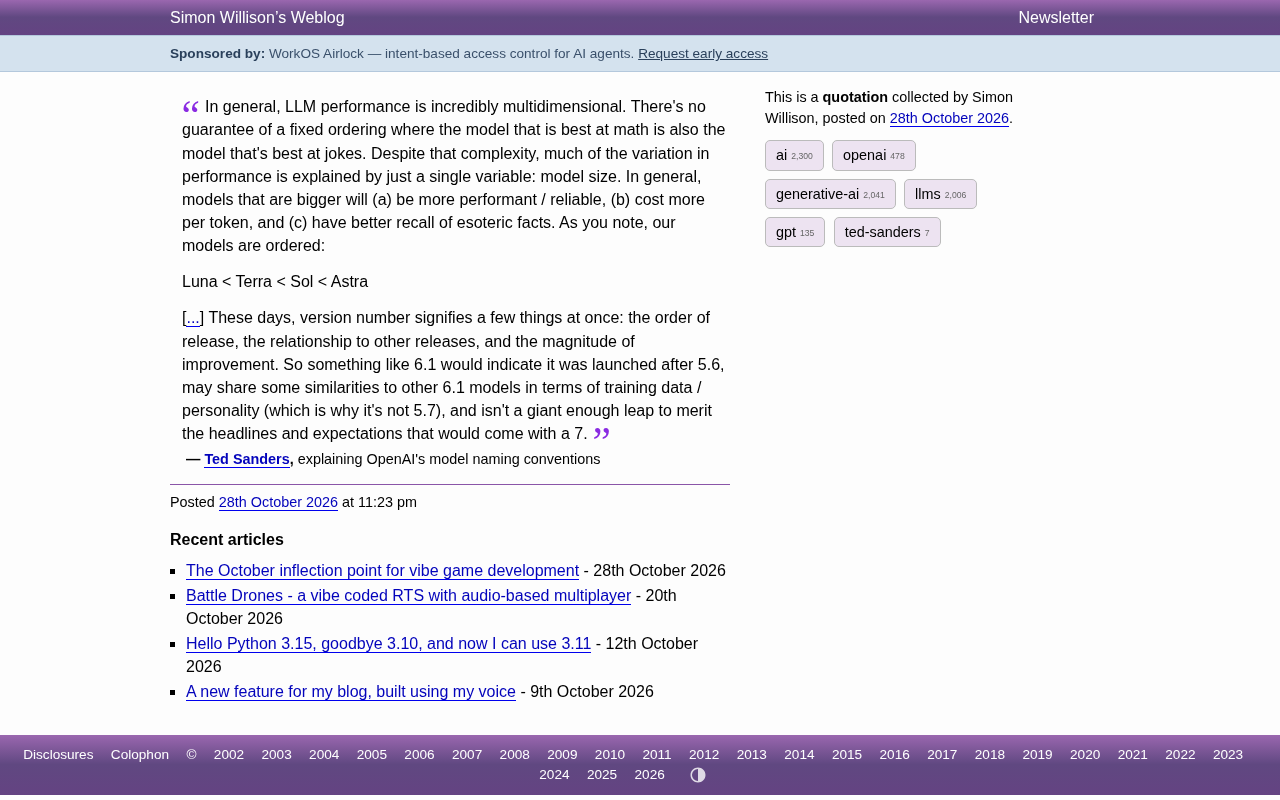
OpenAI 模型命名逻辑:规模主导能力,版本号编码发布顺序、家族关系与改进幅度。
本文基于 Ted Sanders 在 Hacker News 上的解释,梳理了 OpenAI 模型命名体系的逻辑。文章指出,尽管 LLM 性能是极其多维的,但模型规模是解释性能差异的主要变量,这体现为内部有序代号 Luna < Terra < Sol < Astra。公开版本号(如 6.1、5.6)则同时承载三重含义:发布顺序、与其他版本的关系以及改进幅度。这种命名方式既服务于内部产品管理,也用于管理用户对升级幅度的预期,避免对小幅迭代产生不切实际的期待。文章认为,清晰的命名规则有助于开发者和企业用户准确评估模型升级的实际影响,也为行业命名实践提供了可借鉴的透明视角。
OpenAI 的模型命名体系一直是开发者和用户热议的话题。从 GPT-4 到 GPT-4o,再到各种内部代号,这些名字究竟如何确定?Ted Sanders 在 Hacker News 上的一段解释,为我们揭开了这套命名逻辑的面纱。
模型能力由规模主导,但并非单一维度
Ted Sanders 指出,LLM 的性能是“极其多维的”。没有固定的排序能保证在数学上最强的模型同时也在讲笑话上最强。然而,尽管存在这种复杂性,性能的很大一部分变化可以由一个变量解释:模型规模。
一般来说,更大的模型会(a)表现更好、更可靠,(b)每 token 成本更高,(c)对冷门事实的召回更好。这解释了为什么 OpenAI 会用一套有序的代号来区分模型等级:Luna < Terra < Sol < Astra。
这一观点与业界对缩放定律(Scaling Law)的普遍认知一致,但 Sanders 强调了“多维性能”与“单变量主导”之间的张力,提醒我们不要简单地将规模等同于全面优势。
缩放定律(Scaling Law) 是理解大模型能力演进的核心经验规律。它指出,随着模型参数量、训练数据量和计算量的增加,模型的损失(loss)会按幂律下降,且这种趋势在多个数量级上保持稳定。这意味着规模扩展本身就能带来可预测的性能提升,而不必依赖架构上的重大突破。OpenAI 在 GPT-2、GPT-3 等工作中系统验证了这一规律,并将其作为模型研发路线规划的基础。不过,缩放定律描述的是平均意义上的损失下降,并不保证每一项具体能力都同步提升——这正是 Sanders 强调“多维性能”与“单变量主导”存在张力的原因。理解缩放定律有助于解释为何模型等级会用有序代号区分:规模档位本身就是能力分层的主要依据。
版本号的三重含义
除了内部代号,公开的版本号(如 6.1、5.6)也承载了丰富信息。Sanders 解释,版本号同时表示三件事:
- 发布顺序:6.1 在 5.6 之后推出。
- 与其他版本的关系:6.1 可能与其它 6.1 模型在训练数据或“性格”上相似,这也是它不叫 5.7 的原因。
- 改进幅度:6.1 的提升幅度不足以支撑 7 所带有的头条期望。
换句话说,版本号不是简单的线性递增,而是对发布节奏、模型家族归属和升级量级的综合编码。这种命名方式既方便内部管理,也向外界传递了关于模型迭代节奏的信号。
语义化版本(Semantic Versioning) 是软件工程中常见的版本编号约定,通常采用“主版本号.次版本号.修订号”的形式,分别对应不兼容的重大变更、向后兼容的功能新增和问题修复。OpenAI 的版本号(如 6.1、5.6)虽然形式相似,但语义并不完全相同:它不严格遵循“主版本号变更即不兼容”的规则,而是把发布顺序、模型家族归属和改进幅度压缩进数字中。这种做法的好处是简洁且便于传播,代价是外部用户难以仅凭数字判断升级的具体内容。对比来看,传统软件版本号主要服务于依赖管理,而大模型版本号还承担了营销预期管理的功能,这是模型产品区别于普通软件的一个显著特征。
命名背后的产品思维
从 Luna 到 Astra 的代号体系,以及版本号的三重语义,反映出 OpenAI 在模型产品化上的精细考量。一方面,有序代号让不同规模档次的模型一目了然;另一方面,版本号的设计兼顾了营销预期管理——避免用户对小幅升级产生不切实际的期待。
对于开发者和企业用户而言,理解这套命名逻辑有助于更准确地评估模型升级带来的实际影响,而不是被版本数字迷惑。
预期管理(Expectation Management) 在产品发布中指通过信息设计引导用户形成与实际情况相符的预期,避免因过度期待或信息不对称导致失望。在 AI 模型领域,这一点尤为重要:用户往往会把版本号的数字跃升直接等同于能力跃升,从而对小幅迭代产生不切实际的期待。OpenAI 通过控制版本号的跳变幅度(例如将改进有限的版本命名为 6.1 而非 7),实际上是在向市场传递“这次升级是渐进式的”这一信号。类似的做法也见于其他软件产品,如 Chrome 浏览器曾长期保持主版本号快速增长以强调持续更新,而一些企业软件则刻意放缓主版本号以传递稳定性。命名因此不仅是技术标识,也是一种产品沟通策略。
对行业命名实践的启示
OpenAI 的做法并非孤例,但它的透明解释值得借鉴。在模型能力日益复杂、发布节奏加快的背景下,清晰的命名规则可以减少沟通成本,也能帮助用户建立合理的性能预期。Sanders 的这段分享,为外界理解大模型产品的迭代逻辑提供了一个难得的内部视角。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
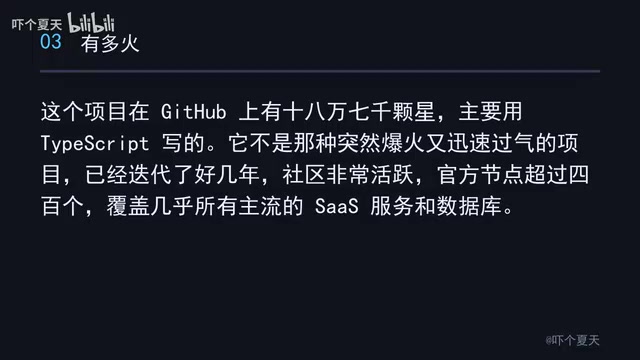
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
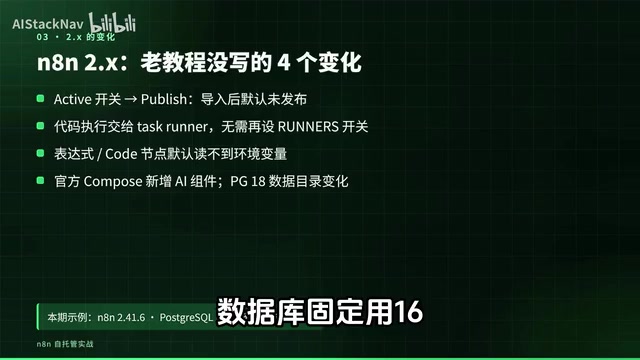
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。