OpenAI推出GPT-6 Sol与Luna:更低成本、更少错误
OpenAI推出GPT-6双模型Sol与Luna,主打低成本与低错误率,延续Astra技术路线。
OpenAI发布GPT-6 Sol与Luna两款新模型,官方强调二者与此前Astra系列同源,核心卖点为更低的使用成本与更少的推理错误。双模型策略暗示两者可能承担差异化的场景定位——一款面向高性能复杂任务,另一款面向轻量化高吞吐需求。这一定位精准切中当前大模型落地的两大痛点:成本过高制约了中小团队的规模化应用,而幻觉与推理错误则削弱了模型在生产环境中的可信度。目前定价、基准测试、上下文窗口等关键细节尚未披露,实际竞争力有待进一步验证。
OpenAI发布GPT-6双模型Sol与Luna
OpenAI宣布推出两款全新模型——GPT-6 Sol与Luna,官方称二者与此前的Astra系列同源("cut from the same cloth as Astra")。根据现有信息,这两款模型主打两大核心卖点:更低的使用成本与更少的推理错误。
对开发者和企业用户而言,这两个方向恰好切中当前大模型落地的两大痛点。成本一直是限制大模型规模化应用的关键因素,而幻觉与推理错误则直接影响模型在生产环境中的可信度。OpenAI将两者同时作为宣传重点,反映出其产品策略正从单纯的性能竞赛,转向更务实的"性价比+可靠性"平衡。
Sol与Luna定位差异的初步解读
从命名来看,Sol(太阳)与Luna(月亮)暗示了两款模型可能承担不同的角色定位。虽然官方尚未披露详细的技术参数和分工,但采用双模型策略在业界已有先例——通常一款侧重高性能、复杂任务处理,另一款侧重轻量化、高吞吐、低延迟的日常场景。
这种分层设计有助于用户根据实际需求选择合适的模型,避免"大炮打蚊子"式的算力浪费。如果Sol与Luna确实遵循这一逻辑,那么它们的组合将为不同预算和场景的用户提供更灵活的选择空间。
与Astra同源意味着什么
OpenAI强调新模型与Astra"同源",这一表述值得关注。它暗示Sol与Luna并非全新架构的产物,而是在既有技术基础上的延续与优化。这种迭代式的演进路径通常意味着更成熟的稳定性和更可控的训练成本,这也可能是官方敢于宣称"更低成本"的技术底气所在。
对于持续追踪OpenAI产品线的观察者来说,从Astra到GPT-6 Sol、Luna的脉络,反映出该公司在保持技术连续性的同时,通过精细化调优来降低边际成本、提升输出质量的整体思路。
需要指出的是,"Astra"在OpenAI语境下指的是其内部代号为Project Astra的下一代多模态AI系统研究方向(该名称也与Google DeepMind的Project Astra存在一定混淆,后者是谷歌的实时多模态助手项目)。OpenAI的Astra系列被认为是GPT-4之后在推理架构和多模态融合上的阶段性成果。"与Astra同源"这一表述,在技术层面意味着Sol与Luna可能共享相同的基础预训练权重或核心架构设计,只是在后训练阶段(如RLHF、微调策略、推理时计算分配等方面)针对成本和准确性进行了专项优化,而非从头训练全新模型。这种"同底座、差异化后训练"的思路在业界已相当普遍,OpenAI此前的GPT-4o与GPT-4o mini也体现了类似的产品分层逻辑。
更低成本与更少错误的行业意义
如果OpenAI的宣称能够兑现,GPT-6 Sol与Luna的发布将对整个AI应用生态产生实质影响。成本下降意味着更多中小团队和个人开发者能够负担得起先进模型的调用,从而催生更丰富的应用形态。而错误率的降低,则直接提升了模型在客服、编程辅助、内容生成等对准确性敏感场景中的可用性。
不过,目前公开信息仍然有限,具体的定价策略、基准测试成绩、上下文窗口、多模态能力等关键细节尚待官方进一步披露。这些数据将最终决定Sol与Luna在激烈的大模型竞争格局中的真实竞争力。
大模型的"幻觉"(Hallucination)问题是指模型以高置信度生成看似合理但实际上不准确或凭空捏造的内容,是当前制约LLM在高风险场景落地的核心挑战之一。推理错误则更广泛地涵盖逻辑链断裂、数学计算失误、多步推导偏差等问题。近年来,业界通过强化学习、思维链提示(Chain-of-Thought)、过程奖励模型(PRM)等手段持续攻克这一难题,OpenAI的o系列模型也正是在"慢思考"推理方向上的重要尝试。GPT-6 Sol与Luna若能在降低成本的同时兑现更低错误率的承诺,意味着其在推理时计算效率与输出质量之间取得了更优的帕累托平衡,这对法律、医疗、金融等对准确性有严苛要求的垂直行业而言具有直接的商业价值。
小结
GPT-6 Sol与Luna的推出,延续了OpenAI在模型迭代上的一贯节奏,并以"低成本、少错误"作为差异化卖点。这一定位精准回应了当前市场对高性价比、高可靠性AI模型的需求。在更多技术细节公布之前,其实际表现仍需观察,但双模型策略与成本导向的方向,无疑值得开发者和企业持续关注。
相关推荐
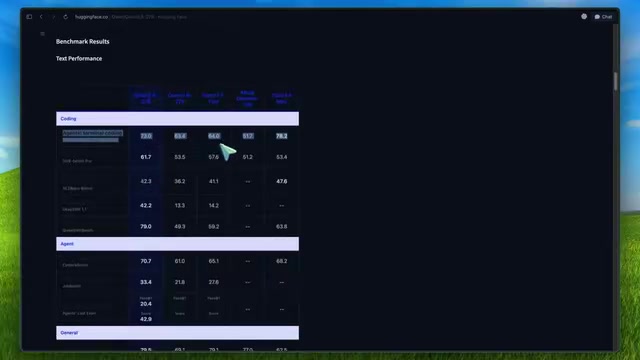
Qwen3 27B本地实测:小模型智能体能力反超Opus旗舰
海外博主深度实测Qwen3 27B本地开源模型,在SWE-bench Pro、OS World等智能体任务上反超Opus旗舰闭源模型。本文详解其架构特性、部署方案(Ollama/LM Studio)及与Hermes Agent组合的本地智能体栈搭建。
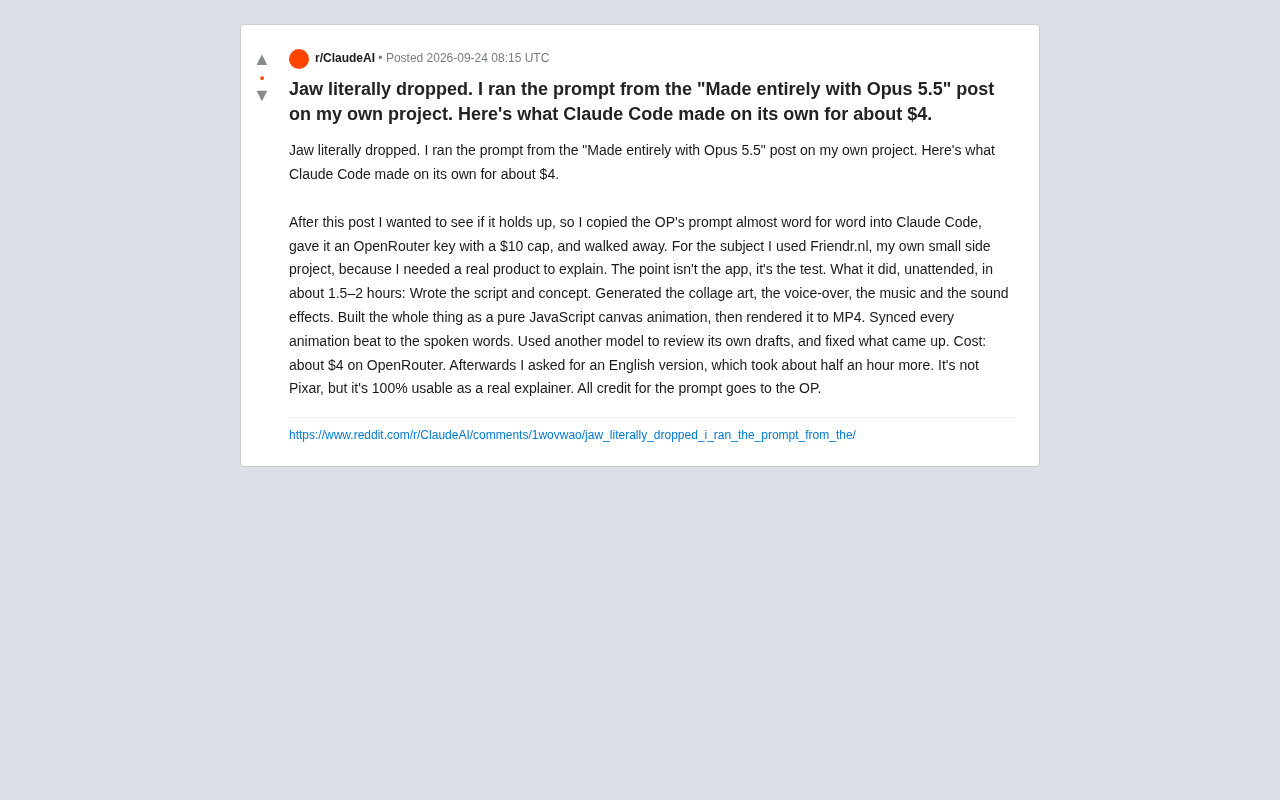
用4美元让Claude Code自主造出解说视频:一次无人值守实测
一位Reddit用户实测Claude Code:仅花约4美元、无人值守1.5-2小时,AI就自主完成了从脚本、美术、配音到动画同步渲染的完整解说视频。本文解析这场实验背后的Agent多模态编排能力与成本变革。
Agentic SOAR vs 传统SOAR加聊天机器人:安全响应的真实差异
Agentic SOAR 与传统 SOAR 外挂 LLM 聊天机器人有何本质区别?本文剖析智能体是否真正改变了安全事件响应中剧本的执行逻辑,并给出辨别厂商话术的实用方法。