OpenAI宣称攻克纳维-斯托克斯难题引质疑:功劳归属谁?
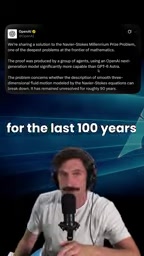
OpenAI被传用万级智能体攻克百年数学难题,但声明来源存疑,归属争议折射AI伦理痛点。
一段YouTube视频引发数学界与公众热议:OpenAI被称以1万个智能体、耗时88小时攻克悬赏百万美元的纳维-斯托克斯千禧年难题。然而该声明仅来自单一带有批判立场的视频,既未经同行评审,也未获克雷数学研究所认可,真实性存疑。更大的争议在于归属问题——大量评论质疑成果建立在数学家Tristan Buckmaster多年研究之上却未予署名,将矛头指向AI行业在知识产权与贡献透明度上的系统性缺陷。文章提醒读者,判断此类"AI攻克难题"的声明,需审视证据链完整性、成果归属透明度与信息来源权威性,在权威机构给出确认前保持理性怀疑。
一则震动数学界的声明
一段YouTube视频引发关注:OpenAI对外宣称,其AI系统攻克了被列为千禧年七大数学难题之一的**纳维-斯托克斯方程(Navier-Stokes)**问题。这一难题悬赏100万美元奖金,困扰人类超过一个世纪,涉及流体运动的数学描述,长期被视为前沿数学中最棘手的挑战之一。
视频中提到的操作细节相当夸张:据称OpenAI调用了1万个智能体(agents)、耗时88小时完成求解,整体算力成本可能超过1000万美元。若属实,这将是AI在纯数学证明领域的一次标志性突破。
需要说明的是,本文素材来自单一YouTube视频,且视频本身带有明显的批判与戏谑色彩。截至目前,这一"求解"声明的真实性、是否经过同行评审、是否获得克雷数学研究所(Clay Mathematics Institute,千禧年难题的设立方)认可,均缺乏独立佐证。读者应将其视为有待验证的争议性传闻,而非已被数学界确认的事实。
纳维-斯托克斯方程由19世纪数学家克劳德-路易·纳维与乔治·加布里埃尔·斯托克斯分别独立建立,用于描述黏性流体(如空气、水)的运动规律。方程本身早已存在且被广泛应用于气象预报、航空工程和海洋模拟,但其数学基础至今存在根本性缺口:在三维空间中,方程的光滑解是否始终存在、是否可能在有限时间内"爆炸"(即产生奇点),仍是未解之谜。克雷数学研究所于2000年将其列为七大"千禧年大奖难题"之一,悬赏100万美元。值得注意的是,此前唯一被解决的千禧年难题是庞加莱猜想,由俄罗斯数学家格里戈里·佩雷尔曼于2003年证明,他本人拒绝了奖金。这一背景说明,即便真有突破,从提出解法到获得学界认可,通常需要数年严格审查。
争议焦点:功劳到底属于谁
视频真正的看点不在于"solved"这个词,而在于随之而来的舆论反弹。评论区大量用户质疑:这项成果是否建立在数学家Tristan Buckmaster多年研究的基础之上。
批评者的核心诉求很直接——要求为那位"花了数年时间寻找解法"的研究者正名。有评论措辞激烈:"OpenAI窃取了他的工作""如果你请得起律师,剽窃就没问题了吗?"这类声音把矛头指向了当下AI行业一个反复出现的伦理痛点:AI系统的产出往往依赖前人积累的研究成果与数据,而这些贡献者的署名权、知识产权归属却常常被模糊化甚至抹去。
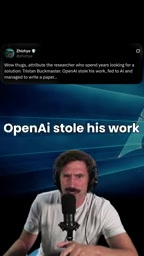
无论OpenAI是否真的"解决"了这道难题,公众的第一反应是追问训练数据与理论基础的来源,这本身就折射出社会对AI公司在成果归属问题上的普遍不信任。
Tristan Buckmaster是普林斯顿大学与纽约大学柯朗研究所的数学家,长期专注于流体力学方程的数学分析,尤其在纳维-斯托克斯方程的弱解与奇点问题上有重要贡献。他与合作者Vlad Vicol于近年发表的研究探讨了欧拉方程与纳维-斯托克斯方程中解的不唯一性与不稳定性,在数学界引发广泛关注。AI公司若在训练或推理过程中大量使用了此类尚未完全公开或授权的学术手稿、预印本,而在成果发布时未予说明,便触及学术界对"数据洗白"(laundry of intellectual contributions)的核心担忧——即人类研究者的原创贡献被隐没在模型的黑箱之中,最终署名权归于AI系统及其开发商。
"我没有在欺骗你":一段耐人寻味的对话
视频结尾的一段对话颇具讽刺意味。当有人追问"等一下,我是不是被骗了?"时,回应是:"我没有任何要欺骗你的东西。当然,我没有骗你,我是把你当人看在交流。好了,聊得愉快。"
这段拟人化的、略显敷衍的回应,被视频作者用来强化整体的怀疑基调。它暗示:在缺乏透明信息披露的情况下,一句"我没骗你"恰恰无法消除公众的疑虑。这种叙事手法虽然主观,却精准捕捉到了当下AI宣传中一种典型的沟通困境——越是宏大的成果声明,越需要可核验的证据,而非语气上的保证。
如何理性看待这类"AI攻克数学难题"的消息
近年来,AI在数学领域的进展确实值得关注,但"攻克千禧年难题"这类说法需要格外审慎对待。几个判断维度可供参考:
证据链是否完整
真正解决千禧年难题需要严格的数学证明,并经过长时间的同行评审。克雷数学研究所有明确的评审流程,奖金发放需等待成果在权威期刊发表并被学界广泛接受后至少两年。任何绕过这一流程的"已解决"宣称都应打上问号。
克雷数学研究所的评奖流程极为严格:候选解法须首先在经同行评审的权威数学期刊正式发表,随后等待至少两年,由国际数学联合会(IMU)专家委员会独立核实,确认无误后方可颁奖。迄今为止,整个程序从未在两年内完成过。此外,"证明"在数学语境中有极为精确的含义:它必须是从公认公理出发、经逻辑严密推导的完整论证,不允许存在任何依赖计算近似或统计推断的跳跃。AI系统目前擅长的符号推导与模式匹配,与这一标准之间仍存在本质差距,这也是数学界对"AI证明"保持高度审慎的根本原因。
成果归属是否透明
AI系统若基于特定研究者的工作,应明确署名与致谢。围绕Tristan Buckmaster的争议提醒我们,成果的独创性与数据来源的合法性同样重要。
传播渠道是否权威
本文素材源自一段带有立场的YouTube视频,并非OpenAI官方发布或学术机构确认。信息层层转述的过程中,夸张与失真在所难免。
结语
这段视频与其说是在报道一项数学突破,不如说是在记录一场关于AI伦理、成果归属与信任的公众辩论。1万个智能体、88小时、100万美元奖金——这些抓人眼球的数字背后,真正悬而未决的问题是:当AI越来越多地参与知识创造,我们该如何界定谁做了什么、谁应该被记住。
在权威机构给出确认之前,对"Navier-Stokes已被攻克"这一说法,保持一份清醒的怀疑,或许是最负责任的态度。
相关推荐
Claude Code 新增 Mods 与 AGENTS.md 支持:深度解析
Anthropic 为 Claude Code 上线 Mods 插件机制与 AGENTS.md 支持,同时更新 Projects 重设计、后台电脑使用、Diff 面板及 Skills 评估工具。本文深度解析这轮更新的功能细节与实际价值。
DeepSeek Harness 开源:一切皆插件的 AI 智能体底座
DeepSeek Harness 正式开源,以「一切皆插件」为核心理念,底层内核架构支持模型、工具、界面全模块化,兼容 20 多家大模型服务,一行命令即可启动本地 Web 界面,为开发者提供大厂级 AI 智能体底座。
AI大模型学习路线全解析:从理论基础到Agent实战
AI大模型学习路线完整拆解:从Transformer理论基础,到PyTorch、Hugging Face框架,再到API调用、模型微调与Agent、LangChain进阶方向,帮零基础学习者理清入门到就业的清晰路径。