OpenVINO:开源AI推理优化部署工具包

OpenVINO 是英特尔开源的 AI 推理优化工具包,支持跨平台高效部署。
文章介绍了英特尔主导的开源 AI 推理优化工具包 OpenVINO。其核心价值在于跨平台推理优化,通过模型转换、图优化与硬件加速提升性能并保持精度,适用于英特尔 CPU、集成 GPU、VPU 及 ARM 架构。工作流分为模型转换、优化与部署三阶段,核心组件包括 Model Optimizer、Inference Engine、OpenVINO Runtime 和 Benchmark Tool。文章还介绍了其在计算机视觉、自然语言处理、边缘计算等场景的应用,以及 GitHub 上超过 11,000 星标、迭代频繁的活跃社区生态。
什么是 OpenVINO?
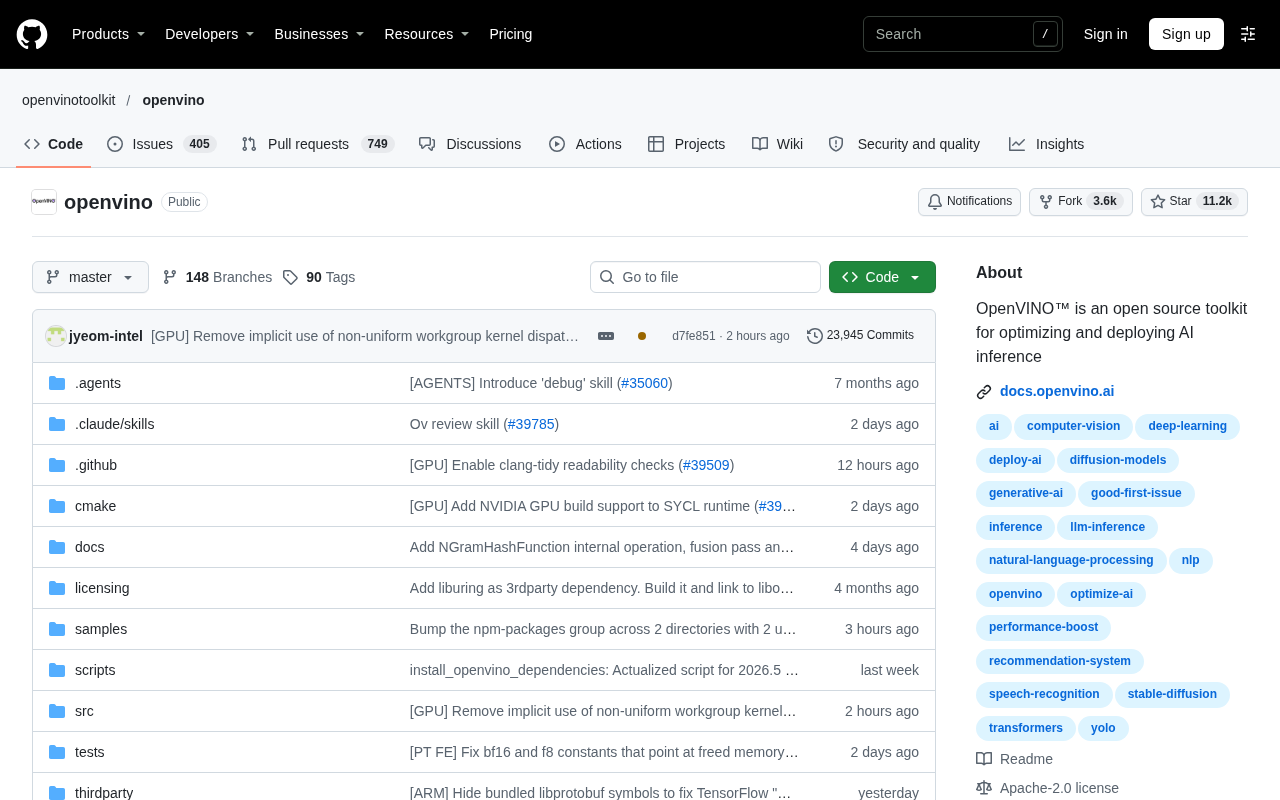
OpenVINO™ 是英特尔主导的开源工具包,专为优化和部署 AI 推理而设计。它支持从边缘设备到云端的多类硬件,帮助开发者将训练好的模型高效落地。根据 GitHub 数据,该项目已获得超过 11,000 颗星和 3,500 多次 fork,显示出活跃的社区关注度。
OpenVINO 的核心价值在于跨平台推理优化。它通过模型转换、图优化和硬件加速,显著提升推理性能,同时保持模型精度。对于需要在英特尔 CPU、集成 GPU 或 VPU 上部署 AI 应用的团队来说,OpenVINO 提供了一套完整的工具链。
核心功能与工作流
OpenVINO 的工作流通常包括模型转换、优化和部署三个阶段。开发者可以使用 Model Optimizer 将训练框架(如 TensorFlow、PyTorch)的模型转换为 OpenVINO 的 IR 格式,然后利用 Inference Engine 在目标硬件上执行推理。
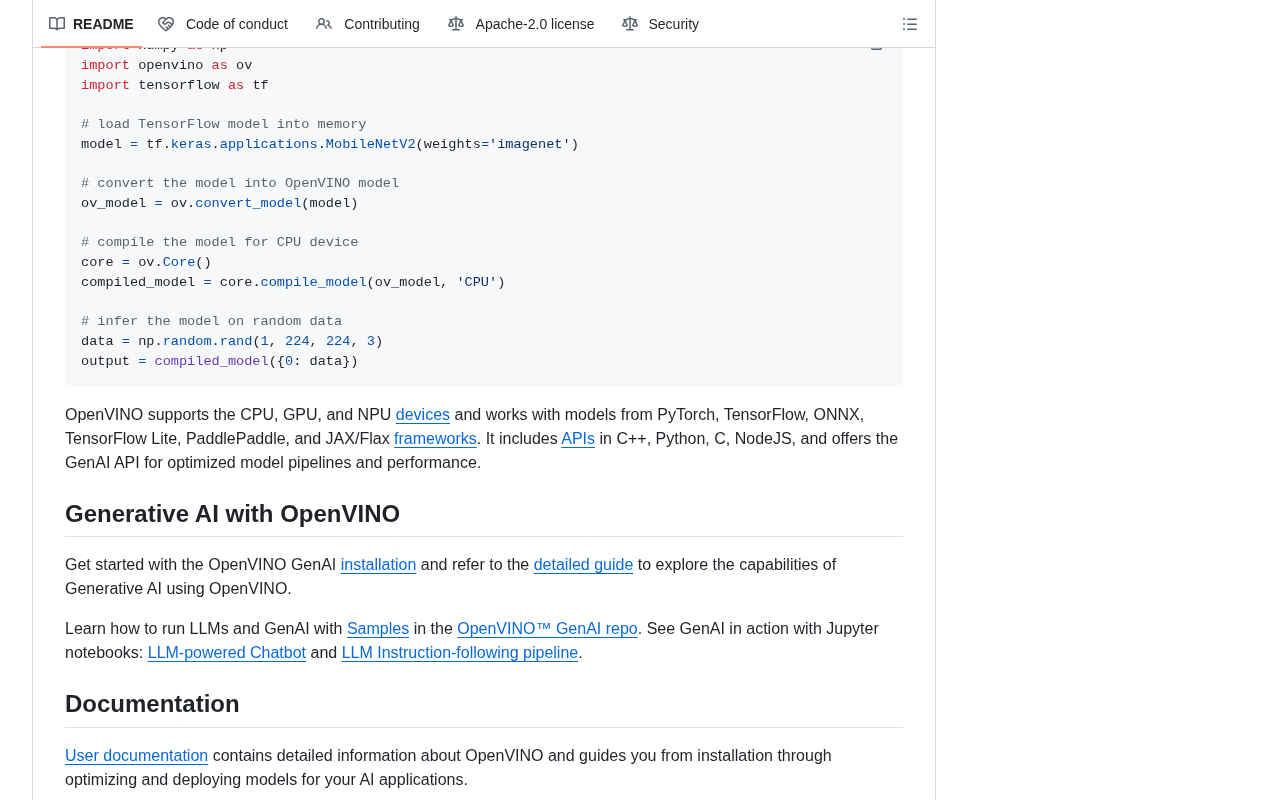
该工具包包含多个组件:
- Model Optimizer:将模型转换为 IR 格式,并进行图优化。
- Inference Engine:提供统一的 API,支持异构计算。
- OpenVINO Runtime:轻量级推理引擎,支持 Python、C++ 等语言。
- Benchmark Tool:用于性能评估和硬件调优。
这些组件协同工作,让开发者能够快速将模型部署到不同硬件平台,而无需深入底层细节。
IR(Intermediate Representation,中间表示) 是 OpenVINO 自有的模型格式,通常由 .xml(描述网络拓扑结构)和 .bin(存储权重)两个文件组成。将 TensorFlow、PyTorch、ONNX 等框架的模型转换为 IR 的意义在于:一方面剥离训练框架的运行时依赖,使推理环境更轻量;另一方面在转换过程中完成算子融合、常量折叠、精度校准等图级优化,让模型更贴合目标硬件的指令与内存布局。IR 还支持 FP32、FP16、INT8 等多种精度,开发者可借助训练后量化(PTQ)把模型压缩到低精度,在精度损失可控的前提下换取显著的吞吐提升。正因如此,IR 是理解 OpenVINO 工作流的关键枢纽——Model Optimizer 的产物与 Inference Engine / Runtime 的输入都以它为中心。
异构计算(Heterogeneous Computing) 指在同一系统中调度 CPU、集成 GPU、VPU、NPU 等不同类型的计算单元共同完成推理任务。OpenVINO 通过统一的 API 抽象了这些设备,开发者只需指定目标设备字符串(如 CPU、GPU、AUTO、MULTI:CPU,GPU),即可让运行时自动选择或并行使用硬件。其中 AUTO 模式会根据模型与设备状态挑选最合适的执行单元,MULTI 模式则把推理请求分发到多个设备以提高吞吐。这一机制的价值在于:不同硬件的擅长领域不同(CPU 通用性强、GPU 并行度高、VPU 能效比优),异构调度可以在不改动应用代码的前提下充分榨取整机算力,这也是 OpenVINO 跨平台适配能力的底层支撑。
应用场景与生态
OpenVINO 广泛应用于计算机视觉、自然语言处理、推荐系统等领域。在边缘计算场景中,它能够帮助设备实现低延迟、高能效的推理。例如,在智能摄像头、工业质检和医疗影像分析中,OpenVINO 可以显著提升处理速度。
此外,OpenVINO 与英特尔硬件深度集成,充分利用 CPU 的指令集和 GPU 的并行能力。同时,它也支持 ARM 架构和异构计算,增强了跨平台适应性。社区生态方面,OpenVINO 提供了丰富的示例代码、教程和预训练模型库,降低了开发者的入门门槛。
INT8 量化与训练后量化(Post-Training Quantization, PTQ) 是 OpenVINO 在边缘部署中常用的性能手段。边缘设备普遍受限于功耗、散热与内存带宽,FP32 模型往往难以满足实时性要求。OpenVINO 提供的 POT(Post-training Optimization Tool)与 NNCF(Neural Network Compression Framework)可以在少量校准数据上统计激活值分布,将权重与激活量化为 8 位整数,通常可获得数倍的推理加速并大幅降低内存占用。量化过程需要关注精度回退问题,常见做法是采用逐通道量化、混合精度(对敏感层保留 FP16)以及精度感知的逐层对比。理解量化机制有助于判断 OpenVINO 在智能摄像头、工业质检等低延迟场景中的实际收益边界。
社区与开发动态
作为开源项目,OpenVINO 在 GitHub 上保持活跃更新。当前仓库显示有 11,206 颗星和 3,573 次 fork,并且今日新增 18 颗星,表明项目持续受到关注。项目采用 C++ 作为主要开发语言,同时提供 Python 绑定,方便不同背景的开发者使用。
OpenVINO 的贡献者来自英特尔及外部社区,版本迭代频繁,不断加入对新模型和新硬件的支持。对于想要参与开源贡献的开发者,可以从文档改进、示例补充或问题修复入手。
总结
OpenVINO 是一个功能全面、生态成熟的 AI 推理优化工具包,特别适合在英特尔硬件上部署高性能推理应用。其开源属性和活跃社区为开发者提供了可靠的支持。无论是边缘设备还是云端部署,OpenVINO 都能帮助团队缩短从模型到产品的路径。
相关推荐

Zed编辑器发布v1.29.2:一次常规版本迭代的观察
Zed编辑器发布v1.29.2补丁版本,由@JosephTLyons完成版本升级,提交经GitHub签名验证。本文梳理该版本的基本信息、补丁版本的含义以及对用户升级的实际建议。

Anthropic IPO遭质疑:Hacker News热议其上市时机
Hacker News出现「Just say no to Anthropic's IPO」帖子,引发对Anthropic上市时机与AI公司资本化的讨论,涉及估值泡沫与使命独立性等议题。

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。