OpenWhispr for iOS:开源免费的端侧转录工具

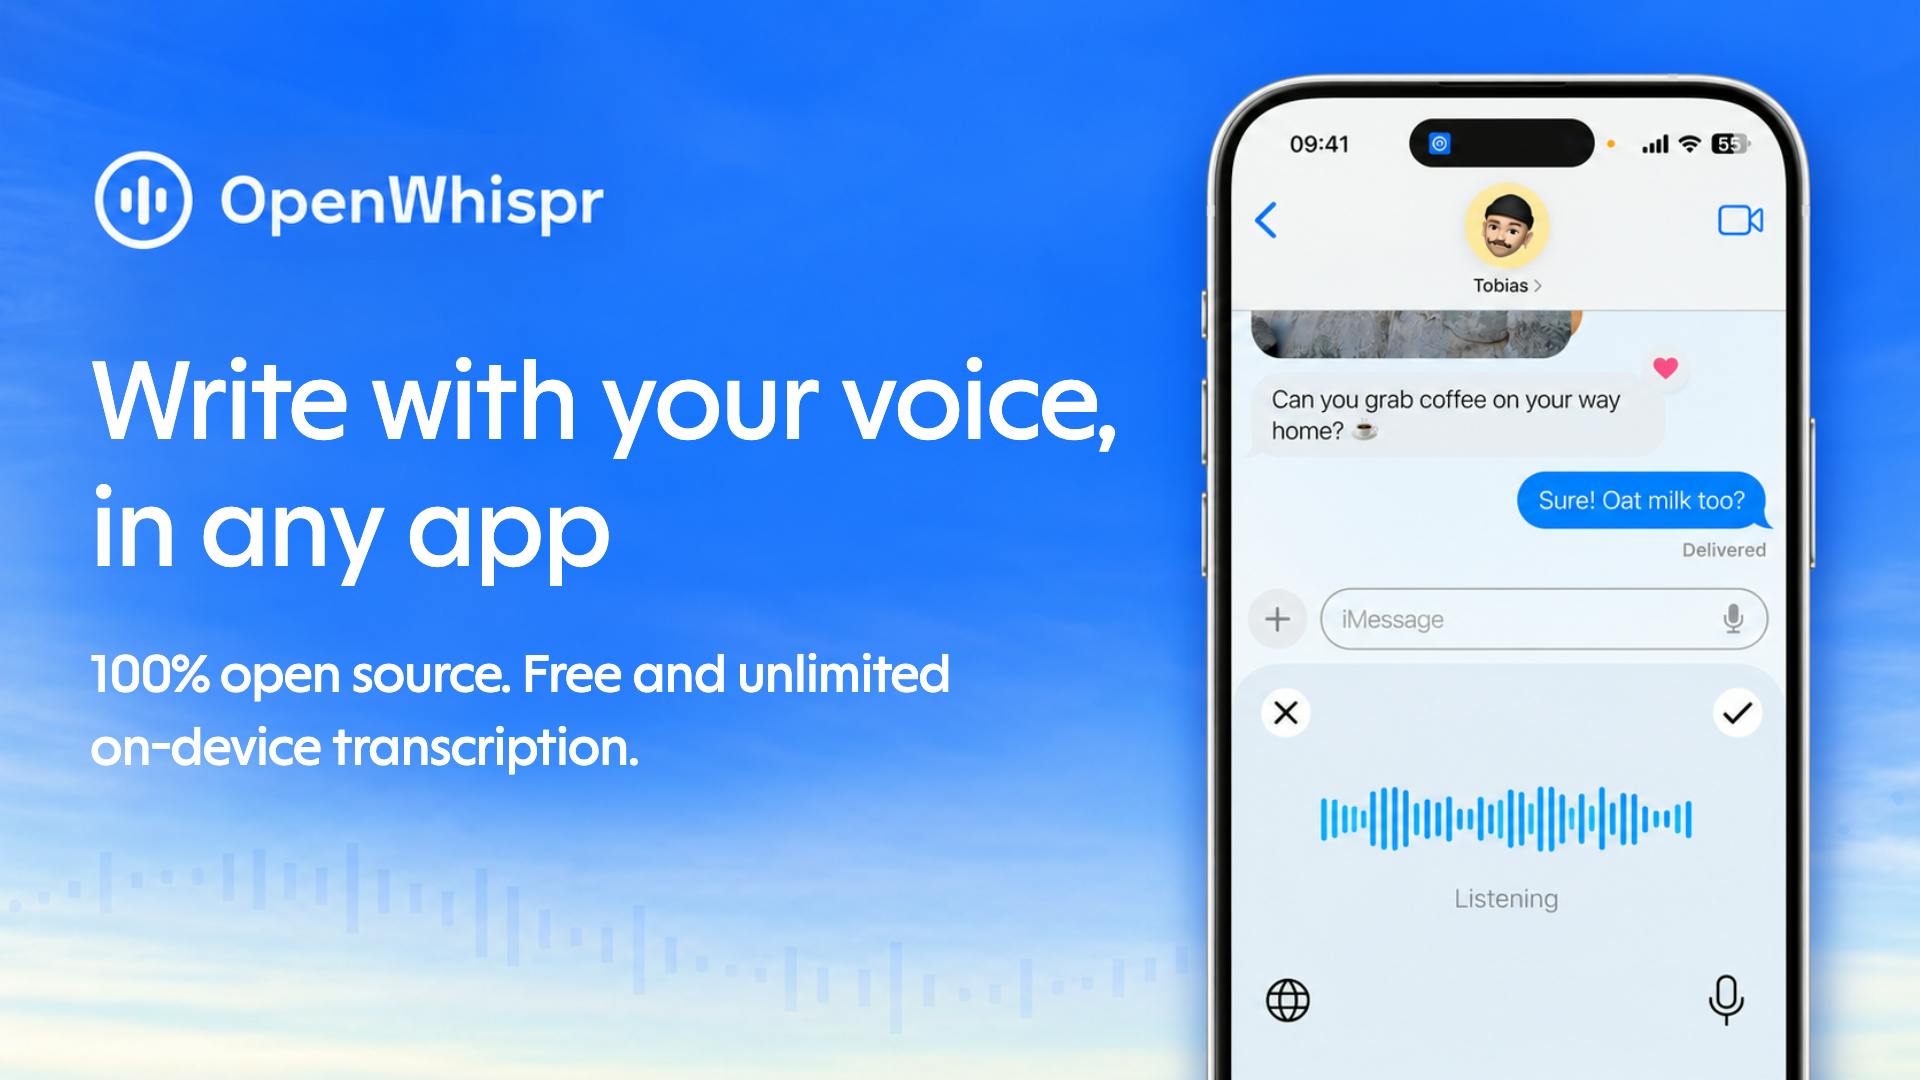
OpenWhispr 是一款 100% 开源、完全在设备端转录的 iOS 应用,免费无限制并支持自带 API Key。
OpenWhispr 是一款在 Product Hunt 上获得关注的 iOS 语音转录应用,核心卖点是 100% 开源、免费且完全在设备端完成转录,音频无需上传云端。它针对主流云端方案带来的隐私让渡和持续付费问题,采用本地模型实现离线转录,不设次数限制、无需账号。同时提供本地、可选云端和自带 API Key 三种模式,让用户在隐私与性能间自主取舍。开源带来可验证性、可定制性和可持续性。目前热度一般,端侧体验取决于设备芯片和模型大小,但为隐私敏感用户提供了一个可运行的开源选项。
当语音转录不再需要上传云端
在隐私意识和离线需求同步增长的当下,一款名为 OpenWhispr 的 iOS 应用在 Product Hunt 上引起了关注。它的核心卖点非常直接:100% 开源、免费、完全在设备端完成转录。
这意味着用户对着 iPhone 或 iPad 说话时,音频不需要上传到任何服务器,转录过程在本地完成,不设使用次数上限,也不需要注册账号或订阅付费。
它解决的是什么问题
主流语音转文字方案大都依赖云端:录音上传、服务器推理、结果返回。这条链路带来两个隐性成本——隐私让渡和持续付费。
OpenWhispr 选择把模型直接跑在手机上。用户只需下载一次模型,之后即便离线也能转录。对于经常处理敏感内容的人——比如律师口述备忘、记者整理采访、医生记录初步想法——本地处理消除了音频外传的顾虑。
官方描述中提到,你可以“说出回复、起草邮件或捕捉灵感,而无需将音频上传用于转录”。这一定位把它从单纯的工具推向了隐私优先的工作流组件。
本地模型 + 可选云端 + 自带 API Key
OpenWhispr 并没有把本地路线做成唯一选项,而是提供了分层策略:
- 本地模式:下载模型后完全离线运行,免费且无限制
- 云端模式:可选择使用云端处理,适合对速度或精度有更高要求的场景
- 自带密钥(BYOK):用户可以填入自己的 API Key,接入第三方转录服务
这种设计承认了一个现实:端侧模型在速度和准确率上未必总能媲美云端大模型。把选择权交还给用户,而不是替用户做隐私与性能的取舍,是这类工具走向成熟的标志。
端侧语音识别模型通常基于 Whisper 等序列到序列架构。OpenAI 开源的 Whisper 模型提供了 tiny、base、small、medium、large 等不同参数规模,参数量从约 3900 万到 15.5 亿不等。在 iOS 设备上运行需要将模型转换为 Core ML 或使用 whisper.cpp 等推理框架,并借助 Apple Neural Engine 加速。模型越大,识别准确率越高,但内存占用和推理延迟也相应增加——例如 large 模型可能占用超过 1 GB 存储,而 tiny 模型仅约 75 MB。这种精度与资源的权衡直接决定了端侧转录在旧款 iPhone 上是否可用。
自带密钥(BYOK) 是一种让用户自行提供第三方 API 密钥的集成模式。在这种模式下,应用本身不承担推理成本,也不经手用户的密钥与音频数据,而是由用户直接调用 OpenAI、Deepgram 等服务的 API。对开发者而言,这规避了转售 API 的合规与计费问题;对用户而言,则意味着可以自由选择服务商并控制成本,但需要自行管理密钥安全。
开源意味着什么
“100% 开源”不只是许可证层面的声明。对转录工具而言,开源至少带来三重价值:
可验证性。用户和审计者可以检查代码,确认音频确实没有被偷偷上传。隐私承诺从“相信我们”变成“可以自己看”。
可定制性。开发者可以 fork 项目、替换模型、接入自己的后端,甚至把它嵌入更大的应用。
可持续性。即便原团队停止维护,社区仍可接手。对于依赖转录功能的长期工作流,这一点比短期的功能迭代更重要。
可验证性在实际操作中通常通过可复现构建(reproducible build)来强化:如果任何人都能用相同源码编译出与 App Store 版本完全一致的二进制文件,就能确认发布版本没有夹带额外代码。iOS 生态对此有一定限制,因为应用必须签名才能安装,但开源代码至少让安全研究者可以审计逻辑、检查网络请求行为,并借助抓包工具验证音频是否真的没有外传。
开源许可证的差异也值得注意。MIT、Apache 2.0 等宽松许可证允许闭源商用和二次分发,而 GPL 系列则要求衍生作品同样开源。OpenWhispr 若采用宽松许可证,社区 fork 的门槛更低,但也意味着他人可以将其包装成闭源产品;若采用 copyleft 许可证,则能保证改进回馈社区,但会限制商业集成方式。
值得观察的地方
截至收录时,OpenWhispr 在 Product Hunt 获得 84 票、4 条评论,排名第 14 位。数据不算惊艳,但它所在的赛道——本地优先的生产力工具——正在积累真正的需求。
需要留意的是,端侧转录的实际体验高度依赖设备芯片性能和模型大小。模型越大精度越高,但占用存储和内存也越多;iPhone 与 iPad 之间的体验差异也可能存在。这些细节没有在官方简介中展开,需要实际使用才能判断。
对于不愿把语音交给云端的用户,OpenWhispr 提供了一个值得尝试的开源选项。它的价值不在于功能有多炫,而在于把“隐私”从营销话术变成了可运行的代码。
相关推荐

Gemini 4 Argon API实战:思考等级、后台模式一次讲透
Free Code Camp 出品的 Gemini 4 Argon API 速成教程:从申请密钥、发送首次请求,到用思考等级控制推理成本、用 previous_interaction_id 实现多轮对话,再到后台模式一句话生成打砖块游戏,附 Google 工程师对模型能力的解读。

强化学习通关《抡大锤》:63%进度背后的分布式训练策略
开发者用深度强化学习挑战《抡大锤》,智能体从底部攀爬至63%进度,卡在铁砧部分。项目开源,采用分治训练和CPU训练策略,寻求社区协作突破瓶颈。

AAAI 2027二审放榜在即:社区热议评审公平与投稿生态
AAAI 2027第二阶段评审结果即将公布,Reddit社区热议评审一致性与流程透明度。本文梳理放榜前的社区情绪、顶会评审的结构性矛盾,以及作者应对二审结果的务实策略。