#本地模型
共 37 篇相关文章
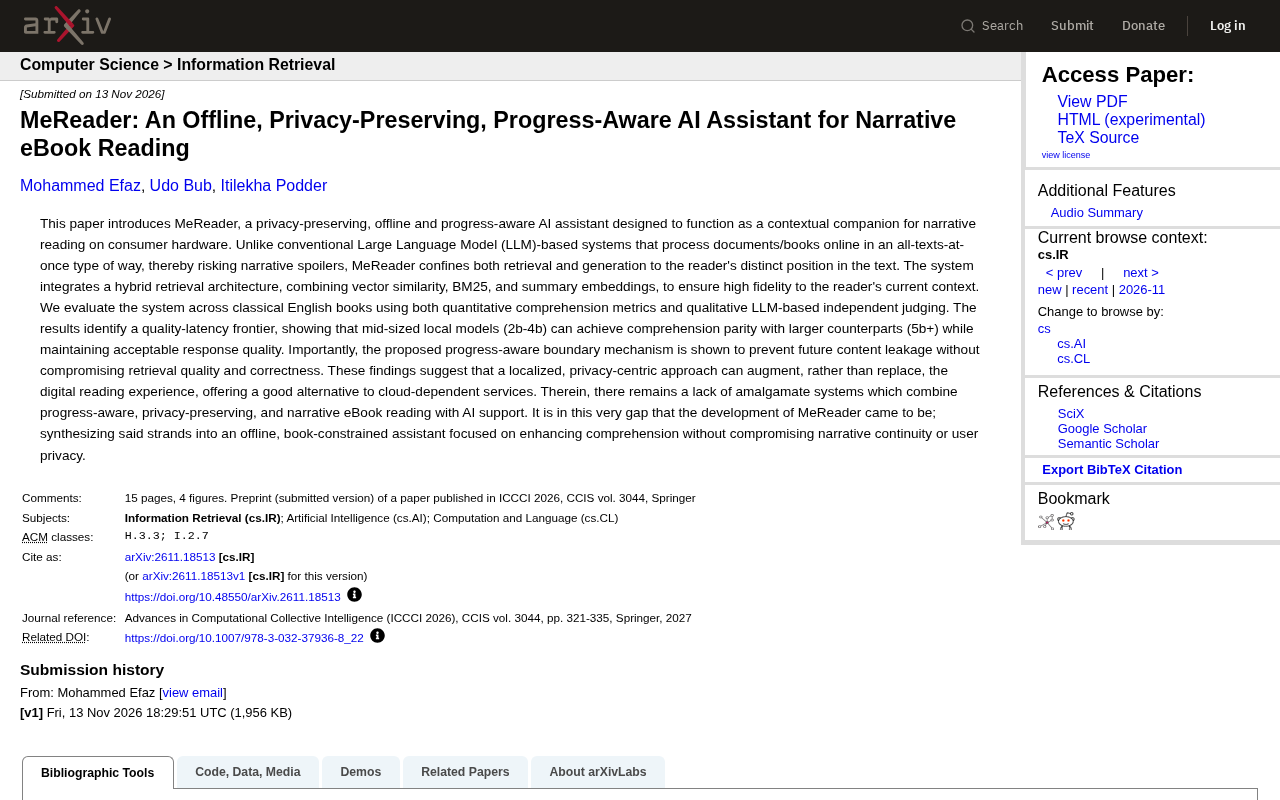
MeReader:离线隐私AI阅读助手,防剧透
MeReader是一款完全离线、隐私保护的AI阅读助手,通过混合检索与进度感知边界机制,将回答限制在读者已读范围内,防止剧透。论文评测显示,2b-4b中型本地模型即可达到与更大模型相当的理解表现。

1B小模型驱动桌面宠物:一次务实的AI Agent架构实验
一个名为Felinquent的桌面宠物项目,用1B本地模型规划行为、规则层负责实时反应与安全治理,展示了小模型Agent的分层设计与降级策略,对构建可靠AI Agent有参考价值。

datasette-llm 0.1a11 发布:接入任意 OpenAI 兼容本地模型
datasette-llm 0.1a11 新增 OpenAI 兼容端点支持,可将 LM Studio、Ollama、llama.cpp 等本地模型接入 Datasette,配合 datasette-agent 用自然语言查询 SQLite 数据库。

GLM-5.5训练流程曝光:32B到256B,社区为何从狂喜到失望
Z.ai首席科学家唐杰披露GLM-5.5训练流程,涵盖32B、122B、256B三个规格。Reddit社区从兴奋转为失望,争议焦点在于中小尺寸本地部署模型的缺失与消息可信度。
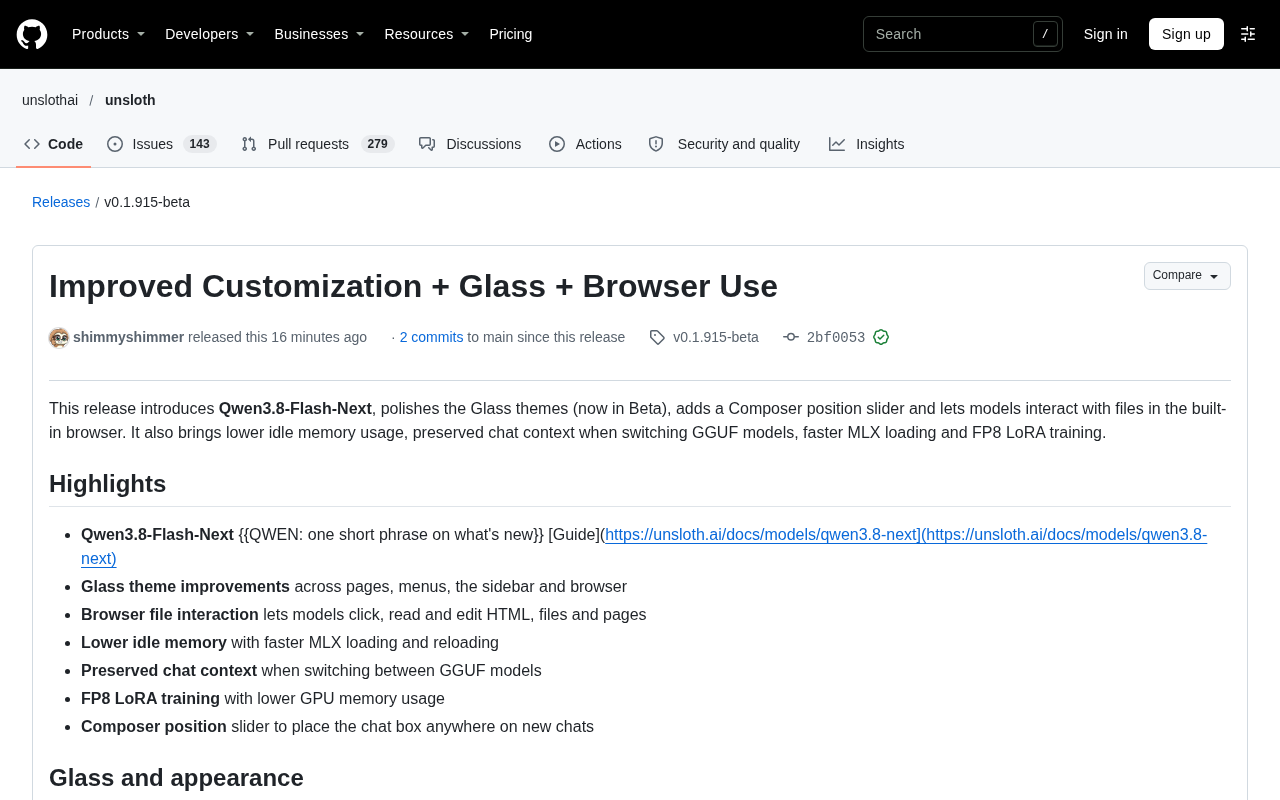
Unsloth Studio更新:浏览器文件交互与玻璃主题Beta
Unsloth Studio v0.1.915-beta 发布:模型可在内置浏览器中读写和编辑文件,Glass 玻璃主题进入 Beta,同时带来更低空闲内存、更快 MLX 加载和 FP8 LoRA 训练支持。

本地量化模型 vs Claude:9个真实Bug实测,谁更胜一筹?
Reddit开发者用9个真实C++/CUDA bug对比本地量化模型与Claude系列。Qwen3.8-Flash-Next得分超越Claude Haiku 5.5,而3-bit量化27B模型分数不降但token消耗增40%,揭示量化真正代价是思考更久。

本地模型为何在Doom游戏决策中击败Jev AI API?
YouTube视频对比显示,本地模型GLiNER在Doom游戏中以12毫秒响应和8.8次/秒决策频率,大幅超越Jev AI API的2.5次/秒,得分翻倍。

3步让本地模型自己翻文件:手把手接入MCP工具
本地模型看不见硬盘?用MCP三步接入工具:不到百行的Python Server脚本、五行配置、一次对话脚本,让模型先调工具再回答,磁盘查询、文件操作全在本地完成。
Surface RTX Spark Dev Box 离线跑通 120B 模型:Intelligent Terminal 实战
微软 Surface RTX Spark Dev Box 实机演示:通过开源 Intelligent Terminal 离线运行 120B 参数本地模型,一句话自动构建可启动 Hyper-V 虚拟机,展示 Project Zemuth 设备的本地 AI 能力。
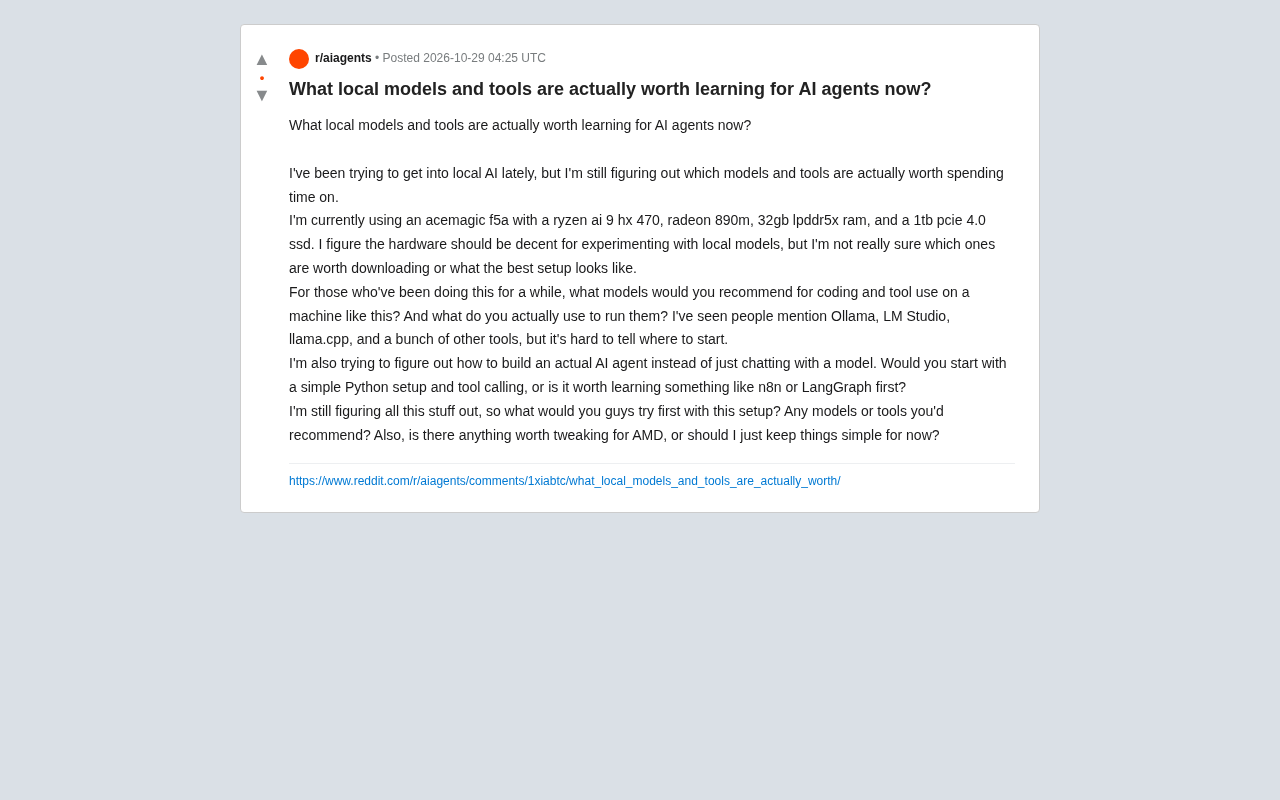
本地AI智能体入门:模型与工具怎么选?
本地AI智能体入门指南:核显平台如何选择编码与工具调用模型,Ollama、LM Studio、llama.cpp 各自适合什么场景,以及从 Python 手写工具调用循环到 n8n、LangGraph 框架的学习路径,附 AMD 平台调优要点。

导演大师配置Ollama本地模型全流程教程
B站教程完整演示导演大师配置Ollama本地模型的方法:从Ollama安装、模型路径设置、千问模型下载,到在导演大师Agent设置中接入本地模型,并用本地千问3.8跑通选题、大纲、剧本和分镜全流程。
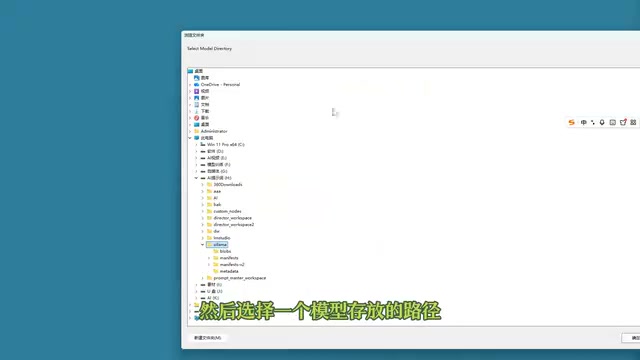
导演大师接入Ollama本地模型:配置与全流程创作实战
B站教程详解导演大师如何接入Ollama本地模型:从安装Ollama、设置模型存储路径、命令行拉取千问模型,到在Agent设置中添加提供方,并用本地千问3.8跑通选题、大纲、剧本、分镜的短片创作全流程。

Cline Desktop v0.0.49 更新:终端面板与本地模型管理上线
Cline Desktop v0.0.49 发布,新增 Changes 变更面板、项目文件树、集成终端与本地模型管理页,并修复 Hub 启动失败、超大会话无法恢复、SSH ProxyJump 连接等多项稳定性问题。
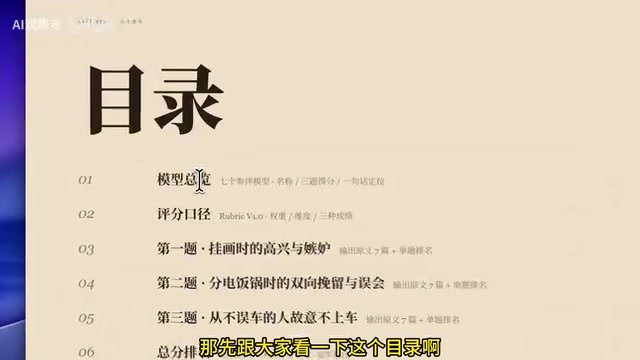
本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

用本地Ollama跑Claude Code:完整实战指南
手把手教你将 Claude Code 连接到本地 Ollama 模型,覆盖 Windows、Linux、macOS 安装配置,含 ollama launch 与环境变量两种接法,并附 8GB 内存实测结论与排错清单。

用Gemma本地识别巴拿马小票,自动生成税务表格
开源项目Cuadre用本地运行的Gemma模型识别巴拿马纸质小票,自动提取RUC、ITBMS等字段并生成税务表格CSV。模型只负责转录,代码负责计算,数据不出本机,适合会计师和自由职业者批量处理收据。

Pricor:本地AI读供应商表格,精确引擎算价格
Pricor 是一款本地优先的开源工具,用 Laya 和 Gemma 本地模型识别供应商表格列含义,由精确 Decimal 引擎完成连锁折扣、增值税剔除与单位换算,所有计算可追溯、用户可确认。

AI疲劳真存在?我用10亿参数离线小模型处理私密信件
一位开发者用306行Python和10亿参数离线小模型gemma3:1b处理瑞士行政信件,代码管数字、模型管语言。这个40秒完成的任务,揭示了AI疲劳背后"够用就好"的落地思路。

VaultLedger:基于 Ollama 的离线发票对账工具
VaultLedger 是一个基于 Ollama 本地模型的开源财务对账工具,在完全离线环境下解析发票 PDF 并与银行流水 CSV 比对,标记重复发票和缺失凭证,输出 Excel 审计报告。

Codex接本地模型:8G到24G显卡各能跑什么
把Codex和Claude Code接到本地模型,关键是一句减法:显存减模型文件大小,剩下留给上下文。本文按8G、12G、16G、24G四档显卡列出可跑模型、实测余量、Ollama接入四步法和四个常见卡点,并说明Claude Code官方不支持本地模型的限制。