Opus 5.5泄露定价更低!Qwen4、Kimi K3.1等国产大模型集中来袭
多家AI实验室密集发布旗舰模型,降本增效与开源MoE架构成为新一轮竞赛主轴。
本文汇总了当前AI大模型领域的一波密集发布动态。Anthropic的Opus 5.5正处于内测收尾阶段,泄露定价远低于同级竞品,体现闭源厂商的降本战略;StepFun推出6000亿参数MoE架构的Step5 Preview,以270亿激活参数实现高效推理,并承诺10月开源;MiniMax采用"稳定版M3.1+旗舰版M3 Pro"双线并进策略,前者聚焦可靠性,后者冲击近3万亿参数规模;阿里巴巴将在云栖大会集中亮相Qwen4系列及仅70亿参数却支持透明背景生成的图像模型Qwen Image 2.1;Moonshot AI则以圆周率数字梗隐晦预告Kimi K3.1。整体来看,模型竞争已从单纯堆砌参数转向"同等能力下更便宜、更实用、更开放"的新维度。
AI大模型的更新节奏进入了新一轮密集期。据B站科技UP主的最新汇总,Anthropic的Opus 5.5正处于密集测试中,最快本周二亮相;话说回来,来自中国的StepFun、MiniMax、阿里巴巴、Moonshot AI等实验室也在同一时间窗口筹备各自的旗舰模型。这波集中发布不仅意味着性能竞赛升级,更透露出一个明确的行业信号——降本增效正成为新一代模型的核心叙事。
Opus 5.5:性能对标GPT-6 Astra,定价却更低
根据泄露信息,Anthropic已放弃此前的Opus 5.5.2 EAP版本,转而密集测试全新的Opus 5.5检查点,代号「Cloud Wafer EAP」。这一版本以星标符号出现在内部代办清单中,传闻发布时间定于周二。
最令人关注的是定价策略。泄露的价格显示,Opus 5.5每百万输入token约4美元、输出20美元、缓存读取0.2美元。如果这一价格属实,且性能真能匹敌传闻中的GPT-6 Astra级别,那么Opus 5.5的性价比将极具杀伤力。这也印证了Anthropic当前的战略重心——不再一味追求上下文窗口扩容,而是聚焦提效降本。据爆料,最新检查点的上下文窗口反而略有缩减,降幅虽不大,却是一个耐人寻味的方向调整。
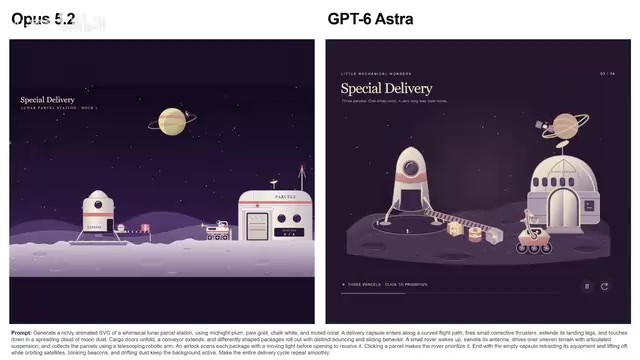
在能力演示上,爆料显示Opus 5.5能在3D环境中较为精准地变换和展示物体,比如生成宝马M5的3D模型(尽管车轮等细节仍有瑕疵),还能用SVG生成完整的多场景模拟。相比5.5.2版本,这个新检查点整体表现更强。不过需要注意,以上均为泄露与传闻信息,官方尚未正式确认,读者应保持审慎。
Token定价是当前大模型API计费的通行标准。Token是模型处理文本的基本单位,英文约每4个字符折合1个token,中文通常每字对应1-2个token。"输入token"指发送给模型的提示词与上下文,"输出token"指模型生成的回复,两者通常分开计价且输出价格更高,原因在于输出需要逐token自回归生成,算力消耗更大。"缓存读取"(cache read)则是近年兴起的优化机制:对于重复出现的长提示词前缀(如系统提示或长文档),提供商将其KV缓存保留一段时间,后续请求命中缓存时仅按极低的缓存读取价格计费,从而大幅降低多轮对话或批量处理的成本。Opus 5.5泄露的0.2美元/百万token缓存读取价格,约为输入价格的1/20,对高频调用的企业用户而言降本效果显著。
StepFun Step5 Preview:6000亿参数MoE,成本降65%
国产阵营中,StepFun率先推出了下一代旗舰Step5预览版,主打智能体、软件开发与专业知识领域,并特别强调其在金融场景的能力。
从架构看,Step5 Preview是一款6000亿参数的MoE(混合专家)模型,但激活参数仅270亿,兼顾了规模与推理效率。它支持视觉数据处理,并配备了百万级token的上下文窗口。StepFun官方图表称其对标GLM-5.3与Qwen(QNK3)同级模型,而每项任务成本约降低65%。
真正值得期待的是开源计划。StepFun表示将在10月15日发布开源权重。不过6000亿参数的体量也带来现实门槛——即便经过量化,本地运行几乎不可能,普通用户仍需依赖强大硬件或云端。开源之后,社区能挖掘出多少潜力,将是后续观察的重点。
MoE(Mixture of Experts,混合专家)是一种稀疏激活的神经网络架构。与传统"稠密"模型在每次推理时激活全部参数不同,MoE将模型拆分为多个"专家"子网络,每次推理只由门控路由器(gating router)选择其中少数几个专家参与计算。这意味着一个拥有6000亿总参数的MoE模型,实际每次前向传播只需调用270亿参数的计算量,推理成本与一个270亿参数的稠密模型相当,却能在训练阶段积累远超后者的知识容量。这一设计的代价是更复杂的训练稳定性挑战和更高的显存占用——所有专家的权重必须同时加载到内存中。正是这个原因,6000亿参数的Step5 Preview即便提供开源权重,普通消费级GPU也无法运行:仅权重本身以FP16存储就需约1.2TB显存,量化后仍需数百GB,远超单卡乃至多卡消费级配置上限。
MiniMax M3.1与M3 Pro:从规模转向可靠性
MiniMax M3.1的发布也已临近。据B站UP主观察,MiniMax代码仓库中一次秘密提交的测试文件里出现了M3.1的踪迹,虽未确认具体日期,但明确暗示新一代模型正在收尾。结合业内消息,这款模型可能在本月底或下月初推出。
在此前的业绩会上,MiniMax CEO曾提到M3.1、M3 Pro和H3.1等多款模型已接近完成。值得玩味的是,M3.1的设计思路并非单纯扩大规模,而是聚焦让实际任务处理更可靠——官方强调优化了稳定性、推理质量、效率以及智能体泛化能力。相比之下,M3 Pro则走的是规模路线,据称拥有近3万亿参数,配合重大架构升级,提升了预训练规模、训练效率和超长跨度任务表现。这种「稳定版+旗舰版」的双线布局,反映出厂商在实用性与性能上下限之间的权衡。
阿里Qwen4与图像模型:云栖大会集中亮相
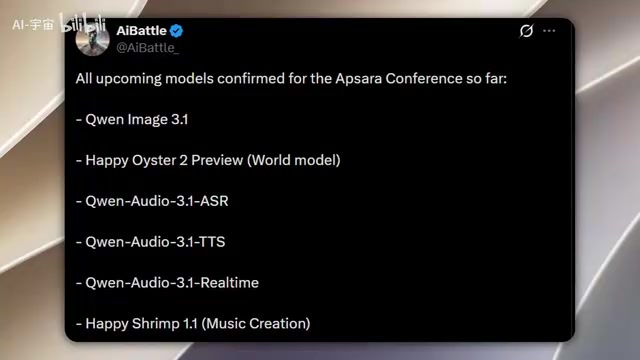
阿里巴巴正准备Qwen4(QN4)系列,最早可能在即将召开的云栖大会(Aspara/Apsara大会)上亮相。这符合历史惯例——通义2.0、Qwen2.5、Qwen3等重磅版本此前都借助该活动首发。
本届大会专设主题「Qwen迈向智能体时代的演进」,阿里承诺展示在编程与办公任务上大幅提升的旗舰大模型,以及全能型模型和实时多语言翻译模型。除此之外,还将带来世界模型Happy Oyster 2的预览,以及ASR、TTS、实时音频等多款模型。
其中最引人注目的是新发布的图像模型Qwen Image 2.1——一款仅70亿参数的开源权重模型,同时支持生成与编辑。尽管体量极轻,测试用户评价称其基本与主流模型持平,Midjourney方面也表示它能与更复杂的模型竞争。该模型支持最多10张参考图、高精度编辑,甚至原生支持RGBA透明度,可直接生成透明背景图像。这种规模下的能力密度,使其成为个人也能自行运行的强大工具。
RGBA透明度支持在图像生成模型中属于相对罕见的原生能力。传统图像生成模型输出的是RGB三通道图像,背景去除需要依赖独立的抠图模型(如Rembg、SAM等)二次处理,往往在边缘细节上产生误差。原生RGBA输出意味着模型在生成阶段即同步预测每个像素的透明度(Alpha通道),可直接输出带透明背景的PNG图像,省去后处理步骤,对电商素材、UI设计、游戏资产等需要叠层合成的工作流尤为实用。Qwen Image 2.1以仅70亿参数实现这一能力,并支持最多10张参考图的条件生成,体现出当前小模型在垂直能力上的快速追赶态势——通过针对性的训练数据和任务设计,参数量不再是决定特定场景能力上限的唯一变量。
Kimi K3.1:一串数字暗藏玄机
最后,Moonshot AI的Kimi K3.1也已临近。Kimi官方账号意外发布了一长串未加解释的数字,社区很快发现:去掉「3.1」后,这些数字与圆周率完全吻合——这被普遍解读为对Kimi K3.1的隐晦预告。官方目前尚未正式确认,但从营销动作看,发布已进入倒计时。
结语:降本与开源,成为新一轮竞赛主线
这一波集中发布勾勒出清晰的行业趋势。一方面,Anthropic的Opus 5.5以「更强性能+更低定价」示范了闭源厂商的降本方向;另一方面,StepFun、MiniMax、阿里、Moonshot等中国实验室则密集推进开源权重与MoE架构,在参数效率、任务可靠性和成本控制上持续发力。
从6000亿参数的Step5到仅70亿参数却能打的Qwen Image 2.1,模型竞争已不再是简单的参数堆砌,而是转向「同等能力下谁更便宜、谁更实用、谁更开放」。需要提醒的是,本文多数信息来自泄露与社区推测,具体发布时间和规格仍以各家官方公告为准。
相关推荐
深入LLM推理:从KV Cache到PD分离的Serving全景解析
深入解析LLM推理与Serving技术栈:涵盖KV Cache原理、Prefill/Decode两阶段计算形态、PagedAttention、PD分离、EP并行、投机解码等核心机制,剖析大模型推理系统的关键工程权衡与优化思路。
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta旗下个人AI智能体Muse上线仅六天下载量突破90万,连续登顶美国App Store与Google Play双榜,超越ChatGPT、Claude等明星产品。本文深度解析Muse的核心能力、入口优势与AI Agent赛道的竞争格局。
认知行为疗法 vs 精神分析:谁赢得了心理治疗之争
认知行为疗法(CBT)如何战胜精神分析成为心理治疗主流?历史学家Andrew Scull揭示了从二战、联邦经费到循证医学的深层原因,并客观评估CBT在轻度与重度精神障碍上的真实疗效。