Opus 5.5引爆讨论:便宜又强的模型是怎么炼成的?
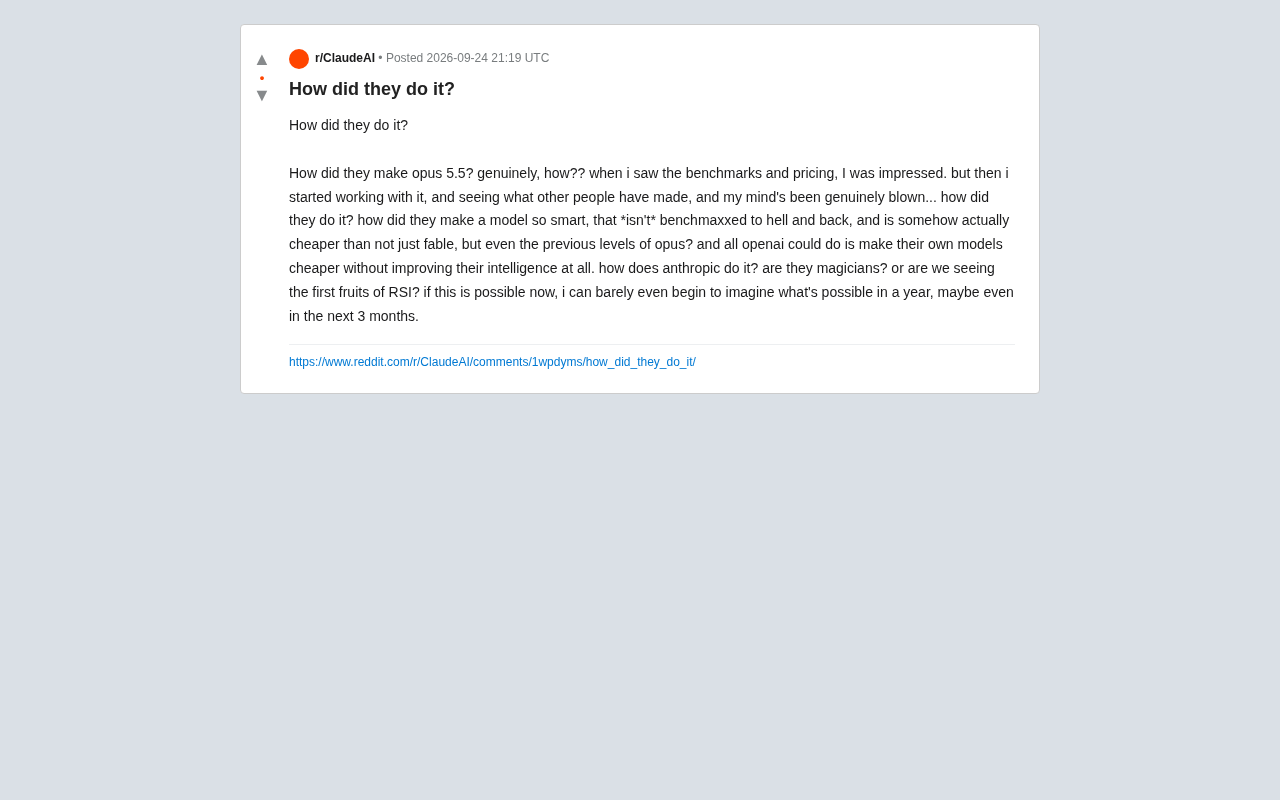
一条Reddit帖子揭示:用户开始以真实体验和性价比而非跑分评判AI模型的进步。
一位Reddit用户在体验据称名为"Opus 5.5"的新模型后,惊叹其实现了"更强、更便宜、不刷榜"三者并存的罕见组合,并猜测这可能是递归自我改进(RSI)的早期迹象。文章梳理了这一感叹背后的三个反常识点——跑分与实用体验一致、定价反而更低、对比竞争对手仅降价未提升智能——同时指出RSI猜测过于跳跃,更朴素的解释在于MoE架构、推理成本优化和后训练质量提升等工程手段。文章最终将这条帖子的价值定位为一个行业信号:终端用户的评判标准正从单一跑分转向真实使用体验与性价比,而这才是从业者更应关注的趋势。
一条Reddit热帖抛出的疑问
一位Reddit用户在体验了据称名为「Opus 5.5」的新模型后,发出了近乎困惑的感叹:"How did they do it?"(他们到底是怎么做到的?)。这位用户的原话里透着难以掩饰的兴奋——先是被基准测试和定价吸引,随后在实际使用中、以及看到别人用它做出的成果后,直呼"my mind's been genuinely blown"(我的脑子彻底被震撼了)。
这条帖子之所以引发共鸣,不在于它给出了答案,而在于它精准戳中了当前大模型竞赛中最反直觉的一个现象:一个模型既能更聪明,又能更便宜,还没有陷入"刷榜"的窠臼。
用户眼中的三个反常识点
更强却没有"benchmaxxed"
发帖者特别强调了一个词:"isn't benchmaxxed to hell and back"。"benchmaxx"是社区里对"专门针对基准测试过度优化"的调侃说法——很多模型在跑分上光鲜亮丽,一到真实任务就露馅。而在这位用户的体验里,新模型的表现是"用出来的强",而非"测出来的强"。这种"跑分与实用体验一致"的观感,恰恰是普通用户最难被糊弄、也最看重的地方。
价格反而更低
更让他费解的是定价。按他的描述,这个新模型不仅比某个被称作"Fable"的档位便宜,甚至比"previous levels of Opus"(此前几代Opus)还要便宜。通常认知里,能力提升往往伴随算力成本和售价上涨,而"更强+更便宜"的组合直接打破了这一线性假设。
竞争对手的对比
帖子里还夹带了对OpenAI的评价:"all OpenAI could do is make their own models cheaper without improving their intelligence at all"——在这位用户看来,竞争对手只做到了降价,却没能同步提升智能水平。这种对比进一步放大了他对Anthropic做法的好奇。
需要说明的是,以上均为单一Reddit用户的主观体验与观点,模型名称、定价对比等细节未经官方或多来源核实,读者应保持审慎。
"他们是魔术师,还是RSI的第一批果实?"
帖子最耐人寻味的部分,是发帖者的两个猜测:"are they magicians? or are we seeing the first fruits of RSI?"
RSI指的是Recursive Self-Improvement(递归自我改进)——即AI系统利用自身能力来加速改进下一代模型的设想。这是AGI讨论中一个高度敏感的概念,因为一旦成立,意味着能力提升可能进入指数级加速通道。
发帖者顺势展望:"if this is possible now, i can barely even begin to imagine what's possible in a year, maybe even in the next 3 months."(如果现在就能做到这些,我几乎无法想象一年后、甚至未来三个月会是什么样子。)
这种从"一次产品体验"直接跳跃到"RSI已然发生"的推理链条,其实反映了当前社区一种典型心态:当技术进步超出直觉预期时,人们倾向于用最戏剧化的解释去填补认知空白。
递归自我改进(RSI)的核心逻辑是:如果一个AI系统足够聪明,它就能设计出比自己更聪明的下一代系统,而下一代系统又能设计出更聪明的再下一代,如此循环往复,形成正反馈加速。这一概念最早由数学家欧文·古德(I.J. Good)在1965年提出,他将其称为"智能爆炸"(intelligence explosion)。在现实工程层面,AI辅助AI研究已经出现——例如用语言模型生成训练数据、优化超参数、甚至辅助写代码——但这距离"真正的RSI"仍有本质差距:目前的AI辅助研究依然需要人类研究员把关决策,并没有脱离人类控制形成闭环加速。因此,将一次产品能力跃升直接解读为"RSI已然发生",混淆了"AI参与研发流程"与"AI自主递归自我改进"这两个概念,前者已是行业常态,后者至今仍是理论假设。
冷静看:跳跃式进步的更可能解释
把"更强+更便宜"归因于RSI固然吸引眼球,但从工程角度看,有更朴素的解释值得考虑:
- 架构与训练方法的迭代:混合专家(MoE)、更高效的注意力机制、更优的数据配比,都能在不成比例增加成本的前提下提升有效能力。
- 推理成本优化:蒸馏、量化、推理调度的改进,可以显著压低单位token的服务成本,这与"智能提升"是两条相对独立的曲线。
- 数据与后训练质量:高质量的对齐和后训练,往往比单纯堆参数更能改善"真实任务体验",也更不容易表现为单纯的刷榜。
换句话说,"没有benchmaxx的真实强度"更可能是训练数据与对齐工程的成果,而非某种自我进化的黑箱魔法。
混合专家模型(Mixture of Experts,MoE)是理解"更强却未必更贵"这一现象的重要背景。传统的密集型(Dense)大语言模型在处理每一个token时,会激活全部参数;而MoE架构将模型拆分为多个"专家"子网络,每次推理只激活其中少数几个最相关的专家。这意味着模型可以拥有庞大的总参数量(对应较强的知识容量),但实际推理时的计算量远小于同等规模的密集模型,从而在不成比例提高推理成本的前提下实现能力跃升。GPT-4和Gemini 1.5等主流前沿模型均被业界广泛猜测采用了MoE或类似稀疏化架构。与之配合的蒸馏技术(将大模型的"知识"压缩进小模型)则进一步拉低了部署成本。这些工程手段共同解释了为何"能力-成本"的正比假设在近年来频繁被打破。
这条帖子真正的价值
剥离掉那些夸张的猜测,这条帖子记录了一个真实的行业信号:终端用户开始把"实际使用体验"和"性价比"作为评判模型的核心标准,而不再迷信单一的跑分数字。当一款产品能让用户发出"how did they do it"的惊叹时,说明它在体验层面确实跨过了某个门槛。
对从业者而言,这提醒我们:真正打动人的进步,往往体现在"跑分之外"的地方——响应质量、稳定性、以及那个越来越关键的性价比。至于是不是RSI,恐怕还需要远比一条Reddit帖子更严谨的证据。
相关推荐
意识的神经科学:大脑如何产生主观体验
意识的神经科学入门:从植物状态患者的脑成像研究,到意识的神经关联、简单问题与难题,再到全局工作空间理论、整合信息理论与预测加工三大主流理论,解析大脑如何产生主观体验。
Jev模型实测:快到能实时运行Doom的AI
一位ChatGPT核心贡献者打造的Jev模型号称快到能实时运行Doom,输出token免费、输入仅四美分每百万,性能对标Sonnet 5等旗舰。本文梳理其速度、定价与性能亮点及需验证之处。
Anthropic的IPO悖论:宣称AI可能毁灭人类,却要上市募资
Anthropic一边宣称其AI技术可能毁灭人类且无法控制,一边准备IPO上市募资。本文剖析这一逻辑悖论,并用医疗、航空等高风险行业作类比,探讨AI安全叙事与商业动机之间的深层张力。