Opus 5.5重获好评:Anthropic王者归来与AI成本战

OpenAI与Anthropic同日发布四款模型,Opus 5.5口碑逆袭登顶,双方战略路径愈发清晰分化。
本周OpenAI与Anthropic罕见同日发布新模型:Anthropic推出Opus 5.5,OpenAI放出GPT-6 Sol与Luna。Opus 5.5在经历了4.7、4.8、5.0的口碑滑坡后强势反弹,以58分登顶第三方智能指数,成本较Opus 5下降约40%,写作质量与模型"性格"尤受好评,被普遍评价为"Opus 4.6的体验回来了"。GPT-6 Sol和Luna则延续OpenAI的成本战路线,API价格再降50%,主打按任务定价的竞争力。社区反应中Opus 5.5明显占据注意力高地,但安全拒答问题对法律、生命科学等专业用例构成实际障碍。两家实验室的战略分野愈发清晰:OpenAI激进压低成本、为多层智能体架构铺路;Anthropic则借本次发布成功夺回势头。
一天四款模型:两大实验室的正面对决
本周前半段AI圈异常热闹——不是一款、两款,而是四款重磅模型集中发布。其中周二一天内,OpenAI与Anthropic这两家当下最重要的实验室罕见地同日发布新模型,这在以往极为少见。
Anthropic率先推出Claude Opus 5.5,OpenAI随后在当天东部时间下午放出GPT-6 Sol与GPT-6 Luna两款模型。同日发布的结果,是讨论焦点不可避免地从"这款模型本身价值何在"滑向"哪家更强、谁在领跑"的对比叙事。
但真正值得关注的,是这批发布背后两种清晰可辨的战略路径:OpenAI继续在智能栈的每一层押注成本效率,而Anthropic则试图夺回自Opus 4.6以来久违的口碑高地。
Opus 5.5:从"退步"到"王者归来"
要理解Opus 5.5为何引发如此热烈反响,得先回顾Opus系列这段尴尬的历史。自Opus 4.6赢得大量拥趸后,4.7和4.8对许多用户而言至多是微小改进,某些场景甚至是退步;而Opus 5则干脆被广泛嫌弃。
AI内容创作者Peter Yang用一组"画马"梗图精准概括了这一曲线:Opus 4.6是精美完整的骏马,4.7、4.8逐渐沦为潦草的儿童简笔画,Opus 5几乎是一团涂鸦,而到了Opus 5.5,那匹精雕细琢的骏马终于回来了。
从基准测试看,Anthropic的说法是Opus 5.5在多数任务上达到Claude Fable 5.1的水平,但运行成本降低约40%。在Terminal Bench 4.0上,Opus 5.5跳升至66.4%;在Cursor Bench、Frontier Code v1.1和Humanity's Last Exam上也全面超越了自家的Fable 5.1和Opus 5。在Anthropic的所有基准中,没有一项Opus 5.5落后于同门模型。
价格方面,Opus 5.5定价为每百万输入token 4美元、输出20美元,低于Opus 5的5美元与25美元;叠加额外效率提升,实际成本降幅约40%。生成速度也比Opus 5平均快30%。
第三方评测机构artificial analysis给出了更有力的佐证:Opus 5.5以58分登顶其智能指数,大幅超过此前并列榜首(53分)的Claude Fable 5.1和GPT-6 Astra,同时还伴随20%的降价。
GPT-6 Sol与Luna:把成本战打到底
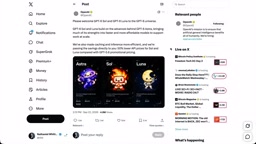
如果说Opus 5.5的发布略微侧重成本与效率,那么GPT-6 Sol和Luna则是彻头彻尾围绕"成本与效率"展开。OpenAI的公告称,这两款模型继承了GPT-6 Astra的大部分优势,但更快更便宜,API价格相比GPT-5.6促销价再降50%。
Sam Altman在推文中强调了OpenAI当下的核心逻辑:按每任务定价(而非每token),他认为市面上没有任何竞品能与之抗衡。"我们希望人们能够海量地使用AI,这对于探索眼前这场新文艺复兴至关重要。"
值得玩味的是OpenAI的叙事方式——他们把成本下降直接包装成"启用新用法"。更低的价格和更高的额度意味着用户可以更频繁地迭代。公告中披露,按API价格计算,OpenAI研究员的中位数每天消耗600美元token,90分位则高达7000美元,直观展示了"海量使用"的真实量级。
从基准呈现方式也能看出两家的理念差异:Anthropic仍沿用传统的"模型-百分比"图表,OpenAI则彻底改为以性能(Y轴)对成本(X轴)作图。第三方数据显示,GPT-6 Sol、Luna的智能分数与上一代基本持平(约37分),但成本减半;Zapier在真实工作流测试中发现6 Sol得分33.2%,优于5-6 Sol的28.77%,且价格约为后者一半,结论干脆:"所有使用5-6的工作流都该升级,又便宜又好。"
杰文斯悖论(Jevons Paradox)源自19世纪经济学家威廉·斯坦利·杰文斯的观察:当某种资源的使用效率提高、单位成本下降时,人们反而会使用更多该资源,总消耗量不降反升。用于AI领域时,这一规律意味着token价格每次大幅下降,都会解锁此前因成本过高而无法部署的用例,推动整体调用量成倍增长。这正是Sam Altman"海量使用"逻辑背后的理论基础——OpenAI的目标不仅是维持现有用户,而是通过价格压缩创造全新的需求层。Box的Aaron Levy用这一概念来解释为何智能体数量会随token成本下降而爆发式增长,而非线性提升。
口碑分野:Opus 5.5拿下讨论热度
尽管两款模型各有定位,但从社区反应看,Opus 5.5无疑拿下了这轮发布的注意力高地。Matthew Berman直言"Opus 5.5成为地球上最强模型、还比Astra和Fable便宜,不在我的预测清单里";Chubby则表示越用越爱,"就像我钟爱的Opus 4.6回来了,但更好"。
在具体场景上,Box团队将Opus 5.5用于复杂企业知识工作,相比Opus 5节省63% token、减少42%冗余、提速30%,并在金融服务任务上提升39%准确率、云成本分析提升65%。社交媒体上大量演示集中在3D渲染、Blender动画等视觉任务——Anthropic的Alex Albert用单条提示让其生成黏土动画,Peter Yang展示了完全由代码(而非图像模型)生成的金门大桥场景。

几乎所有人都公认Opus 5.5在写作上是"严格更优"。Anthropic称它沟通更自然、把重要信息前置、遵循给定的写作规则。AI写作评测团队Every给出高度评价:"这是我们见过的Anthropic或OpenAI模型中最可读的文字",并点出关键——"Anthropic修好了Opus的性格,它不再是个固执的小讨厌鬼了。"McKay Wrigley总结道:Opus 5.5=我们都想要的Opus 4.6性格+Fable 5.1的智能与品味。
安全护栏成双刃剑
赞誉之外,也有明确的痛点。对某些专业场景而言,Opus 5.5的安全拒答成了直接的拦路虎。
一位从事法律工作的用户反馈,在起草客户和法庭级文件、合同红线、法律研究等复杂开放任务上,Opus 5.5"明显更差",原因是安全拒答增多以及"努力预算分配不佳"。生命科学公司的Simon Smith也担忧:由于Opus 5.5在生物和网络安全领域能力接近Claude Mythos 5.1,Anthropic为其部署了类似Fable 5.1的防护,而此前他们正是在Fable拒答时转用Opus,如今这条退路也被堵上了。

这类限制并非普遍,但只要命中特定用例,就可能让模型对该用户彻底失效。
五点观察:从模型之争到"栈"之争
这轮密集发布留下了几个值得咀嚼的判断。
成本正以史无前例的速度下降。 Box的Aaron Levy将其类比为"应用于智能体的杰文斯悖论"——每次token成本下降,可部署智能体的用例数量都会大幅增加。Epic AI Research的数据佐证了这点:在给定性能水平下,AI成本自2023年以来每季度下降约47%,是DNA测序的4倍、算力的6倍、锂电池的18倍。
性格即UX。 大量对Opus 5.5的兴奋并非源于"它能做前所未有的事",而是"用起来终于又成了一种享受"。即便是最看重性能、最愿意随时切换的早期采用者,也有明确的性格偏好。这提示我们:对LLM而言,性格就是用户体验,应当被当作一等公民对待。
模型已难与"框架"(harness)分离。 Prime Intellect的Will Brown吐槽自己每周都在切换桌面智能体,疲于奔命。对深度绑定Codex生态的用户,只要OpenAI的选项"够接近",就未必会因Opus 5.5更强而迁出。真正的检验在一周后——是否真有人因这次发布改变了整体工作习惯,还是测完各回各家。
可能进入"产品时代"而非"模型时代"。 在模型发布的同时,Meta的Muse成为另一个话题焦点,而用户几乎不关心其底层模型。如果模型开始被抽象进系统,整个"新模型对比"的叙事逻辑都可能被改写。
这就是"节制前沿"该有的样子。 正如Theo所说,今天没有一款是Astra或Fable级别的发布,这是有意为之——节制的目标不是停止迭代,而是防止更大模型的研发失控。用更低成本、更高效率解决既有模型的具体问题,是个"风险小、真实收益多"的好方向。
从战略看,OpenAI延续其一贯打法:激进压低成本,为"复杂模型架构"时代铺路,让不同智能匹配不同任务;而Anthropic这次更像是一次夺回势头的反攻,并且相当成功。正如Every的结论:Sol像一次"S级iPhone发布",Opus 5.5则是更大的惊喜——它正把一些人从Codex拉回Claude阵营。
Terminal Bench、Cursor Bench、Humanity's Last Exam等基准测试是当前AI领域主要的第三方能力评测工具。Terminal Bench专注于终端/命令行环境下的代码执行与任务完成能力;Cursor Bench则模拟真实IDE(代码编辑器)场景中的编程辅助任务;Humanity's Last Exam(HLE)是一套由学术界设计的极难题库,涵盖数学、科学、人文等多领域,旨在测试模型的边界推理能力,通过率普遍较低。Artificial Analysis的"智能指数"则是一个综合多项基准的加权排名,试图提供跨模型的横向比较基准。这些评测的局限在于:它们反映的是特定任务上的静态表现,未必能预测模型在真实工作流中的体验,这也是为何社区评测(如Box、Zapier的实际业务测试)往往比官方基准更受开发者重视。
相关推荐
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。

mcp.so 实用指南:一站式发现MCP服务器扩展AI编程能力
mcp.so 是一个发现 MCP 服务器的目录平台,帮助 AI 编程开发者为智能体连接外部工具和服务。本文介绍它的功能、使用方法以及对 AI 工作流的价值。

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。