Opyt:把你关注的X和Substack内容变成个人知识库
Opyt 是开源个人知识库工具,能聚合多平台收藏并由 AI 主动追问扩展知识边界。
Opyt 是一款开源、免费的个人知识管理工具,旨在将用户散落在 X 书签、Substack 订阅、GitHub、arXiv 等平台的收藏内容聚合成可检索的结构化知识库。与普通"稍后读"工具不同,Opyt 具备主动性:它会通读已收集的主题,自动生成后续追问,并持续挖掘相关新内容,形成"读—提问—再检索"的循环。工具采用 MIT 许可证,支持本地存储,数据无需上云,对隐私敏感用户友好。知识库还可作为大语言模型的上下文来源,让 AI 基于用户精选资料而非泛化训练数据回答问题。项目由 David Maimon 打造,在 Product Hunt 获得 75 票,适合需要系统性追踪领域动态的研究者和重度信息消费者。
在信息过载的时代,我们每天在X(原Twitter)上收藏推文,订阅Substack专栏,追踪GitHub仓库和arXiv论文,却很少真正回头消化这些内容。收藏夹逐渐变成了信息坟墓。开源工具 Opyt 试图解决的正是这个痛点——它把你已经在关注的人和话题,转化为一个可以持续检索、探索和深挖的个人知识库。
Opyt 是什么
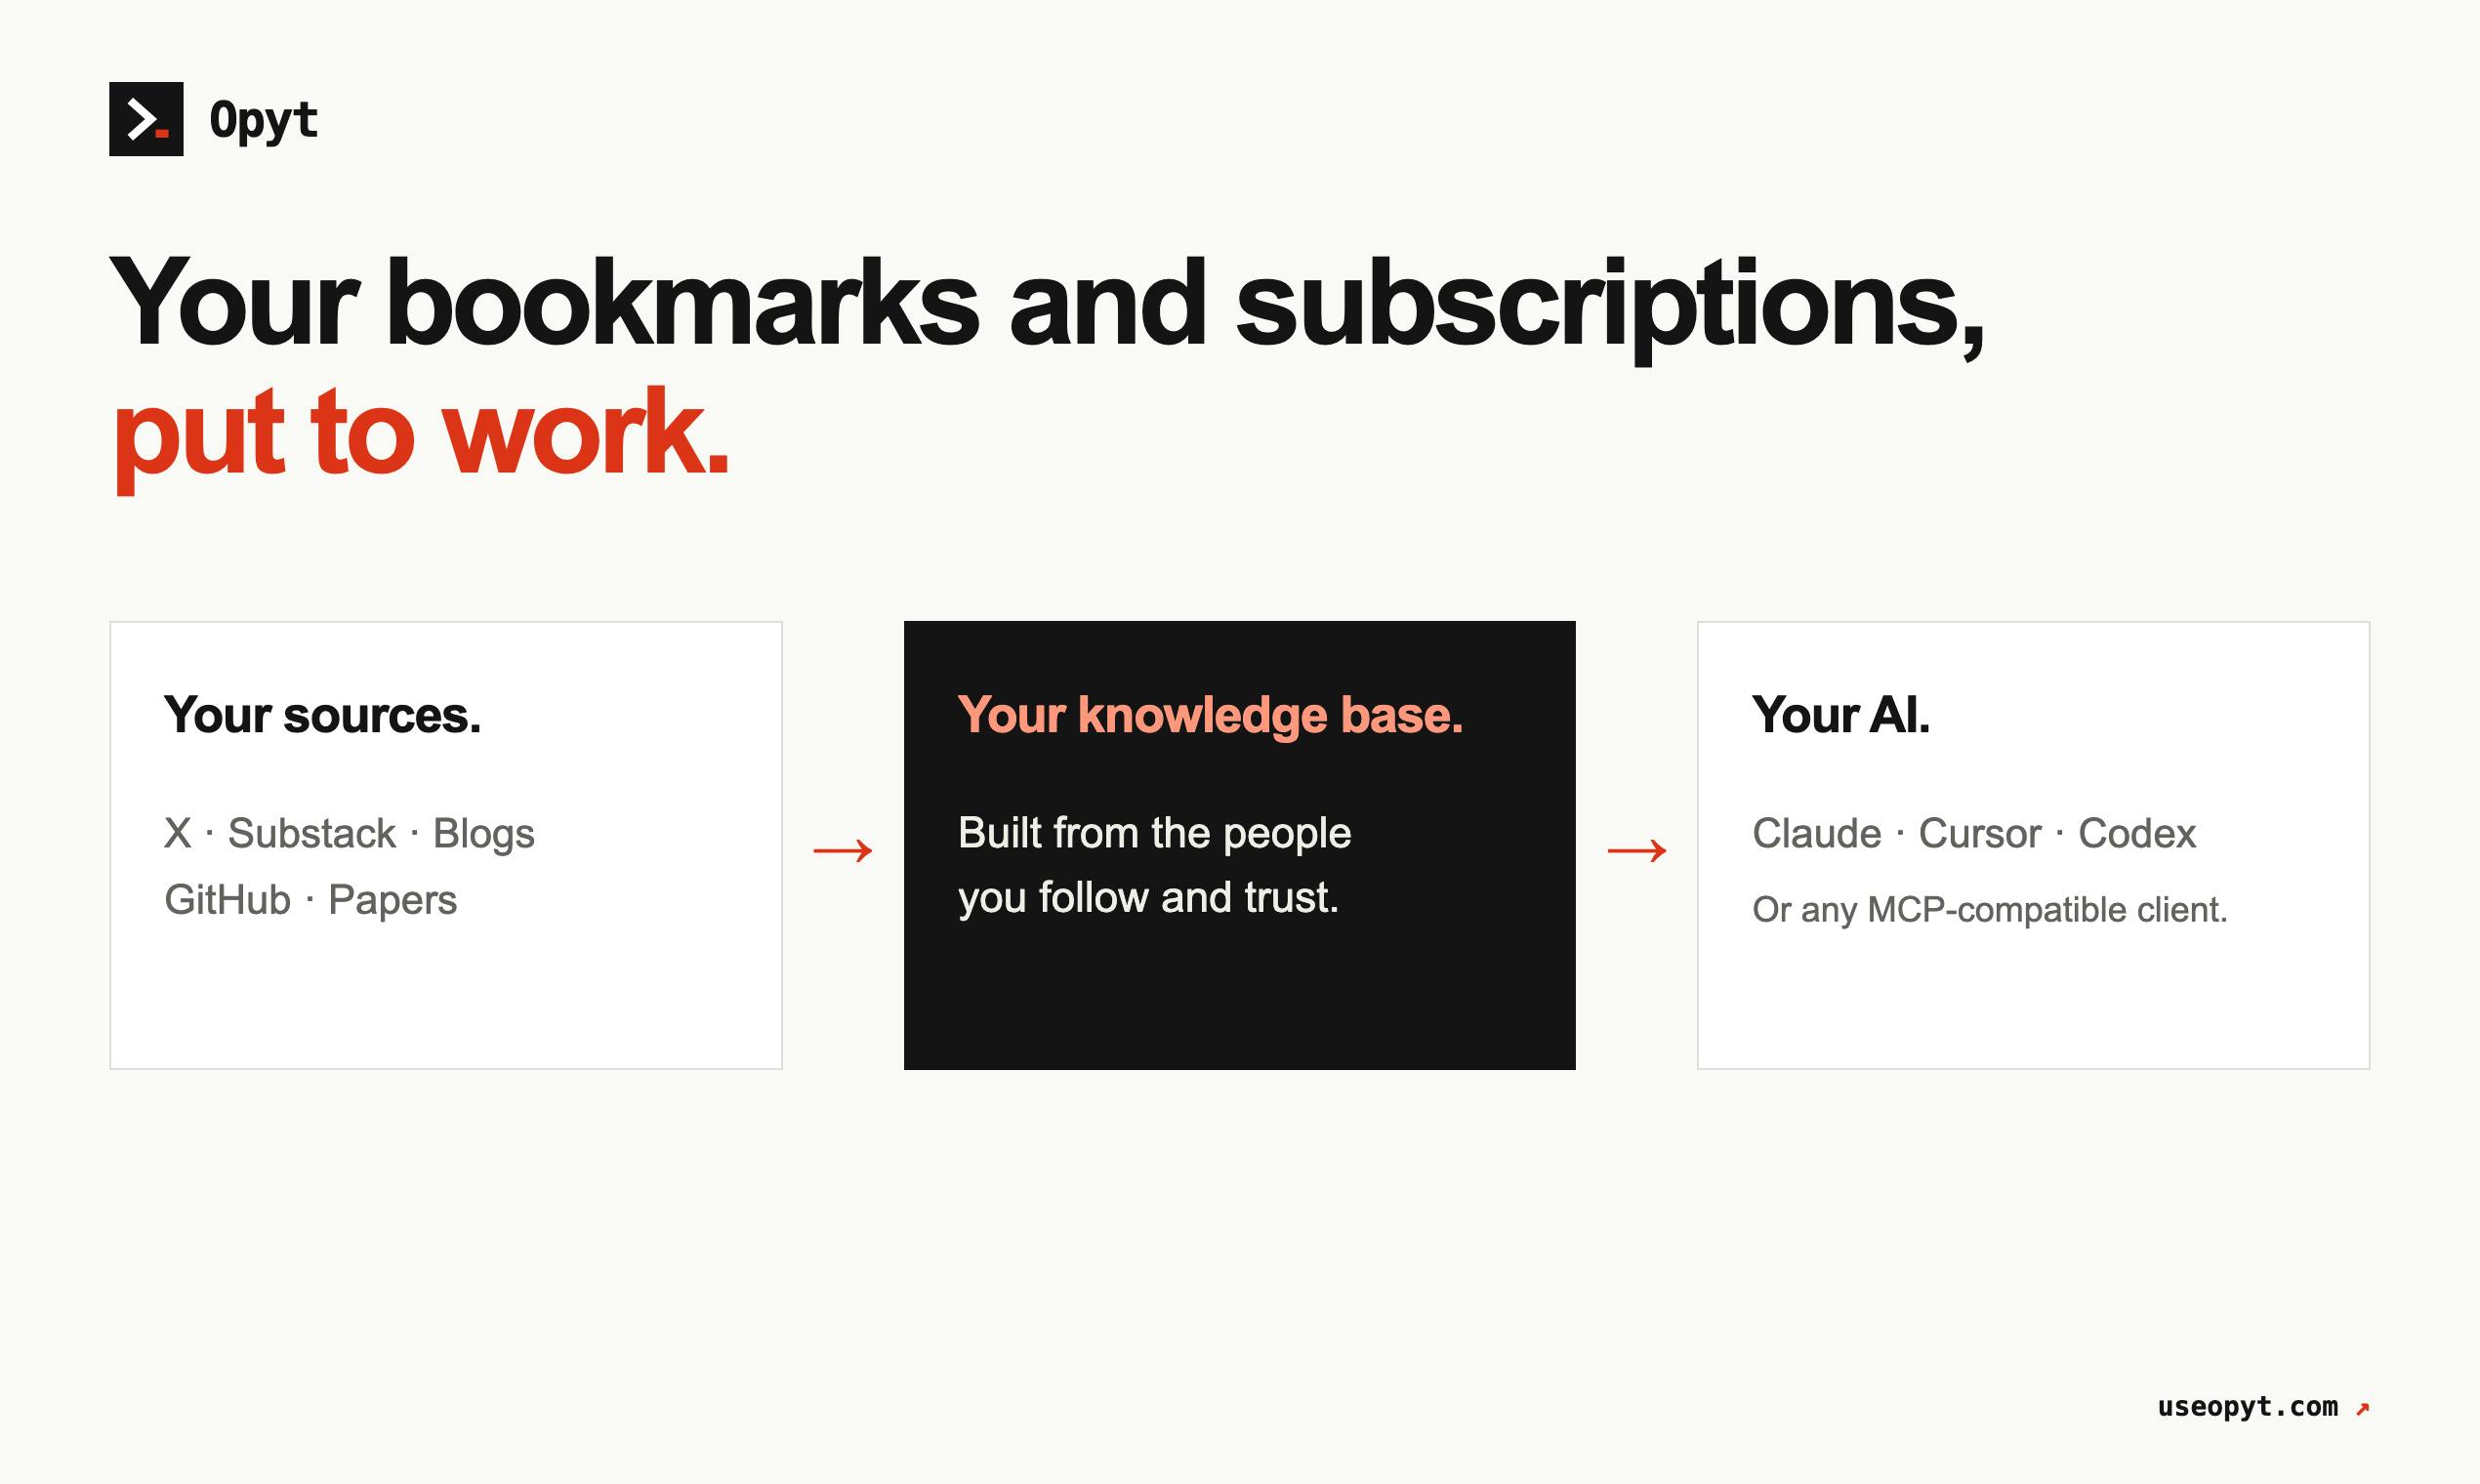
Opyt 的核心理念很直接:你已经在做筛选信息的工作了——收藏、订阅、star——只是这些动作产生的价值没有被有效利用。Opyt 把这些散落的信息源聚合起来,构建成结构化的知识库。
你可以把它指向多种数据源:X 上的书签(bookmarks)、Substack 订阅、个人博客、GitHub 仓库,甚至是 arXiv 上的学术论文。Opyt 会抓取这些来源的历史存档(archives),而不只是最新的几条内容,从而形成更完整的语料积累。
这个项目在 Product Hunt 的开源、Twitter、GitHub、Search 等分类下亮相,由 David Maimon 打造,获得了 75 票,排名当日第 16 位。
主动探索:它会自己提问
Opyt 与普通的稍后读(read-it-later)工具最大的区别,在于它的"主动性"。根据官方描述,Opyt 会通读一个主题(reads a topic through),然后基于内容自己生成后续追问(writes its own follow-up questions),并持续寻找那些在你已收集内容之上有所延伸的新作品。
这意味着它不是被动地存储你丢进去的东西,而是像一个研究助手一样,围绕你关心的主题主动扩展知识边界。当你在某个领域积累了一批资料后,它能帮你发现"这个话题还有哪些相关的新进展",避免你在信息海洋里漏掉关键更新。
这种"读—提问—再检索"的循环,本质上是把 AI 的检索增强能力嵌入到了个人信息管理流程中。
这种设计在技术上与"检索增强生成"(RAG,Retrieval-Augmented Generation)密切相关。RAG 是当前 AI 应用的主流架构之一:与其让大语言模型完全依赖训练时固化的知识,不如在推理时动态检索外部文档,将检索到的内容作为上下文一并输入模型,从而让回答更贴近特定领域或最新信息。Opyt 的"读—提问—再检索"循环,本质上是将 RAG 的思路应用于个人信息管理:知识库充当向量数据库,AI 则负责理解语义、生成追问并驱动新一轮检索。对用户而言,这意味着知识库不只是静态存档,而是能随主题自动生长的动态图谱。
开源、免费与本地优先
Opyt 有几个对隐私和成本敏感用户很有吸引力的特性:
- 完全免费:无付费墙。
- MIT 许可证:这是最宽松的开源协议之一,允许自由使用、修改和商用。
- 本地化:你的知识库可以保存在本地(stay local),数据不必强制上云。
对于那些不希望自己的阅读习惯、收藏内容被第三方平台掌握的用户来说,本地优先的设计是一个明显的加分项。同时,MIT 协议也意味着开发者社区可以在此基础上自由构建和定制。
此外,官方还提到"让你的 AI 来读完这一切"(let your AI read it all),暗示知识库可以作为 AI 的上下文来源——你可以把整个知识库喂给大模型,让它基于你精选的资料回答问题,而不是依赖泛泛的互联网训练数据。
"本地优先"(Local-first)是近年软件设计领域的一股思潮,核心主张是:用户数据应默认存储在本人设备上,云同步是可选项而非强制要求,从而保障离线可用性、响应速度和数据自主权。与之对比,大多数 SaaS 知识管理工具(如 Notion、Readwise)将用户数据托管在云端服务器,订阅一旦停止便面临数据访问风险。Opyt 的本地优先定位,配合 MIT 开源协议,意味着即便项目停止维护,用户依然拥有完整的数据和代码,不存在被平台锁定(vendor lock-in)的隐患。这对需要长期维护知识资产的研究者尤为重要。
它适合谁
从功能定位看,Opyt 更像是面向重度信息消费者和研究型用户的工具:
- 需要长期追踪特定领域动态的研究者、分析师;
- 在 X 和 Substack 上有大量收藏和订阅、却苦于无法有效利用的知识工作者;
- 关注开源、重视数据自主权,愿意自己部署工具的技术用户。
如果你只是偶尔看看资讯,Opyt 可能显得过重;但如果你已经在多个平台上系统性地积累信息,它提供的聚合+主动探索能力,确实能把"收藏即遗忘"的困境转化为可用的知识资产。
小结
Opyt 代表了个人知识管理工具的一个演进方向:不再是单纯的存储和标签,而是把 AI 的检索、追问能力融入进来,让工具主动帮你延伸认知。加上免费、MIT 开源和本地优先的定位,它对隐私敏感的深度用户有相当的吸引力。
当然,作为一个刚在 Product Hunt 亮相的早期项目,其实际抓取效果、AI 提问的质量以及各平台数据源的稳定性,还需要更多真实使用来验证。对感兴趣的用户来说,开源的特性至少意味着可以先自行部署试用,风险很低。
相关推荐
WAN 2.1 物理动效 LoRA 横评:11 款实测排名与方法论
一位 Reddit 用户用光流分析对 WAN 2.1 上 11 款物理动效 LoRA 做了控制变量横评,仅 3 款真正有效,4 款效果低于对照组。本文解析测评方法、量化数据与冠军 LoRA 的物理正确性。
Lucid与Bolt达成合作,剑指欧洲Robotaxi市场
Lucid Motors宣布与欧洲移动出行平台Bolt达成合作意向,共同探索欧洲Robotaxi市场,但目前尚未落地车辆订单。本文解析这一合作的背景、模式与行业意义。
谷歌英伟达联手Emerald AI:破解数据中心电网困局
谷歌、英伟达、Anthropic 联合 Emerald AI 组建新联盟,计划为数据中心寻找 100 GW 电网容量,破解 AI 算力扩张下的电力瓶颈。本文解析联盟构成与技术路径。