Oracle引导微调:让生成式ASR后编辑学会选择与重写

Oracle引导微调将N-best列表转化为三池监督信号,训练ASR后编辑模型学会选择或重写。
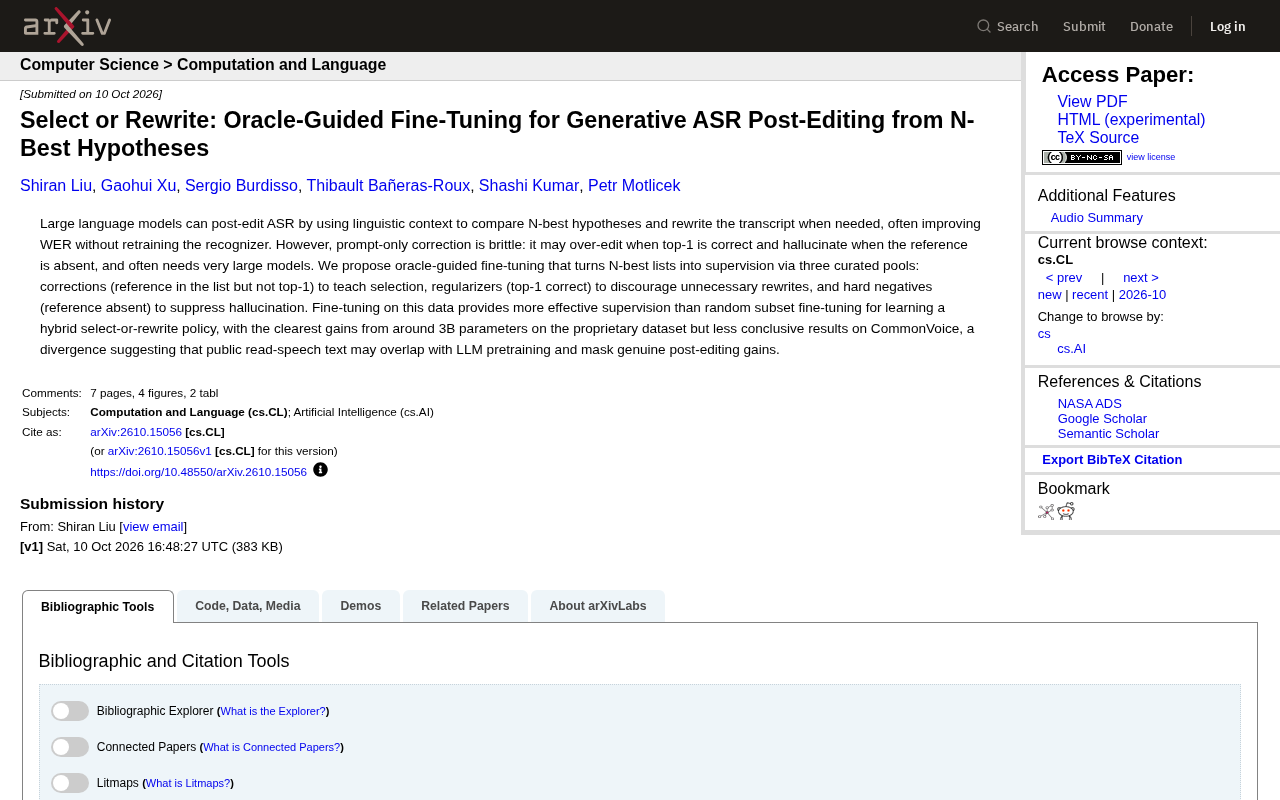
本文针对基于LLM的ASR后编辑方法存在的过度编辑、幻觉和模型规模依赖三重困境,提出Oracle引导的微调方法。该方法将N-best列表按参考文本位置划分为修正池、正则化池和难负样本池,分别训练模型的选择、克制和防幻觉能力,形成混合的select-or-rewrite策略。实验表明,在专有数据集上约3B参数起效明显,而CommonVoice上结论不明确,可能源于公共文本与LLM预训练数据的重叠。研究将ASR后编辑从推理时的提示工程重新定义为监督学习问题,强调N-best列表作为训练监督来源的价值,并提醒评估时需警惕预训练污染。
Oracle引导微调:让生成式ASR后编辑学会选择与重写
大语言模型正在改变自动语音识别(ASR)的后处理范式。不再需要重新训练识别器,只需用语言上下文比较N-best候选假设,并在必要时重写转写文本,就能降低词错误率(WER)。但这条路径并非没有代价——仅靠提示词的纠错方式相当脆弱:当top-1本身正确时可能过度编辑,当参考文本不在候选列表中时可能产生幻觉,而且往往依赖参数量极大的模型才能奏效。
针对这些痛点,一篇新研究提出了Oracle引导的微调方法,将N-best列表转化为监督信号,训练模型学习一种混合的"选择或重写"策略。
提示词纠错的三重困境
现有基于LLM的ASR后编辑方案,核心思路是在提示词中放入N-best假设列表,让模型结合语言知识进行判断。这种做法有两个显性优点:不需要改动识别器本身,也无需额外训练数据。但研究指出,它的脆弱性体现在三个层面。
过度编辑是第一重风险。当N-best列表的top-1已经正确时,模型仍可能出于"纠正冲动"而改写输出,反而引入新错误。幻觉是第二重风险。如果参考文本根本不在候选列表中,模型缺乏可靠依据,却可能凭空生成看似合理的内容。模型规模依赖则是第三重约束——提示词方案通常需要非常大的模型才能稳定工作,这限制了实际部署的灵活性。
N-best列表是ASR系统的标准输出形式:识别器在解码时保留概率最高的N个候选转写(通常N取5到10),而非仅输出单一结果。N-best列表的价值在于它保留了声学模型和语言模型在解码时的不确定性信息——正确转写往往就藏在top-1之外的某个候选中。传统ASR系统利用N-best列表进行重打分(rescore),即用更强的语言模型对候选重新排序;而基于LLM的后编辑则更进一步,不仅重新排序,还可能生成列表中不存在的新文本。理解N-best的结构是理解本文方法的前提:修正池和难负样本池的划分,本质上就是根据参考文本在N-best列表中的位置来定义的。
**词错误率(WER)**是ASR领域最核心的评估指标,计算方式为替换(S)、删除(D)、插入(I)三种错误之和除以参考文本的总词数,即 WER = (S+D+I)/N。WER越低表示转写越接近人工标注的参考文本。需要注意的是,WER对插入错误同样敏感——这正是本文强调"过度编辑"风险的原因:即使模型修正了原有的替换错误,若同时引入了新的插入或替换,WER可能不降反升。在生成式后编辑场景中,模型面对的是一个"改写还是不改写"的决策,WER的增减取决于改写带来的净收益,而非简单的错误数量比较。
三池监督:把N-best列表变成训练数据
该研究的核心创新在于,不再依赖推理时的提示词技巧,而是从N-best列表中挖掘监督信号,通过三个精心设计的样本池来塑造模型行为。
修正池(corrections):参考文本存在于N-best列表中但不在top-1位置。这类样本教会模型"选择"——识别出列表中被埋没的正确候选。这是学习选择能力的核心素材。
正则化池(regularizers):top-1本身正确。这类样本的作用是"抑制"——让模型学会在无需修改时保持克制,减少不必要的重写。
难负样本池(hard negatives):参考文本完全不在列表中。这类样本用于"压制幻觉"——当正确答案不存在时,模型应当避免凭空编造。
三个池子分别对应选择、克制、防幻觉三种能力,共同支撑起一个混合的select-or-rewrite策略。这种数据构造方式,比随机子集微调提供了更有效的监督信号。
Oracle信息在语音识别中指代推理时无法获得的"标准答案"——即参考文本(ground truth)。在训练阶段,研究者可以访问参考文本,据此判断N-best列表中哪些候选正确、哪些错误,从而构造监督信号。本文的"Oracle引导"正是利用这一训练时才有的信息来标注样本归属:参考在列表中但非top-1则归入修正池,top-1已正确则归入正则化池,参考完全缺席则归入难负样本池。这种思路借鉴了机器翻译中"质量评估"和"选择性重写"的监督范式,核心在于将推理时不可得的Oracle信号转化为训练时的监督标签。
规模效应与数据集分歧
实验结果揭示了一个有趣的现象。在专有数据集上,从约3B参数量开始,微调带来的增益最为清晰——模型规模足够大时,三池监督的效果得以充分释放。
但在CommonVoice数据集上,结论却不够明确。研究对此给出了一个值得注意的解释:公共朗读语音文本可能与LLM的预训练数据存在重叠,这种重叠会掩盖真实的后编辑增益。换句话说,模型在CommonVoice上的"好表现"可能部分来自记忆而非真正的后编辑能力。这一分歧提示我们,评估生成式ASR后编辑时,数据集的预训练污染问题不容忽视。
预训练数据污染是指评估数据集的内容在LLM预训练阶段已被模型见过,导致模型在测试时可能依靠记忆而非真正的泛化能力取得好成绩。CommonVoice作为公开的众包朗读语音数据集,其文本内容(多为维基百科句子、常见表达)极有可能出现在LLM的训练语料中。当N-best列表中的候选与预训练记忆高度吻合时,模型即使没有真正学会后编辑,也能"碰巧"输出正确结果,从而掩盖微调带来的真实增益。这一现象在生成式NLP评估中已被广泛讨论,本文将其引入ASR后编辑领域,提示研究者在公开基准上验证方法时需设置污染检测或使用专有数据集作为对照。
对ASR后编辑实践的启示
这项工作的价值不仅在于提出了一种微调方法,更在于它重新定义了问题的框架。传统思路把LLM后编辑视为推理时的提示工程问题,而该研究将其转化为监督学习问题——用oracle信息指导模型学习何时选择、何时重写。
对于实际系统而言,这意味着两件事。其一,构建N-best列表的价值被进一步放大:它不仅是推理时的输入,更是训练时的监督来源。其二,模型规模的阈值效应(约3B起效)为部署决策提供了参考,同时也暗示小模型可能需要其他补偿手段。CommonVoice上的模糊结果则是一个提醒:在公开基准上验证ASR后编辑方法时,需要警惕预训练数据重叠带来的虚高表现。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。