Ordewell:把一个目标拆解为有序的编程Agent任务链

Ordewell 将复杂编程目标自动拆解为有序任务链,专注填补AI编程生态的规划编排层。
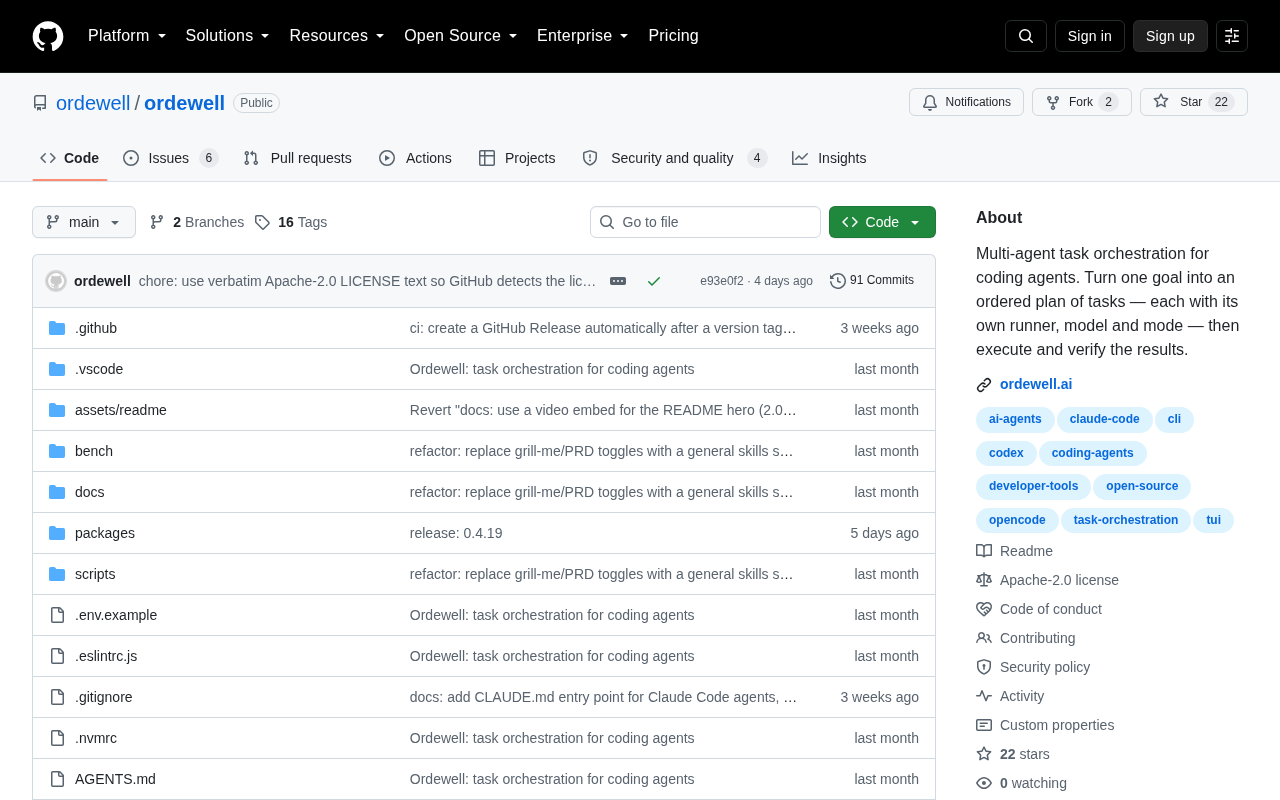
Ordewell 是一个以 Show HN 形式亮相的早期项目,核心思路是将一个高层次的编程目标自动分解为具有明确先后依赖关系的任务链,交由下游编程 Agent 逐步执行。它直指当前单 Agent 处理复杂多步骤任务时的典型痛点:上下文窗口限制导致前期约束丢失、任务依赖关系被忽视、整体进度难以追踪。在 AI 编程工具的分层生态中,Ordewell 定位于代码生成与执行层之上的"规划与编排层",本身不直接生成代码,而是输出结构化的可执行任务列表。目前项目信息有限,拆解质量、用户干预机制及与主流 Agent 框架的集成程度等关键问题仍待验证。
从单一目标到有序任务链
随着编程Agent(Coding Agent)逐渐走入开发者的日常工作流,一个越来越突出的痛点浮现出来:单个Agent擅长执行明确的小任务,却往往难以驾驭复杂、多步骤的工程目标。Ordewell 正是针对这一问题提出的解决方案——它的核心理念是把一个高层次的目标(goal)自动拆解为一系列有先后顺序的编程Agent任务。
这个项目最近以 Show HN 的形式出现在 Hacker News 上。虽然目前讨论热度还不高(发布时约 5 个赞、暂无评论),但它触及的方向恰恰是当前 AI 编程工具生态中被反复讨论的关键环节:任务编排(task orchestration)。
为什么需要“有序”的任务规划
让大语言模型驱动的Agent一次性完成一个大目标,通常会遇到几类典型问题:上下文窗口有限导致后续步骤丢失前期约束、任务之间存在依赖关系却被并行或乱序执行、以及缺乏对整体进度的可追踪性。
Ordewell 强调的“ordered plan”(有序计划)正是在回应这些问题。它不满足于把目标简单地切成若干子任务,而是要为这些子任务建立执行顺序——哪一步必须先完成、哪些结果是后续步骤的输入。这种依赖关系的显式化,理论上能显著提升多步骤编程任务的成功率和可控性。
拆解与排序的价值
在实际的软件工程中,一个看似简单的目标(例如“为现有项目添加用户认证功能”)往往隐含着数据库schema调整、后端接口实现、前端页面对接、测试编写等多个环节,且这些环节之间存在严格的先后逻辑。如果交给单个Agent一股脑处理,很容易出现前后不一致或遗漏。Ordewell 试图把这种人类工程师本能进行的“规划-排序”过程产品化。
在Agent工具生态中的定位
当前市面上的AI编程工具大致可以分为几层:底层是代码生成模型,中间是执行层(能读写文件、运行命令的Agent),而 Ordewell 想切入的是更上层的“规划与编排层”。它本身不一定直接生成代码,而是负责把目标转化为一份结构化的、可供下游编程Agent逐条执行的任务列表。
这种分层思路与业界正在形成的共识一致:随着Agent能力增强,如何有效地组织和调度多个Agent、如何管理复杂任务的分解,正成为决定实际生产力的关键。Ordewell 作为一个专注于“计划生成”的轻量工具,填补的正是这一环。
任务编排(task orchestration)在 Agent 框架领域已形成若干代表性方案。LangChain 的 Agent Executor、微软的 AutoGen 多智能体对话框架、以及 LlamaIndex 的 Workflow 模块,都在不同层面解决"如何让多个 Agent 协同完成复杂目标"的问题。与这些通用框架相比,Ordewell 的差异化定位在于专注编程场景,并以"生成可执行任务列表"为单一职责,属于更垂直、更轻量的切入点。业界也有 Devin、SWE-agent 等尝试端到端自主完成软件工程任务的系统,但它们将规划与执行合并在同一Agent内,而 Ordewell 的思路是将规划层显式剥离,让下游执行Agent保持专注。
尚待验证的问题
作为一个刚刚亮相的早期项目,Ordewell 目前公开的信息还相当有限。从Show HN帖子本身来看,尚缺乏对其技术实现细节、支持的Agent框架、以及实际拆解效果的具体说明。
几个值得关注的问题包括:任务拆解的质量如何保证?当拆解结果不理想时,用户能否介入调整任务顺序或内容?它与主流编程Agent(如各类IDE内置Agent或命令行Agent)的集成程度如何?这些都需要更多实践反馈来验证。对于任何一个规划类工具而言,拆解的准确性和可干预性往往比“能拆解”本身更重要。
小结
Ordewell 代表了AI编程工具向“编排层”演进的一个具体尝试。它抓住了单Agent处理复杂目标时的真实痛点,用“有序任务链”的思路提供解法。尽管项目仍处早期、社区反响有限,但其方向与整个Agent生态的发展趋势高度契合。对于关注AI辅助开发工作流的开发者来说,这类专注任务编排的工具值得持续留意。
背景补充
上下文窗口限制是当前大语言模型在长任务中失效的核心原因之一。主流模型的上下文窗口虽已扩展到数万乃至数十万 token,但随着对话轮次增加,模型对早期约束条件的"注意力"会显著衰减,出现所谓"lost in the middle"现象——即位于上下文中段的关键信息被有效忽略。对于多步骤编程任务,这意味着第一步确定的架构决策、命名规范或接口契约,可能在第五步时已被模型遗忘。将大目标拆解为独立的短任务,每个任务拥有自己干净的上下文,是规避这一问题的工程实践方向。
相关推荐

WorkBuddy入门指南:让AI真正替你上班的桌面智能体
WorkBuddy是一款能直接操作本地电脑的桌面AI智能体。本文详解其定位、与CodeX的差异、常见认知误区及文件管理、协同办公等实战能力,帮你从AI提问者进化为AI管理者。

LangGraph入门指南:AI Agent的操作系统全解析
LangGraph 被称为 AI Agent 的操作系统,本文系统梳理其与 LangChain 的关系、状态节点边三大要素、持久化 checkpoint、human-in-the-loop 及子图等核心能力与学习路径。

吴恩达谈Agentic AI:拨开炒作看智能体构建的核心技能
吴恩达 Agentic AI 课程开讲,剖析智能体炒作背后的真实价值。从客户支持、法律文档到医疗诊断的落地场景,揭示评估与错误分析为何是构建智能体工作流的核心技能。