吴恩达谈Agentic AI:拨开炒作看智能体构建的核心技能

吴恩达拆解Agentic AI炒作,指出评估与错误分析是构建真正可用智能体的核心工程方法。
吴恩达在其Agentic AI课程中直面行业炒作现象——他本人创造的"agentic"一词已被营销化滥用,但泡沫之下真实落地的应用仍在稳步增长。课程列举了客户支持、法律文档处理、医疗辅助诊断等已验证的实际场景,说明智能体工作流已成为部分复杂应用不可或缺的基础设施。课程最具价值的洞察在于:区分优秀与普通智能体开发者的关键,不是prompt技巧,而是能否建立以评估(Evals)和错误分析(Error Analysis)为核心的纪律化开发流程。这套方法论——系统测量输出质量、按类型追踪错误根因、数据驱动迭代——才是在Agentic AI浪潮中真正建立竞争壁垒的工程能力。
吴恩达在其 Agentic AI 课程的开场中,直言不讳地谈到了一个行业现象:当他创造 "agentic"(智能体化)这个词来描述基于大模型的应用构建趋势时,并没有料到它会被大量营销人员当作贴纸,贴到几乎所有能看到的产品上。这直接导致了围绕 Agentic AI 的炒作急剧升温。
不过,在这层泡沫之下,真正有价值、有实际用途的 Agentic AI 应用同样在快速增长——只是增速没有炒作那么夸张。理解如何抛开噱头、构建真正可用的智能体工作流,正在成为当下 AI 领域最重要的技能之一。
什么是被过度炒作的 Agentic AI
"Agentic" 一词的本意,是描述人们构建大模型应用方式中一个重要且迅速增长的趋势。但当这个概念被营销化之后,它逐渐失去了原本的技术含义,变成了一个营销标签。吴恩达坦言,这种现象让 Agentic AI 的热度被推到了不切实际的高度。
面对炒作,理性的做法不是全盘否定,也不是盲目追捧,而是把注意力放回到"真正有价值的应用"上。吴恩达强调,即便剥离掉营销包装,实际落地的智能体应用数量依然在稳步上升,这说明这项技术的底层价值是真实存在的。对于开发者而言,关键在于识别哪些是噱头、哪些是真正能解决问题的能力。
Agentic 工作流的真实应用场景
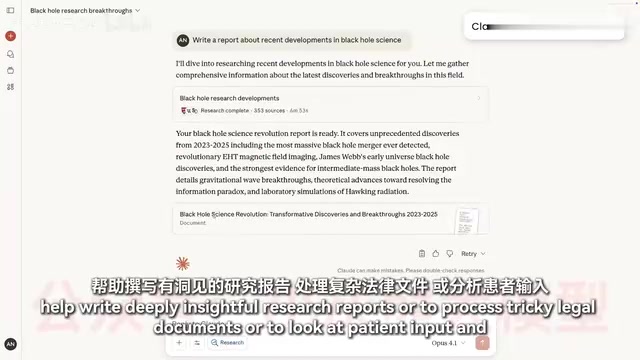
吴恩达列举了多个已经在使用 Agentic 工作流的实际场景,这些例子清晰地展示了智能体技术的落地价值:
- 客户支持智能体:自动处理用户咨询与问题解决
- 深度研究:辅助撰写有深度、有洞察力的研究报告
- 法律文档处理:应对复杂棘手的法律文件
- 医疗辅助诊断:分析患者输入信息,给出可能的诊断建议
他特别提到,在自己带领的许多团队中,有大量项目如果没有 Agentic 工作流根本就无法实现。这一表述背后传递了一个信号:智能体工作流不再只是实验室里的概念,而是已经成为一些复杂应用的必要基础设施。掌握构建这类应用的能力,正是当今 AI 领域最重要、最具价值的技能之一。
Agentic 工作流与传统单次 LLM 调用的根本区别在于多步推理与工具调用的闭环。在单次调用中,模型接收输入、生成输出即告完成;而 Agentic 工作流允许模型在执行过程中动态决策——调用搜索引擎、执行代码、读写文件、调用外部 API,并根据中间结果调整后续行动,直至完成复杂目标。这种能力使其天然适合需要多步骤处理的任务:法律文档分析往往需要先检索相关条款、再逐段比对、最后综合输出结论;医疗辅助诊断则需结合患者描述、查询症状数据库、排除鉴别诊断后才能给出建议。正是这种"规划-执行-观察-再规划"的循环能力,让 Agentic 工作流能够处理此前只能依赖人工完成的复杂认知任务。
区分高手与新手的关键:评估与错误分析
课程中最值得关注的一点,是吴恩达对"什么样的人才能真正把智能体工作流构建好"的观察。他指出,真正懂得构建 Agentic 工作流的人,与那些效率较低的人之间,最大的差异在于——能否推动一个有纪律的开发流程(disciplined development process)。
而这个流程的核心,聚焦于两个关键环节:
评估(Evals)
对智能体的输出进行系统化评估,而不是凭直觉判断效果好坏。可量化的评估机制,是持续优化的前提。
评估(Evals)在 AI 工程中是一套系统化的测试与度量框架,类似于传统软件工程中的单元测试与集成测试。对于智能体应用,评估通常包含三个层面:准确性评估(输出是否正确完成任务)、鲁棒性评估(在边缘输入或异常情况下的表现)以及一致性评估(相同输入是否产生稳定输出)。由于大模型输出具有随机性,传统的精确匹配评分往往不够用,实践中常采用模型打分(LLM-as-Judge)、人工标注、或基于参考答案的语义相似度等方式构建评估集。没有评估体系,开发者只能靠主观感受判断系统是否在"变好",这在多步骤智能体流水线中尤为危险——某一环节的细微退化可能在几轮迭代后才暴露出严重问题。
错误分析(Error Analysis)
深入分析智能体在哪里出错、为什么出错,从而有针对性地改进系统。这种以数据驱动、以错误为导向的迭代方式,正是区分专业开发者与业余爱好者的分水岭。
换句话说,构建优秀的智能体应用,靠的不是一时的灵感或华丽的 prompt 技巧,而是一套严谨、可重复、以评估为核心的工程方法论。
错误分析是机器学习工程中的经典方法论,由吴恩达在其早期机器学习课程中系统推广。其核心步骤是:收集模型出错的样本 → 按错误类型手动分类(如工具调用失败、上下文遗忘、推理跳步等)→ 统计各类错误的占比 → 优先修复影响面最大的错误类别。在 Agentic 场景中,错误来源更为复杂:可能是 prompt 设计缺陷、工具 API 返回格式不符预期、多步推理中的信息损耗,或是模型在特定领域知识上的盲区。系统性地追踪并分类这些错误,能让开发者避免"头痛医头"式的随机修补,转而将有限的优化资源集中在最高价值的改进方向上。
为什么这项技能值得投入
吴恩达在开场中反复强调,掌握 Agentic AI 的构建能力会带来大量新的机会——无论是职业发展上的机会,还是自己动手打造出色软件的机会。
从行业趋势来看,这一判断有其合理性。随着大模型能力的成熟,单纯的"提问-回答"模式已经无法满足复杂业务需求,能够自主规划、调用工具、多步执行的智能体工作流,正在成为下一阶段 AI 应用的主流形态。谁能在这个阶段掌握扎实的构建方法,谁就能在接下来的竞争中占据先机。
对于希望入门或进阶的开发者,吴恩达给出的方向非常明确:不要被炒作牵着走,把精力放在建立系统化的开发纪律上,尤其是评估与错误分析这两个容易被忽视却至关重要的环节。这或许才是这门课程最有价值的启示。
相关推荐
Jev前沿模型问世:成本降40-400倍,速度提升20-200倍
新前沿模型Jev宣称成本降低40-400倍、速度提升20-200倍,引发Hacker News热议。本文解析其性价比卖点、效率突破的可能路径,以及如何理性看待这组惊人数字。
同款模型三大AI Agent横评:DeepSeek Harness、ZCode与Hermes谁更强
同一个GLM Flash模型、相同提示词,分别放进DeepSeek Harness、ZCode和Hermes三大AI Agent中横评对比。实测显示Agent框架差异显著,速度、代码量与最终效果各有高低,DeepSeek Harness综合表现最佳。
DeepSeek扒谱时喊"困了"?聊聊LLM思维链里的拟人化现象
B站UP主发现DeepSeek在扒谱、BPM识别任务的思维链中出现"困了""想睡觉"等拟人化表达。本文解析LLM为何会模仿疲劳、思维链如何放大拟人化现象,以及如何应对模型输出跑偏。