P2NPCBench:当LLM面对P与NP难问题配对,真实推理能力现形
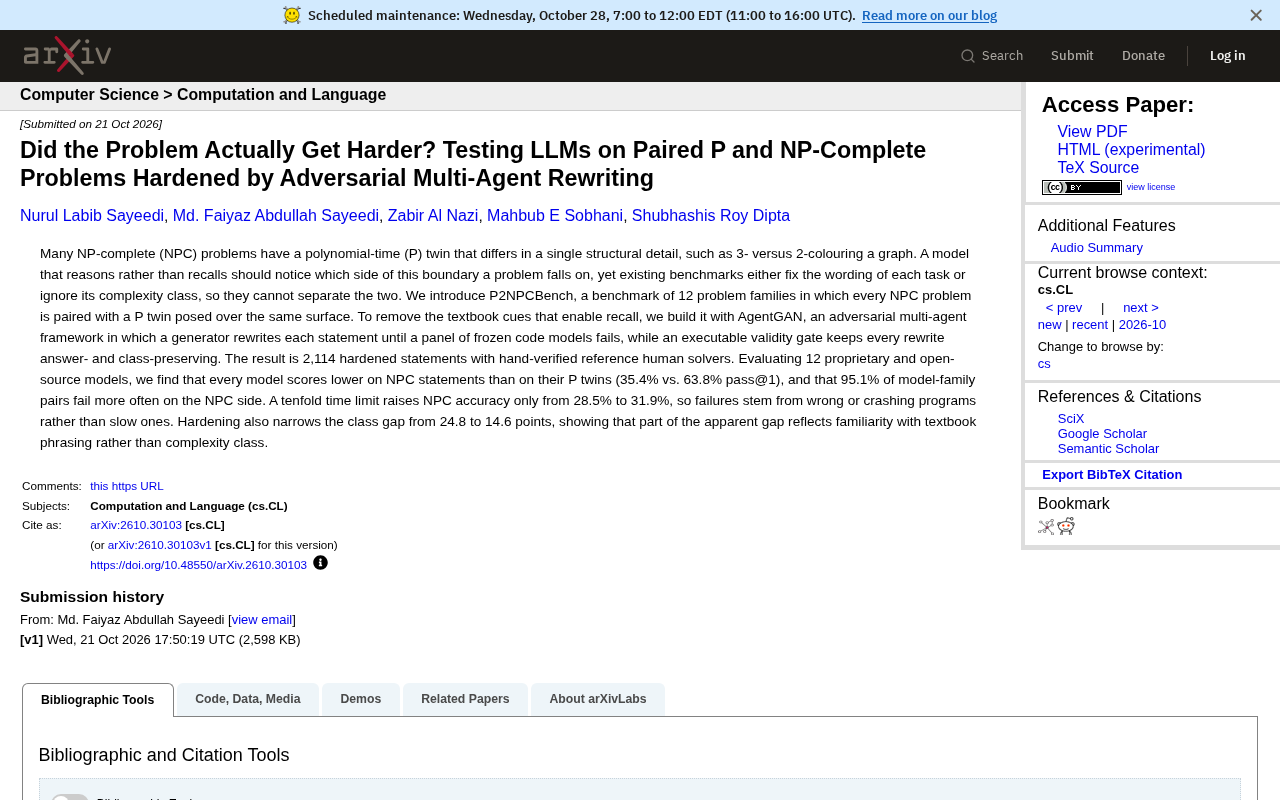
新基准P2NPCBench揭示LLM算法推理依赖表面熟悉度,而非真正理解复杂度。
P2NPCBench 通过配对表面相同的 NP 完全问题和多项式时间可解问题,并利用对抗式多智能体改写去除教科书线索,测试了 12 个语言模型的算法推理能力。结果显示,模型在 NPC 问题上的 pass@1 仅为 35.4%,远低于 P 双胞胎的 63.8%,差距近 28 个百分点,且 95.1% 的模型家族配对中 NPC 侧失败率更高。将时间限制提高十倍仅使 NPC 准确率从 28.5% 升至 31.9%,表明失败源于逻辑错误而非速度。对抗硬化将类别差距从 24.8 点缩小至 14.6 点,说明部分差距源于表述熟悉度。该研究质疑了 LLM 的深层推理能力,并提示评估需控制表述熟悉度这一混淆变量。
大型语言模型在编程和算法任务上表现亮眼,但它们是真正在“推理”,还是仅靠记忆教科书中的模式匹配?一项名为 P2NPCBench 的新基准测试给出了令人清醒的答案。研究者构建了 12 组问题家族,每组包含一个 NP 完全(NPC)问题和一个表面表述相同的多项式时间(P)可解“双胞胎”,并通过对抗式多智能体改写去除教科书线索。结果发现,12 个专有与开源模型在 NPC 问题上的 pass@1 仅为 35.4%,而其 P 双胞胎上高达 63.8%——差距接近 28 个百分点。
问题设计:配对 P 与 NPC 问题,剥离记忆线索
许多 NP 完全问题都有一个仅差一个结构细节的多项式时间版本,例如图的 3-着色与 2-着色。理论上,真正理解复杂度边界的模型应能区分两者;但现有基准要么固定任务措辞(便于记忆),要么忽略复杂度类别,无法将推理与回忆分开。
P2NPCBench 的核心创新在于“同表面配对”:每个 NPC 问题都配有一个表述风格完全一致的 P 版本。为避免模型因熟悉教材句式而“认题”,团队开发了 AgentGAN——一个对抗式多智能体框架。生成器智能体反复改写题目陈述,直到一组冻结的代码模型集体答错;同时,一个可执行的合法性门控确保每次改写都保持答案与复杂度类别不变。最终产出 2,114 道经过硬化处理的题目,并附有人工验证的参考解答。
NP 完全(NP-complete, NPC)是计算复杂性理论中的核心概念。一个问题属于 NP 类,如果它的解可以在多项式时间内被验证;而 NP 完全问题则是 NP 类中最难的一类,任何 NP 问题都可以在多项式时间内归约到它。经典例子包括旅行商问题的判定版本、布尔可满足性问题(SAT)和图的 3-着色问题。多项式时间(P)类则包含那些可以在多项式时间内求解的问题。P 与 NP 是否相等是计算机科学中最重要的未解难题之一。对于语言模型而言,区分一个问题是 P 还是 NPC 至关重要:NPC 问题通常需要指数级搜索或启发式近似,而 P 问题存在高效精确算法。因此,表面相似的 P/NPC 配对能有效检验模型是否真正理解问题的计算难度,而非仅仅匹配表面模式。
AgentGAN 是一种对抗式多智能体框架,用于自动改写问题陈述以去除记忆线索。其核心思想借鉴了生成对抗网络(GAN):生成器智能体负责改写题目,判别器则由一组冻结的代码模型组成,它们对改写后的题目进行作答。生成器的目标是生成使这些模型集体答错的题目,同时通过一个可执行的合法性门控确保改写不改变问题的答案和复杂度类别。这种对抗训练过程迫使改写后的题目在保持语义等价的同时,消除模型可能依赖的表面模式(如教材中的固定措辞)。AgentGAN 的输出经过人工验证,最终形成 2,114 道硬化题目。该方法有效分离了模型对表述的熟悉度与其真实推理能力。
核心发现:性能鸿沟与熟悉度陷阱
在对 12 个模型(包括专有与开源)的评估中,所有模型在 NPC 题目上的得分均低于其 P 双胞胎。平均而言,NPC 通过率为 35.4%,P 版本为 63.8%。更关键的是,95.1% 的模型家族配对中,NPC 侧失败率更高。这说明差距并非随机波动,而是系统性的。
研究者进一步测试了时间限制的影响:将时间限制提高十倍,NPC 准确率仅从 28.5% 升至 31.9%。这意味着失败主要源于程序逻辑错误或崩溃,而非运行缓慢——模型并未“想得不够久”,而是“想错了”。
有趣的是,对抗式硬化反而缩小了类别差距:从 24.8 个百分点降至 14.6 个百分点。这暗示,一部分表面上的复杂度差距其实源于模型对教科书措辞的熟悉度,而非真正的复杂度类别理解。硬化去除了这些线索,使差距更真实地反映推理能力。
pass@1 是代码生成评估中常用的指标,表示模型生成的第一个候选程序通过所有测试用例的比例。在 P2NPCBench 中,pass@1 衡量模型对每道题首次尝试的正确率。与 pass@k(允许生成 k 个候选,只要有一个通过即算正确)不同,pass@1 更严格地反映模型单次推理的准确性。该指标对温度采样敏感,通常需要在低温或贪心解码下评估。P2NPCBench 报告 NPC 问题平均 pass@1 为 35.4%,P 双胞胎为 63.8%,这一差距在统计上显著,表明模型在单次尝试中解决 NPC 问题的能力远低于其表面相似的 P 问题。
对AI编程与模型评估的启示
P2NPCBench 的结果对当前 LLM 的算法推理能力提出了质疑。在 AI 编程助手广泛应用的背景下,模型能否区分问题本质的复杂度,直接关系到它们解决新颖问题的可靠性。如果模型仅靠模式匹配,那么面对真实世界中经过改写或包装的算法挑战时,性能可能大幅下降。
该基准也提示,评估模型时需要控制“表述熟悉度”这一混淆变量。未来的基准设计或许应更广泛地采用配对与对抗改写方法,以分离记忆与推理。对于开发者而言,这意味着不能仅凭标准题库的得分判断模型能力,而应关注其在去线索化问题上的表现。
局限与未来方向
P2NPCBench 目前覆盖 12 个问题家族,虽具代表性,但尚未穷尽所有复杂度边界场景。对抗式改写虽能去除教材线索,但也可能引入不自然的表述,影响模型理解。此外,参考解答由人工验证,规模有限。未来工作可扩展问题家族数量,并探索更自然的硬化方式。
总体而言,这项研究提供了强有力的证据:LLM 在算法问题上的表现仍严重依赖表面熟悉度,真正的复杂度推理能力尚有明显欠缺。随着模型规模增长,如何评估并提升这种深层推理能力,将是 AI 研究的关键挑战。
相关推荐

FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。

前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
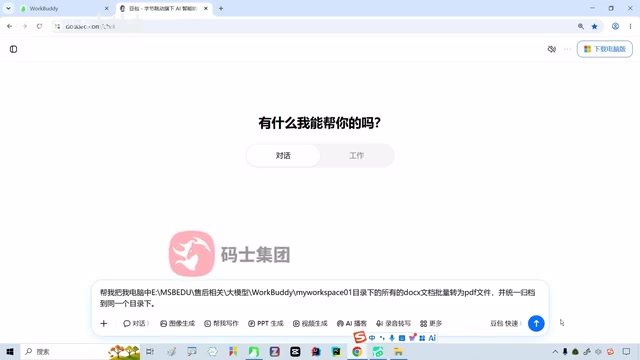
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。