PaperPilot:纯Rust零云端PDF引擎,WASM+MCP双加持
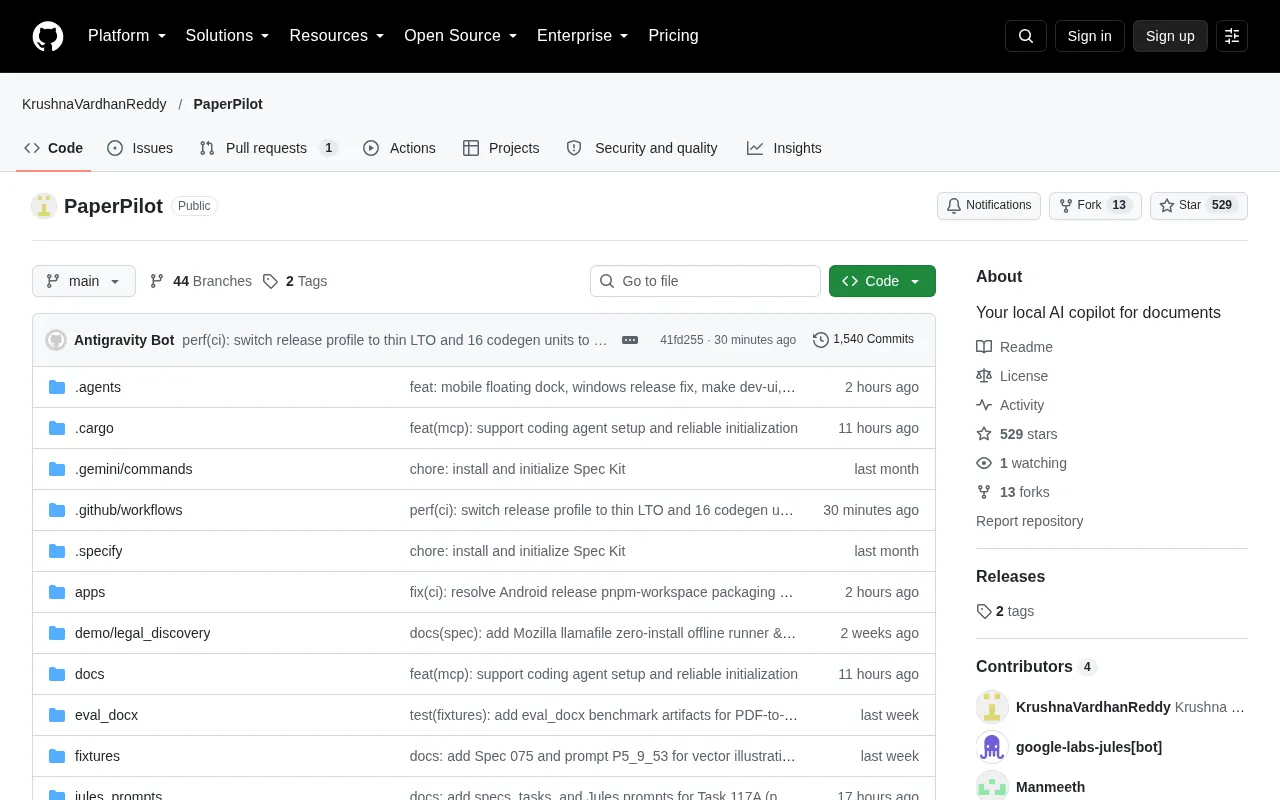
PaperPilot 用纯 Rust 打造本地 WASM PDF 引擎,并通过 MCP 向 AI 开放能力。
PaperPilot 是一个完全在浏览器本地运行的纯 Rust PDF 引擎,通过 WebAssembly 执行,文件不离开设备,直接回应隐私与合规需求。它自研解析与渲染核心,换取对文本抽取、页面结构和安全设计的控制力,但需承担 PDF 规范覆盖度与生态成熟度的代价。项目还通过 MCP 协议将 PDF 能力暴露给 AI 工具,使本地文档可与 AI 应用衔接而无需上传云端。文章分析了其在性能、规范兼容和生态方面的取舍,并指出该架构对本地优先文档产品具有参考价值。
在浏览器里处理 PDF 一直是件尴尬的事:要么把文件上传到别人的服务器,要么忍受 janky 的 JavaScript 库。PaperPilot 这个项目试图给出第三种答案——完全在本地运行的纯 Rust PDF 引擎,通过 WASM 跑在浏览器里,并借助 MCP 协议向 AI 工具开放能力。它在 Hacker News 上拿到的关注度,说明这个方向戳中了不少人的痛点。
为什么「零云端」是个真需求
PDF 是隐私密度极高的一类文档:合同、发票、病历、身份证明,几乎都在这套格式里流转。传统在线 PDF 工具的处理方式是把文件传上去、在服务器上解析、再把结果发回来。对个人用户来说这是信任问题,对企业用户来说这往往是合规红线——很多行业的内部规定直接禁止把客户文档传到第三方服务。
PaperPilot 的思路是把整条链路搬回本地:用 Rust 写解析与渲染核心,编译成 WebAssembly 在浏览器沙箱内执行,文件不出设备。这个组合的吸引力在于,Rust 带来的内存安全与性能,恰好是 PDF 这类二进制格式解析最需要的两项品质——历史上大量 PDF 相关漏洞都来自解析器处理畸形文件时的内存越界。
单从架构选择看,这是一个「把正确的事做对」的方案,而不是又一个把 Python 脚本套上 Web 壳的产品。
纯 Rust PDF 引擎意味着什么
大多数 Web 端 PDF 方案走的是两条路:直接渲染 PDF.js,或者用浏览器内建的预览能力。前者功能完整但代码库庞大、定制困难;后者几乎无法做结构化提取。PaperPilot 选择自研 Rust 引擎,换来的控制力体现在几个层面。
一是解析层面可以做得更细。文本抽取、页面结构、元数据、书签这些信息,纯自研引擎可以按需暴露接口,不必迁就第三方库的抽象。二是渲染路径可以针对 WASM 环境优化,避免为了兼容桌面端而背上不必要的包袱。三是安全性可以沿着 Rust 的所有权模型来设计,把「处理不可信输入」作为一等公民来对待。
代价当然也存在:自研引擎意味着要自己啃 PDF 规范里那些历史遗留的坑,从字体嵌入到加密字典,每一个都可能成为长尾 bug 的来源。
WASM 让本地执行成为默认选项
WebAssembly 在这个方案里不是噱头,而是必要的一环。把 Rust 编译到 WASM,等于同时拿到三样东西:接近原生的执行速度、浏览器提供的沙箱隔离、以及「零安装」的分发体验。用户打开网页就能用,但计算完全发生在本机。
这种部署形态对隐私敏感场景特别合适。用户不需要判断「这个网站可不可信」,因为数据压根没有离开浏览器。对开发者来说,同一份 Rust 核心还可以编译成原生库供命令行或其他宿主使用,WASM 只是其中一个 target,这种「一份核心、多处运行」的结构比维护两套实现要健康得多。
WebAssembly(WASM)是一种可移植的二进制指令格式,由 W3C 标准化,设计目标是让 C/C++/Rust 等系统级语言编译出的代码能在浏览器中以接近原生的速度安全运行。它运行在浏览器的沙箱环境内,无法直接访问文件系统或网络,除非宿主显式授权。与 JavaScript 相比,WASM 的加载与执行更可预测,适合计算密集型任务。将 Rust 编译到 WASM 需要借助 wasm-bindgen 等工具生成 JS 胶水代码,处理内存与类型转换;同时 WASM 的线性内存模型意味着与 JS 之间的数据传递需要显式拷贝,这是性能调优时需要考虑的因素。
MCP 接入:把 PDF 能力交给 AI 工具
项目名称里的 MCP 是另一个值得展开的点。Model Context Protocol 是让 AI 应用调用外部工具能力的协议层,PaperPilot 通过它把 PDF 解析能力暴露出去,意味着 AI 助手可以在本地读取、理解文档,而不必先把文件上传到模型服务商的存储里。
这个组合的意义在于补上了「本地文档 + 云端智能」之间缺失的一环。过去想让 AI 处理一份 PDF,通常的做法是上传文件、在服务端做提取、再把文本喂给模型。而如果解析发生在本地、只把必要的文本片段通过协议传给模型,隐私边界会清晰很多。
需要说明的是,这部分能力的具体实现细节在原始项目信息中并未充分展开,实际可用性还需要读者自行到仓库中验证。
Model Context Protocol(MCP)是由 Anthropic 提出并开源的协议,用于标准化 AI 应用与外部工具、数据源之间的连接方式。它采用客户端-服务器架构:AI 应用作为客户端,通过 JSON-RPC 消息与 MCP 服务器通信,服务器则暴露资源(resources)、工具(tools)和提示模板(prompts)三类能力。MCP 的核心价值在于解耦——工具提供方只需实现一次协议,即可被多个兼容的 AI 客户端调用,而不必为每个模型平台单独适配。在本地运行 MCP 服务器时,数据可以在设备内完成处理,只有必要的结果通过协议返回给 AI 应用,这为隐私敏感场景提供了可行的边界控制方案。
值得关注的取舍与风险
PaperPilot 的方向清晰,但将它放到实际工作流里之前,有几个问题值得想清楚。
规范覆盖度是实现类项目的常见短板。PDF 规范体量庞大且充满历史包袱,一个年轻引擎在复杂文档上的表现需要真实样本检验,光看架构设计无法判断。
性能预期也要现实一点。WASM 比纯 JavaScript 快,但与原生执行仍有差距,处理大体积或高复杂度页面时,渲染耗时是否可接受需要在浏览器里实测。
生态成熟度是另一个变量。纯自研引擎往往缺少围绕 PDF.js 那样多年积累的插件、示例与社区问答,遇到问题时能查到的资料会少很多。
PDF 规范(ISO 32000)自 1993 年诞生以来经历了多次修订,累积了大量厂商扩展与历史遗留特性,例如增量更新、对象流、交叉引用流、多种字体嵌入格式(Type1、TrueType、CID)、加密与权限字典、以及可选的 JavaScript 动作。一个引擎要覆盖真实世界文档,往往需要处理规范之外的非标准实现。业界常用 PDF Association 的 veraPDF 测试套件或 Corpo 语料库来评估覆盖度,但即便如此,长尾文档仍可能触发解析失败或渲染差异。因此评估一个年轻 PDF 引擎时,规范覆盖度比架构设计更能反映实际可用性。
适合谁去尝试
如果你在做需要本地处理文档的产品——尤其是涉及合同、票据、内部资料的场景——这个项目提供了一个值得研究的架构范本:Rust 核心 + WASM 分发 + MCP 对接 AI。即便不直接采用,它展示的「计算留在本地、智能按需调用」的分层思路,对同类产品设计也有参考价值。
对于只想找个在线工具合并 PDF 的普通用户,这个项目目前未必是最省事的选择;但对于在意数据流向的开发者和团队,它代表了一种更可控的方向。
常见问题
PaperPilot 会把 PDF 上传到服务器吗? 按项目描述,解析在浏览器内通过 WASM 完成,文件不离开设备。这是它区别于多数在线 PDF 工具的核心卖点。
MCP 在其中扮演什么角色? 它把 PDF 处理能力以协议形式暴露给 AI 工具,让本地文档可以被 AI 应用调用,而不必先上传到云端。
和 PDF.js 相比如何? PDF.js 生态成熟、覆盖面广;PaperPilot 胜在架构轻量与本地执行思路,但成熟度和规范覆盖需要实际使用来检验。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
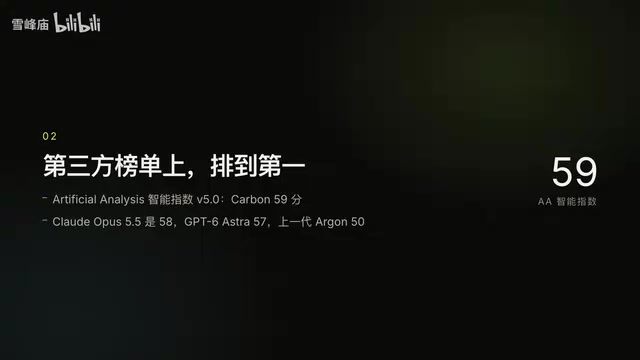
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。