Parsec开源工具:用小模型给AI Agent瘦身上下文
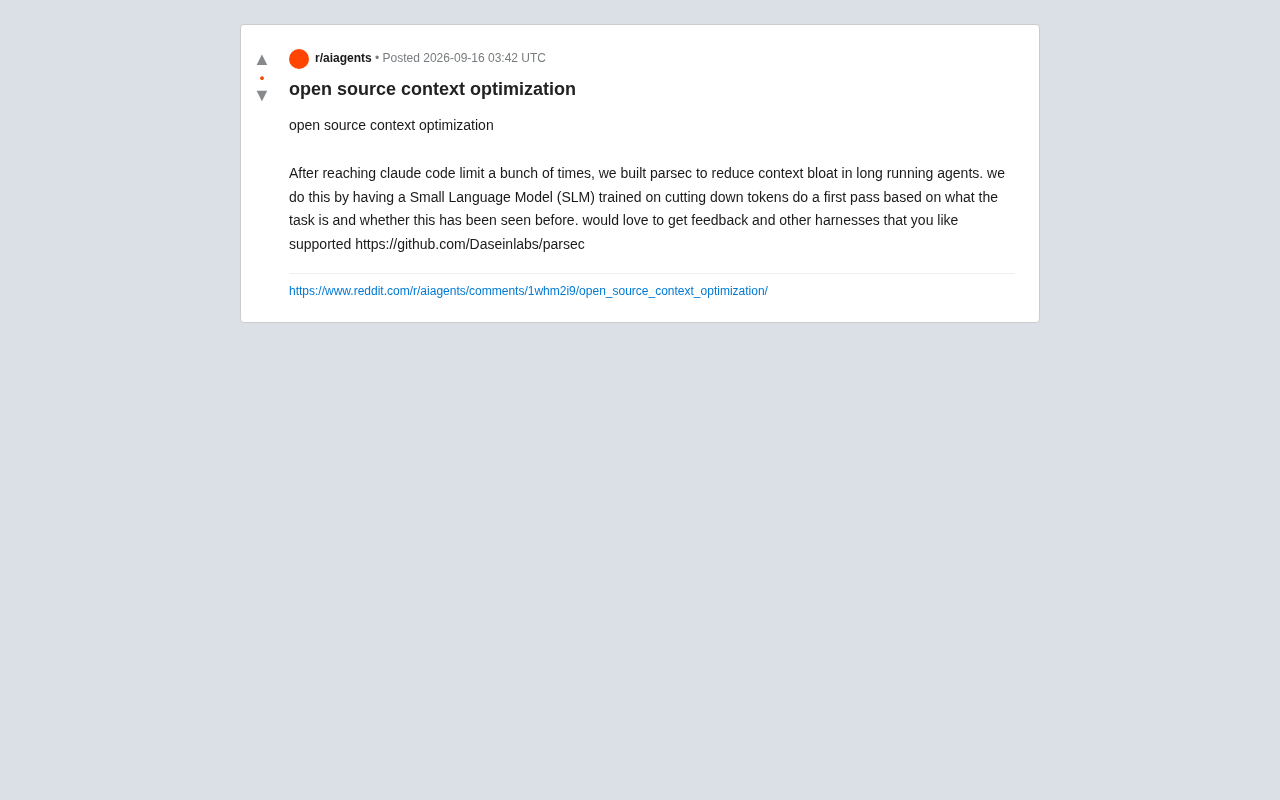
开发者因Claude Code频繁触发配额上限,开源了用小模型预过滤上下文的压缩工具Parsec。
长时运行的AI Agent会不断累积工具调用记录与中间结果,导致上下文窗口被无效信息撑爆,既拉高成本又损害响应质量。开发者因反复撞上Claude Code使用限制,开源了上下文压缩工具Parsec:它引入一个专门训练的小语言模型(SLM),在内容进入主模型前依据"任务类型"与"内容是否重复"两个维度进行裁剪,将识别冗余这一轻量任务交给成本更低的小模型,从而为昂贵的主模型节省token预算。这一"小模型打前站、大模型做决策"的分层架构,正成为Agent成本优化的务实路径。作为早期开源项目,Parsec在信息损失权衡、小模型自身开销及框架兼容性方面仍待社区验证。
长时运行的AI Agent,为何总被上下文拖垮
任何用过Claude Code或类似编码助手的人,大概都遇到过同一个问题:任务跑着跑着,上下文窗口被塞满,模型开始变慢、变贵,甚至直接触及配额上限。一位开发者在Reddit上分享了他的解决思路——因为反复撞上Claude Code的使用限制,他和团队干脆做了一个开源工具Parsec,专门用来削减长时运行Agent中的上下文膨胀(context bloat)。
上下文膨胀是自主Agent架构里一个绕不开的痛点。Agent在执行多步任务时,会不断累积工具调用记录、中间结果、历史对话,这些内容大部分对当前步骤并无用处,却实打实地占用着宝贵的token预算。随着任务链条变长,无效上下文越滚越大,最终既拉高成本,又降低响应质量。
Parsec的核心思路:让小模型先做一遍筛选
Parsec的做法有点像给大模型配了一个"前置守门员"。它引入一个专门训练用于压缩token的小语言模型(Small Language Model, SLM),在内容进入主模型之前先做一次预处理。
这个SLM的判断依据主要有两点:一是当前任务本身是什么,二是相关内容此前是否已经出现过。基于这两个维度,小模型会决定哪些信息值得保留、哪些可以裁剪。换句话说,它把"识别冗余"这件相对轻量、模式化的活儿交给了成本更低的小模型,从而为背后的大模型省下宝贵的上下文空间。
这种"小模型打前站、大模型做决策"的分层架构,近来在Agent优化领域越来越常见。用一个便宜的模型处理过滤、路由、摘要等辅助任务,再把精炼后的信息交给昂贵的主模型,是控制成本与延迟的一条务实路径。Parsec把这一思路具体落地到了上下文压缩的场景。
小语言模型(SLM)通常指参数量在1B到13B区间的轻量级语言模型,代表性产品包括微软Phi系列、Google Gemma以及Meta的Llama小参数版本。与动辄数百亿参数的主流大模型相比,SLM的推理成本可低1至2个数量级,且能在本地或边缘设备上运行,非常适合承担"分类、过滤、摘要"等结构化程度较高的辅助任务。在上下文压缩这一场景中,SLM无需具备复杂推理能力,只需判断某段内容与当前任务是否相关、是否已经出现过——这类模式识别任务恰好是小模型的能力边界之内。这也是Parsec选择引入SLM而非直接用主模型做自我摘要的核心经济逻辑:用更便宜的计算换掉主模型中最不划算的那部分token消耗。
为什么这类工具正变得重要
随着编码Agent、研究Agent等长时运行应用普及,token经济学正成为开发者绕不开的现实约束。主流模型按token计费,上下文越长,单次调用成本越高;同时超长上下文还会带来"迷失在中间"(lost in the middle)等注意力衰减问题,反而损害输出质量。
在这种背景下,上下文工程(context engineering)逐渐从边缘技巧变成核心能力。谁能用更少的token喂给模型同样甚至更好的信息,谁就能在成本、速度和效果上同时占优。Parsec选择开源,也意味着开发者可以直接审视其压缩策略、自行调整乃至贡献改进,这对社区验证效果、快速迭代都有帮助。
"迷失在中间"(Lost in the Middle)是斯坦福大学2023年一项研究正式命名的现象:当关键信息被放置在超长上下文的中间位置时,大语言模型的检索准确率会显著下降,而放在开头或结尾的信息则更容易被模型"注意到"。这一发现揭示了一个反直觉的现实——更长的上下文窗口并不总是带来更好的性能,在某些任务上,精简后的上下文反而能让模型给出更准确的回答。对于多步骤Agent来说,历史工具调用结果和中间输出往往大量堆积在上下文中段,恰好落入模型注意力最薄弱的区域,这进一步强化了主动做上下文压缩的必要性。"上下文工程"因此不只是省钱手段,也是维持输出质量的技术保障。
仍待观察的问题
作为一个早期开源项目,Parsec目前更多是抛出思路、征集反馈。作者在帖子中明确表示希望听取意见,并想知道大家还希望它支持哪些Agent框架(harness)。这也暴露出几个尚未有公开答案的关键点:
- 压缩带来的信息损失如何权衡:SLM在裁剪token时,如何保证不误删对后续步骤至关重要的信息,目前缺乏公开的评测数据。
- 小模型本身的开销:多引入一个模型意味着额外的推理成本和延迟,净收益究竟有多大,需要在真实工作负载下验证。
- 框架兼容性:作者主动询问社区希望支持哪些harness,说明当前集成范围可能有限。
对于正在被上下文成本困扰的团队,Parsec提供了一个值得关注的开源参考实现。项目地址已在Reddit公开(github.com/Daseinlabs/parsec),感兴趣的开发者可以自行评估其在自己工作流中的实际表现。
提示:本文基于开发者在Reddit的单一来源分享,Parsec的实际压缩效果与稳定性仍有待更多独立测试佐证。
相关推荐
Grist移除社区版SSO功能:开源软件的"SSO税"争议再起
Grist在v1.7.18版本更新中移除了社区版的SSO单点登录功能,将其锁定至付费层级,引发"SSO税"争议。本文分析该事件、开源软件商业化困境及对自托管用户的启示。
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。