Particle-1登陆AI Gateway:省token的软件工程专用模型
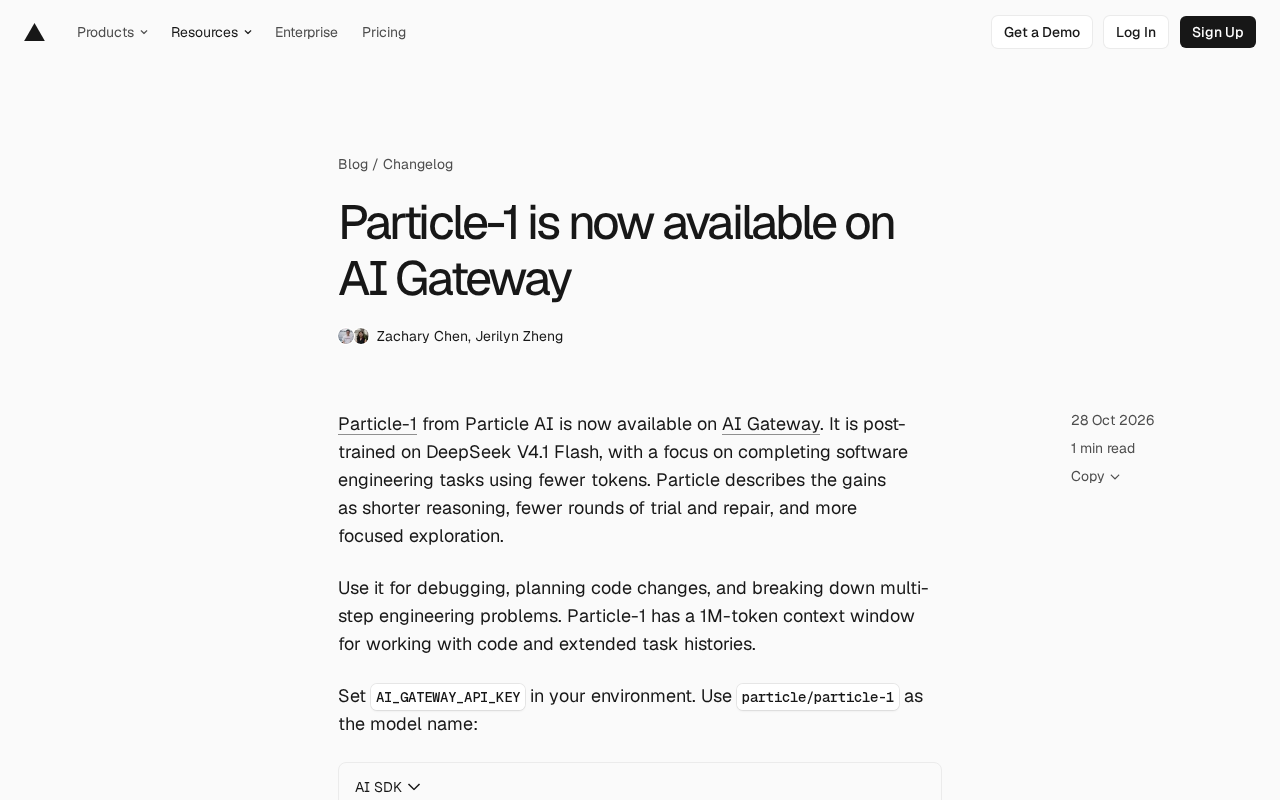
Particle-1 基于 DeepSeek V4.1 Flash 后训练,主打以更少 token 完成软件工程任务,并上线 Vercel AI Gateway。
Particle AI 的 Particle-1 模型已上线 Vercel AI Gateway,它基于 DeepSeek V4.1 Flash 后训练而成,核心卖点是 token 效率:更短的推理过程、更少的试错与修复轮次、更聚焦的探索路径。模型具备 100 万 token 上下文窗口,适用于调试、规划代码变更和拆解多步骤工程问题。开发者通过设置 AI_GATEWAY_API_KEY 并以 particle/particle-1 为模型名调用,可在 AI SDK、Claude Code、Codex、Cursor 等编码智能体中使用。AI Gateway 提供统一 API、用量与成本追踪、重试、故障转移、预算管理和零数据保留等能力,且按提供商价格原样计费不加价。文章认为这反映了模型厂商垂直深耕、网关层横向整合的趋势。
一款为软件工程任务定制的模型来了
Particle AI 的 Particle-1 模型现已上线 Vercel AI Gateway。据官方介绍,该模型基于 DeepSeek广告 V4.1 Flash 进行后训练(post-trained),核心目标是用更少的 token 完成软件工程任务。Particle 将这种提升描述为:更短的推理过程、更少的试错与修复轮次,以及更聚焦的探索路径。
这一发布值得关注的不是又一个模型上架,而是它对 token 效率的明确押注。在编码智能体(coding agent)场景里,推理长度和试错轮次直接决定调用成本与响应延迟,Particle-1 的设计取向正好切中这一痛点。
后训练(post-training) 指模型在完成大规模预训练之后接受的第二阶段训练,通常包括监督微调(SFT)、基于人类或 AI 反馈的强化学习(RLHF/RLAIF)、拒绝采样等环节。与预训练学习通用语言与知识不同,后训练的目标是把基座模型的行为对齐到特定任务分布与偏好上,例如让输出更简洁、更遵循指令,或在代码任务上提高首次生成正确率。Particle-1 基于 DeepSeek V4.1 Flash 做后训练,意味着它复用了基座模型的通用能力与知识,只针对软件工程场景调整推理风格与输出策略,因此训练成本远低于从零训练一个新模型,但能力上限也受基座模型约束。
Token 效率 衡量的是完成同一任务所需的输入加输出 token 数量。在编码智能体场景中,成本与延迟几乎与 token 总量线性相关:推理链越长、失败后重试的轮次越多,累积消耗就越大。因此“用更少 token 完成任务”并不只是省钱,还意味着更短的端到端响应时间和更少的上下文窗口占用,对多步骤、长会话的工程任务尤为关键。
模型能力与适用场景
根据 AI Gateway 页面的说明,Particle-1 适合调试、规划代码变更,以及拆解多步骤的工程问题。这类任务通常需要模型在较长上下文中保持对代码结构和任务历史的感知,而 Particle-1 提供了 100 万 token 的上下文窗口,用于处理代码库和较长的任务历史记录。
从定位看,Particle-1 并不追求通用对话能力的全面覆盖,而是把资源集中在工程任务的执行效率上。更短的推理意味着模型倾向于直接给出可操作的方案,而不是展开冗长的分析;更少的修复轮次则指向首次生成质量更高、减少来回纠错的循环。
上下文窗口 指模型单次调用能够处理的 token 总量上限,涵盖输入提示与生成的输出。100 万 token 的量级大致相当于数十万行代码或数百个文件的内容,使模型可以在一次调用中同时看到多个相关文件、依赖关系和历史对话记录,而不必依赖检索或分块拼接。不过需要注意,上下文窗口大小与实际“有效利用”能力并不等同:长上下文中位于中部的内容容易被模型忽略(常被称为 lost-in-the-middle 现象),且输入 token 仍会计费。因此即便窗口足够大,实践中仍建议只放入与当前任务相关的代码片段和任务历史,以兼顾成本与准确率。
如何在AI Gateway中调用
使用方式相当直接:在环境中设置 AI_GATEWAY_API_KEY,然后将模型名指定为 particle/particle-1。以 AI SDK 为例,可以通过 streamText 发起流式调用:
import { streamText } from 'ai';

const result = streamText({
  model: 'particle/particle-1',
  prompt: 'Suggest three fixes for a flaky API retry loop.'
});

for await (const text of result.textStream) {
  process.stdout.write(text);
}
如果想在 Claude Code、Codex、Cursor 等编码智能体中使用,需要安装最新版 Vercel CLI 并运行 npx vercel ai-gateway setup,随后在智能体中选择 particle/particle-1。官方还提供了模型 playground 供直接试用。
AI Gateway带来的工程便利
AI Gateway 本身提供统一 API,用于调用模型、追踪用量与成本,并配置重试、故障转移和性能优化,以提供高于单一提供商的上线可用性。它内置自定义报表、零数据保留(Zero Data Retention)支持、API key 预算管理、路由规则等功能。
计费方面,AI Gateway 按提供商价格原样计费,不加价,也不对推理收取平台费用,自带密钥(BYOK)请求同样适用。对于需要在多个模型之间切换、同时控制成本和可用性的团队来说,这种统一接入层的价值在于减少自建网关的维护负担。
Particle-1 在 AI Gateway 上的出现,反映出一个趋势:模型厂商开始在垂直场景上做深,而网关层则在横向整合上承担越来越多职责。对于日常与代码打交道的开发者,这类专注 token 效率的模型值得放进工具箱里实际测试,尤其是在调试循环和多步骤重构这类容易消耗大量 token 的任务上。
BYOK(Bring Your Own Key,自带密钥) 指开发者使用自己在模型提供商处申请的 API key,通过网关转发请求。在这种模式下,计费通常仍由原提供商结算,网关只承担路由与观测职责,因此不产生额外加价。与之相对的是网关代充模式,由网关统一采购并转售模型调用额度。BYOK 的价值在于:团队可以保留与提供商直接签订的合同、配额与合规条款,同时仍获得网关提供的统一日志、用量统计、重试和故障转移能力,避免被单一接入层锁定。
故障转移(failover) 指当主模型或主提供商返回错误、超时或触发限流时,网关自动将请求切换到备用模型或备用端点。对于生产环境的编码智能体,这意味着单点故障不会直接暴露给终端用户,但切换后输出风格与质量可能发生变化,需要在路由规则中谨慎配置等价模型。
相关推荐
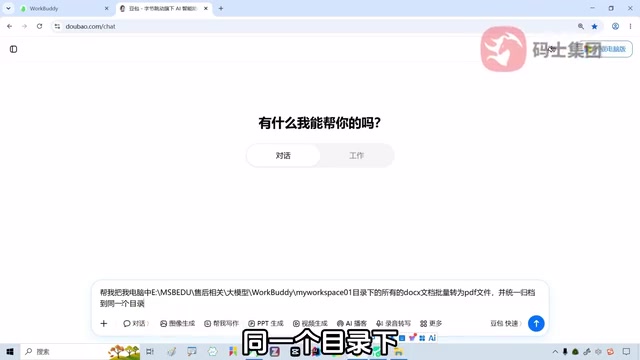
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
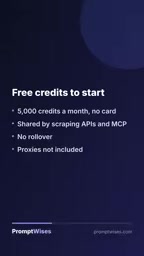
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。