苹果AI联手阿里入华,华为超节点点亮丨AI日报

苹果智能国行接入千问,昇腾千卡超节点点亮,Kimi与商汤推进端侧与效率。
本期AI动态从算力、终端、模型三条线梳理近期进展。苹果确认与阿里合作,国行苹果智能在系统底层接入通义千问,将深度融合Siri、写作工具与视觉智能,下周开发者测试版上线、12月正式推送,意味着模型入口从App层上移到系统层。华为昇腾首个950DT千卡液冷超节点在武汉点亮,单节点算力达E-flops级,配合内蒙古万卡池连调,DeepSeek计划部署至少16万颗昇腾做推理,指向集群化推理基建。模型侧,Kimi上线3D Make,用自然语言生成脚本驱动Blender与CAD;商汤开源Loop-9B,以循环注意力与参数共享换取效率,16G内存可本地运行。国际方面,谷歌在卫星TPU上跑通模型,Anthropic将Max更名Ultra并取消验证用户的5小时滚动限制。
苹果智能入华的消息终于落地,但主角不是ChatGPT,而是阿里千问。另一边,华为昇腾在算力基建上再进一步,Kimi把3D建模拉进聊天框,商汤则用9B小模型挑战大模型的能力边界。本期AI动态从算力、终端、模型三条线拆解这几件事背后的信号。
苹果智能入华:千问接入系统底层,Siri和写作工具全面融合
苹果官方确认与阿里合作,在系统底层接入通义千问广告。从B站UP主Will叔的梳理来看,国行苹果智能会深度融合进Siri、写作工具和视觉智能系统,用户无需翻墙即可直接调用,下周随开发者测试版上线,12月正式推送。
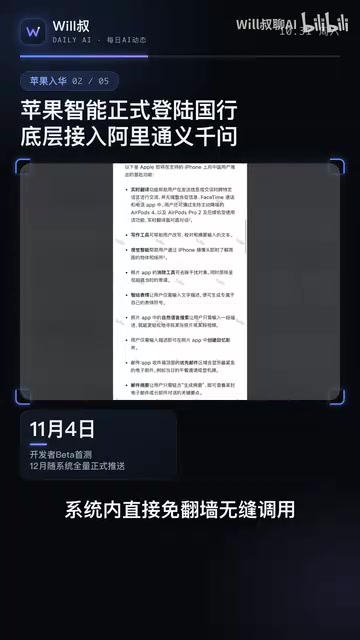
这条合作的关键不在“苹果有了AI”,而在于调用路径的本地化。此前海外版苹果智能依赖OpenAI的模型服务,国行版本需要一套合规且可用的替代方案,千问补上的正是这个位置。对阿里来说,这意味着通义千问进入数亿级iOS设备的系统级入口,模型能力被封装成用户无需感知的底层服务;对苹果而言,用本土模型换来了功能按时落地。
值得留意的是“系统底层”这个表述。如果千问的调用发生在Siri、写作工具和视觉智能这类系统组件层,而非独立App,那么模型的分发效率会远高于应用商店里的AI应用。这对国内其他模型厂商是一个明确的竞争信号:入口之争正在从App层上移到系统层。
华为昇腾千卡超节点点亮,国产算力走向集群化
华为昇腾首个950DT千卡液冷超节点在武汉正式点亮,单节点算力达到E-flops级别,并具备微秒级急速互联能力。据Will叔每日AI动态的报道,内蒙古万卡池也已连调完毕,DeepSeek广告计划在当地直接部署至少16万颗昇腾芯片用于推理。
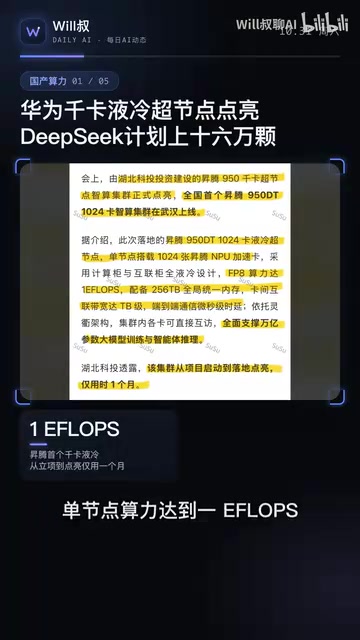
千卡超节点的意义在于把算力从“单卡性能”的叙事转向“集群效率”。大模型推理的瓶颈往往不在单芯片算力,而在卡间通信和散热,液冷加微秒级互联正是针对这两个痛点。E-flops级别的单节点算力配合万卡池的连调,指向的是推理侧的大规模部署能力,而非训练。
DeepSeek在当地部署至少16万颗昇腾做推理,是这个方向上最具体的注脚。推理负载对生态兼容性的要求低于训练,国产芯片在这一侧切入的可行性更高。如果这一部署按计划推进,它将成为国产算力承载头部模型推理服务的一个可观察样本。
超节点(Super Node) 是近年来AI算力基础设施领域出现的一个架构概念,指的是将数十至数千张加速卡通过高速互联网络紧密耦合,在逻辑上作为一个超大计算单元对外提供服务的系统。与传统"多台服务器各自独立"的集群模式不同,超节点强调的是卡间通信的低延迟与高带宽,典型指标包括互联时延(微秒级)和聚合算力(如E-flops级别)。华为、英伟达等厂商都在推进类似架构,目的是让大模型的张量并行、专家并行等分布式推理策略能在更大范围内高效运行。超节点的工程难点主要在互联拓扑、液冷散热和故障隔离三方面,这也解释了为什么报道中特别强调"液冷"与"微秒级互联"这两个参数。
E-flops(Exaflops) 是算力计量单位,1 E-flops 等于每秒 10^18 次浮点运算。作为参照,当前顶级单张AI加速卡的算力通常在数千万亿次(P-flops)量级,因此"单节点E-flops"意味着该节点聚合了成百上千张卡。需要注意的是,厂商标称的算力往往是特定精度(如FP16或INT8)下的峰值理论值,实际有效算力会因通信开销、内存带宽和模型结构而打折扣。
Kimi上线3D建模:一句话直连Blender和CAD
月之暗面为Kimi上线了3D Make功能,支持一句话直连Blender和CAD工具,写脚本、建模型、搭场景一气呵成。无论是草图还是文字输入,都能快速生成空间结构,并可直接导出送往三维软件。
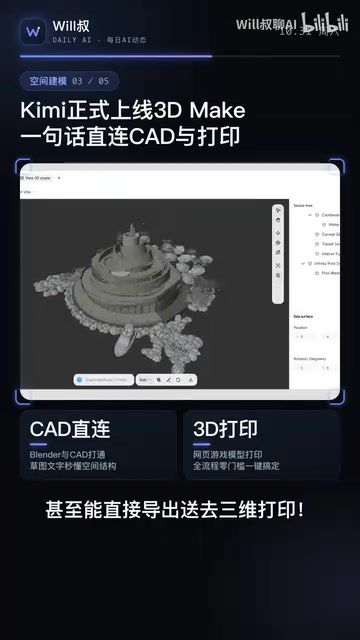
这个功能的实质是把自然语言到3D资产的链路压缩成一次对话。传统流程里,从想法到可编辑模型需要经过建模软件的操作门槛,Kimi的做法是让模型生成脚本去驱动Blender和CAD,把“会写脚本”这件事交给AI。对非专业建模用户,这是能力边界的扩展;对专业用户,它更像一个加速草图阶段的工具。
3D内容生成并不新鲜,但直接对接成熟工具链而非自建渲染管线,是更务实的选择。导出的模型能进入既有工作流,意味着它有机会被真正用起来,而不是停留在演示视频里。
Blender 是一款开源的三维创作软件,支持建模、雕刻、动画、渲染等完整流程,并提供Python API,脚本可以程序化地生成和修改场景中的几何体、材质与相机。CAD(计算机辅助设计)则更多用于工程与工业设计,强调精确尺寸和参数化约束。两者的共同点是都提供脚本接口,这使得大模型可以通过生成代码来"操作"软件,而不必自建三维渲染或几何引擎。这种"模型生成脚本、脚本驱动工具"的模式,本质上是把大模型作为自然语言与专业软件之间的编排层,其输出质量取决于API覆盖度与脚本的可执行性,而非模型直接生成三维网格。相比端到端的3D生成模型,这条路径更容易接入既有生产工作流。
商汤开源Loop-9B:用循环注意力换参数效率
商汤开源了Loop-9B模型,采用循环注意力与参数共享机制,用计算深度换参数量。据报道,该模型在复杂任务上反超部分更大参数规模的模型,且16G内存即可在本地流畅运行,端侧能力被拉到较高水平。
小模型以小博大的思路,核心是把“堆参数”换成“堆计算步数”。循环注意力让同一组参数被反复调用,参数共享则压缩了模型体积,代价是推理时的计算深度增加。这条路线的价值在于端侧部署:16G内存的门槛意味着它能跑在消费级设备上,而不必依赖云端。
它与前述华为昇腾的推理部署形成对照。一端是把大算力集群化,另一端是把模型压进本地设备,两条路线解决的是不同场景的问题。Loop-9B这类模型如果端侧表现稳定,会推动更多AI功能从云端下放到设备本地。
循环注意力(Recurrent Attention) 与参数共享(Parameter Sharing) 是提升模型参数效率的两类常见手段。循环注意力的思路是让同一组Transformer层(或注意力权重)在推理时被反复调用多次,相当于在不增加参数量的前提下增加"计算深度",使模型对复杂输入进行多轮迭代加工。参数共享则是让模型不同层复用同一套权重,直接压缩模型体积。两者的共同代价是推理时的计算步数或串行深度增加,因此对延迟和显存带宽更敏感。这一路线与"堆参数、堆数据"的Scaling Law思路形成对照,在端侧部署场景中更受关注,因为消费级设备的瓶颈通常是内存容量而非峰值算力。Loop-9B的16G内存门槛,正是这一设计取向的直接体现。
谷歌AI上太空,Anthropic调整订阅限制
国际方面,谷歌将AI搬上太空,卫星上的TPU芯片在轨道中成功运行模型并写下第一首诗。据Will叔每日AI动态的报道,这标志着地球算力开始向轨道延伸。
在轨运行TPU的意义更多在验证而非实用:太空环境的辐射、散热和通信条件与地面差异巨大,模型能跑通本身就是一次工程验证。短期它对日常AI应用影响有限,但为未来星上数据处理提供了参考。
另一则消息是Anthropic官宣Max更名Ultra,并对验证用户取消5小时滚动限制。订阅层的调整反映出推理成本与用户留存之间的权衡,重度用户的用量限制一直是AI订阅产品的敏感点。
三条线索背后的共同趋势
把这几件事放在一起看,算力、终端与模型效率正在同时发力。华为昇腾千卡超节点与万卡池指向集群化推理基建,苹果与千问的合作把模型送进系统级入口,Kimi的3D Make和商汤Loop-9B则在应用层和效率层各自推进。
对开发者和产品团队来说,有两个信号值得关注:一是系统级AI入口的开放会改变应用分发的逻辑,二是端侧可运行的小模型正在变得实用。前者影响获客路径,后者影响功能架构。
相关推荐

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。