苹果将推Mac新应用,本地AI模型运行更简单
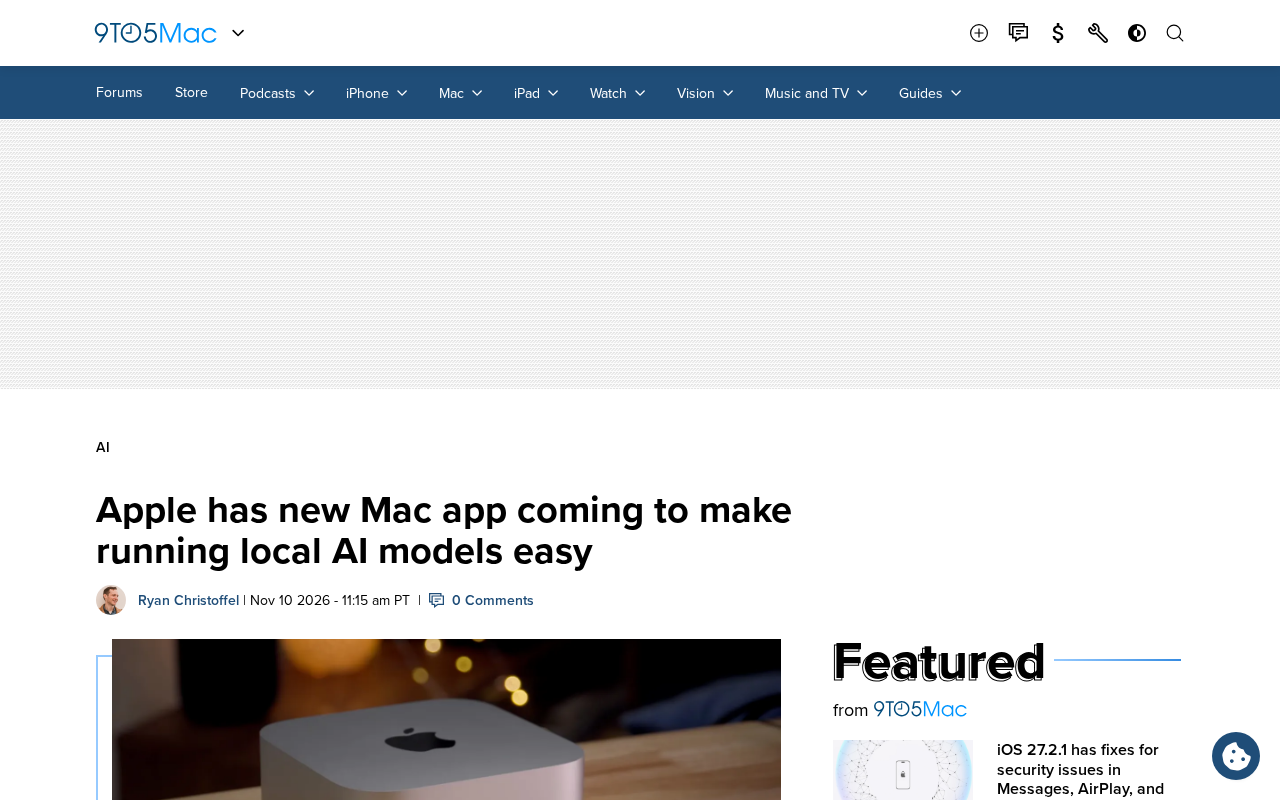
苹果拟推Mac本地AI应用,把端侧模型运行做成系统级体验。
据Hacker News消息,苹果正为Mac开发一款新应用,目标是让用户更轻松地在本地运行AI模型,具体功能尚未公开。文章分析认为,本地推理在隐私合规、网络延迟和API成本上具备优势,而苹果自研芯片的统一内存架构为加载较大参数模型提供了硬件基础。产品思路上,苹果大概率延续封装复杂度、开箱即用的策略,内置模型库与Apple Silicon优化后端,面向普通用户而非极客开发者,与现有第三方工具形成互补。生态层面,系统级API的开放程度与模型分发的许可合规,将是决定其对开发者格局实际影响的关键变量。
苹果布局本地AI,Mac新应用降低门槛
据Hacker News社区消息,苹果正在为Mac开发一款新应用程序,目标是让用户更轻松地在本地运行AI模型。这一动态表明,苹果正积极跟进本地化AI推理的行业趋势,试图将原本门槛较高的模型部署流程整合为系统级体验。
目前关于该应用的具体功能细节尚未公开,但从“让运行本地AI模型变得简单”这一核心描述可以推断,苹果很可能在底层框架、模型管理和用户界面三个层面同时发力。对于长期依赖命令行和第三方工具的Mac开发者而言,这或许意味着一次体验层面的重要升级。
为什么本地运行AI模型值得关注
本地AI推理的价值在隐私敏感场景中尤为突出。数据无需上传云端,推理过程完全在设备端完成,这对医疗、法律、金融等对数据合规要求严格的行业具有天然吸引力。同时,本地运行还能规避网络延迟和API调用成本,在重复性高、响应要求快的任务中具备效率优势。
从硬件角度看,苹果自研芯片的统一内存架构为本地AI推理提供了有利条件。相比传统PC需要独立显存与系统内存之间的数据搬运,统一内存让GPU可以直接访问大容量内存,降低了运行较大参数模型时的资源瓶颈。苹果若推出官方应用,本质上是把这一硬件优势转化为可感知的软件体验。
本地AI推理指将训练好的模型权重下载到用户设备上,由设备自身的CPU、GPU或神经网络引擎完成前向计算,而非把输入数据发送到云端服务器。与之相对的是云端推理:用户请求经网络传输至数据中心,由服务器集群计算后返回结果。本地推理的核心权衡在于——牺牲部分峰值算力与模型规模上限,换取数据不出设备、无网络依赖、无按次计费。常见实现方式包括直接加载完整精度模型、使用量化压缩后的低比特权重,以及借助llama.cpp、MLX等推理框架完成格式转换与加速。
统一内存架构(Unified Memory Architecture) 是苹果自研芯片的核心设计之一:CPU、GPU与神经网络引擎共享同一块物理内存池,而非各自拥有独立显存。传统PC中,运行大模型时模型权重通常需驻留显存,显存容量成为硬性上限,且CPU与GPU之间的数据搬运会带来额外开销。统一内存让GPU可直接寻址系统全部内存,使得在内存较大的Mac上加载数十GB参数的模型成为可能。但需注意,统一内存带宽仍低于高端独立显卡的显存带宽,因此其优势主要体现在“能装下”而非“算得快”,对大模型的首 token 延迟和生成吞吐仍有实际约束。
苹果可能的产品思路
结合苹果一贯的产品策略,这款应用大概率不会走“开放所有参数”的极客路线,而是倾向于封装复杂度、提供开箱即用的体验。可能的形态包括:内置模型库供用户一键下载、针对Apple Silicon优化的推理后端、以及与其他系统应用联动的能力。
这种思路与第三方本地推理工具的定位存在差异。后者往往强调模型格式兼容性和参数可调性,吸引的是愿意折腾的开发者群体;而苹果若推出官方应用,更可能面向希望快速验证想法的产品经理、设计师以及需要离线AI能力的普通用户。两者之间未必是替代关系,更可能形成互补。
模型量化(Quantization) 是本地运行大模型的关键前置技术:将模型权重从16位浮点压缩为8位、4位甚至更低的整数表示,从而把内存占用和计算量成倍降低,代价是精度损失。常见格式如GGUF、AWQ、GPTQ等,各自对应不同的量化策略与推理后端。对苹果而言,若要提供“一键下载即可运行”的体验,就必须在应用内部处理模型格式转换与量化等级选择,否则用户仍需自行面对格式兼容问题。这也解释了为何官方应用很可能内置经过统一量化和验证的模型库,而非开放任意权重导入。
对开发者生态的潜在影响
如果苹果将本地模型运行能力系统化,第三方开发者的接入方式可能随之改变。一方面,系统级API若开放,应用开发者无需自行搭建推理管线即可调用本地模型;另一方面,苹果对模型分发和权限控制的管理方式,也可能影响现有开源工具的使用场景。
值得观察的是苹果如何处理模型来源问题。本地运行涉及模型权重、量化格式和许可协议,若应用内置模型商店,审核与合规将成为绕不开的环节。这既可能推动本地AI应用的规范化,也可能在开放性与可控性之间引发新的讨论。
模型许可协议是本地AI分发中容易被忽视的合规变量。不同开源模型的许可证差异很大:有的允许商用,有的仅限研究用途,有的对用户规模或输出内容设有附加条款。若苹果建立内置模型商店,就需要对每个上架模型的权重来源、许可证类型和再分发权限进行审核,这与App Store的应用审核逻辑类似但更为复杂——模型权重本身是二进制文件,其合规性难以通过自动化手段完全验证。这一环节的处理方式,将直接决定官方应用是走向封闭 curated 生态,还是保留开放的侧载通道。
结语
苹果入局本地AI模型运行,反映出一个清晰信号:端侧推理正在从小众技术走向系统级能力。尽管应用细节尚未明朗,但方向本身已足够说明问题——当操作系统厂商开始认真对待本地模型部署,普通用户与AI之间的距离会被进一步拉近。后续值得关注的是该应用具体开放的接口范围,以及它对现有本地推理工具格局的实际影响。
相关推荐
OpenAI 谈数据中心公关危机与 AI 监管自我约束
OpenAI 高管访谈解读:AI 数据中心为何遭遇公关危机,以及 OpenAI 为何支持以「限速」框架监管递归自我改进,强调人类必须掌控 AI 技术。
ExecuTorch WebGPU:PyTorch模型直接在浏览器GPU上运行
PyTorch 发布 ExecuTorch WebGPU 支持,模型经 torch.export 导出为 .pte 文件后可直接在浏览器 GPU 上推理,无需转换为其他框架格式,兼顾本地隐私与低延迟部署。
苹果新Mac应用Harbor:本地AI推理与雷雳5集群
苹果新Mac应用Harbor曝光:把Mac变成私有AI推理服务器,通过雷雳5连接多台Mac池化统一内存运行大模型。本文解析其功能、与Exo和LM Studio的差异,以及本地AI生态影响。