苹果新Mac四款齐发:从桌边智能体到本地大模型工作站全拆解
2026年8月25日,苹果一口气发布四款新Mac。表面上看,这只是常规的产品更新,但拆解价格与配置后会发现:苹果这次真正端出的,不是一台"AI Mac",而是一条从899美元的桌边智能体,到5499美元起本地大模型工作站的完整价格阶梯。
这条阶梯在压住什么?每一档升级又会落到哪些具体任务上?本文从产品分层、内存账本与性能瓶颈三个维度,拆解苹果对本地AI的判断。
四款新Mac:一条上探的价格阶梯
这次的产品线可以清晰地分为两大类、四个档位。
Mac mini 被拆成两档:M6版从899美元起,最高32GB统一内存,定位为"常驻运行的桌边智能体";M5 Pro版从1995美元起,最高64GB并加入雷雳5接口,面向更大的本地模型和专业工作流。两款均在2026年9月22日开售。
这里值得注意苹果的双线芯片策略:M6为最新一代基础芯片,采用更新的制程工艺和微架构改进;而M5 Pro/Max/Ultra则是上一代架构的多核扩展版本,通过die-to-die互联技术将多个M5基础芯片拼接为更大的计算单元。Ultra版本本质上是两颗Max芯片通过苹果自研的UltraFusion封装互联而成,这种chiplet(小芯片)设计使苹果无需为每个性能等级从零设计新芯片,大幅降低了研发成本和上市周期。这也解释了为什么入门级产品搭载更新一代的M6,而高端工作站仍在使用M5系列——后者的多核扩展版本需要更长的验证和量产周期。
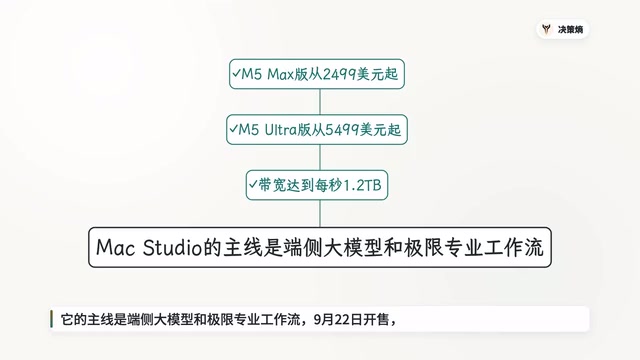
Mac Studio 继续向上:M5 Max版从2499美元起,最高128GB;M5 Ultra版从5499美元起,最高512GB,内存带宽达到每秒1.2TB。它的主线是端侧大模型和极限专业工作流,512GB版本预计10月下旬到货。
你可能没注意到价格整体上移。对比上一代美国首发价,入门款从599美元涨到899美元,Mac Studio Ultra从3999美元涨到5499美元,四档涨幅约21%到50%。四档首发起价一起抬高,桌面Mac的AI价格中心正在明显上探。
统一内存:理解整条产品线的架构基础
在展开分层逻辑之前,有必要理解苹果产品线的硬件基石——统一内存架构(Unified Memory Architecture, UMA)。苹果自M1芯片起采用这一设计,将CPU、GPU和神经引擎共享同一块物理内存,任何计算单元都能直接访问全部内存空间,无需像传统PC那样在CPU内存和GPU显存之间来回拷贝数据。传统架构中,数据在两者之间传输需要经过PCIe总线,既增加延迟又浪费带宽。而UMA下,模型权重只需加载一次,GPU和神经引擎即可直接读取,大幅降低了"显存不够"的传统瓶颈。这也是为什么512GB的Mac Studio能与数据中心中配备数百GB显存的多卡服务器竞争同一类推理任务——它不是在"借用"系统内存,而是所有计算单元原生共享同一片内存池。
这一架构还带来了一个容易被忽视的优势:功耗效率。在传统GPU服务器阵营中,NVIDIA H100单卡TDP(热设计功耗)为700W,一台8卡DGX H100整机功耗超过10kW,需要专用机房、工业级空调和高功率UPS(不间断电源)。而Mac Studio Ultra即便在满载推理场景下,整机功耗通常在300-400W范围内。对于中小团队的本地推理需求,这意味着无需专用基础设施,设备可以直接放在办公桌上运行。从总拥有成本(TCO)角度看,将硬件购置、电费、散热和场地成本综合计算,Mac工作站在特定推理负载下可能显著低于租用等效算力的云端GPU实例,尤其是在持续运行的场景中,这种成本优势会随时间累积。
苹果对本地AI的三层判断
价格背后,是苹果对本地AI能力的一套分层逻辑。
从常驻智能体到多机集群
第一层是常驻智能体,追求低功耗和常态化运行——这是Mac mini M6占住的"桌边"位置。第二层是本地大模型,核心诉求变成内存容量和带宽,用于企业级吞吐,对应高内存的Mac Studio工作站。第三层则是多机扩展,通过雷雳5将多台设备组成推理集群。
硬件升级完全服务于这个逻辑。新芯片把神经加速器直接放进GPU——这意味着苹果可能将专用的神经计算单元以类似NVIDIA Tensor Core的方式集成到GPU的流处理器阵列中。苹果的Neural Engine自A11仿生芯片起作为独立单元存在,专门加速矩阵乘法和卷积等深度学习算子。传统设计中神经引擎与GPU物理隔离,各有独立调度器。新一代的融合架构减少了数据在不同计算单元间的搬运开销,允许GPU在执行通用计算的同时穿插执行神经网络推理,大幅提升芯片面积效率和实际吞吐。这也是苹果声称M5 Ultra峰值AI算力达到M3 Ultra 4.3倍的架构基础之一。
M5 Ultra的内存带宽比M3 Ultra高出50%;Mac Studio还能通过雷雳5直接传输数据组成集群,苹果称四台分布式推理最高可达单机三倍的性能。
雷雳5(Thunderbolt 5)基于USB4 V2规范,单口双向带宽可达80Gbps,在非对称模式下上行甚至能达到120Gbps,相比雷雳4的40Gbps翻了一倍以上。多机推理的核心挑战在于节点间的数据同步:大模型的张量并行(Tensor Parallelism)需要在每一层计算后交换中间激活值,对延迟和带宽极其敏感。传统数据中心使用InfiniBand或高速以太网(100/400GbE)解决这一问题。雷雳5虽然在绝对带宽上仍不及InfiniBand的400Gbps,但它将桌面设备组网的门槛大幅降低——无需交换机、无需专用网卡,直连即可组成小型推理集群。
在分布式推理的具体策略上,张量并行(TP)将同一层的矩阵运算切分到多个设备上并行执行,每次前向传播后需要All-Reduce操作来同步结果;另一种常见策略是流水线并行(Pipeline Parallelism, PP),将模型的不同层分配到不同设备上,数据像流水线一样逐层流过。TP对通信带宽要求极高但延迟最优,PP对带宽要求较低但存在流水线气泡(bubble)——即部分设备在等待上游计算完成时处于空闲状态。苹果宣称的"四台分布式推理最高可达单机三倍性能"意味着约75%的并行效率,这暗示其可能采用了TP与PP的混合策略,利用雷雳5的低延迟特性在少量节点间实现张量并行,同时通过流水线并行分摊跨节点通信压力。在桌面级互联条件下达到这一效率是相当可观的数字。
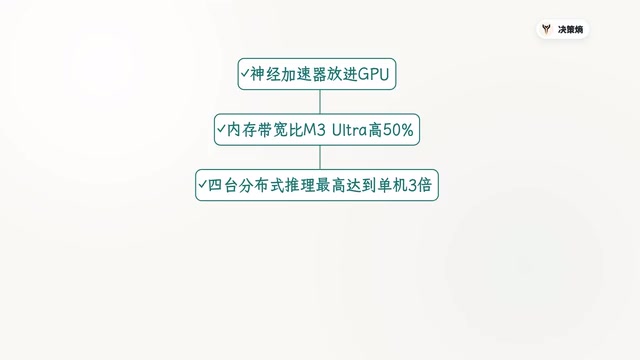
用一句话概括,这一代Mac的三个升级中心就是:计算、带宽和扩展。
内存账本:容量决定你能跑多大的模型
这套分层,首先是由模型的"内存账"划开的。
权重量化与容量门槛
权重量化是将模型参数从高精度浮点数(如FP16的16位,每个参数占2字节)压缩到更低位宽(如INT4的4位,每个参数约占0.5字节)的技术。主流量化方法包括GPTQ、AWQ和GGUF等格式,它们通过不同的数学策略在精度损失和压缩率之间取得平衡。GPTQ(GPT Quantization)基于逐层最优量化理论,通过最小化每层输出误差来确定量化参数;AWQ(Activation-aware Weight Quantization)则观察到不同权重通道对激活值的影响差异巨大,因此保护重要通道以减少精度损失;GGUF是llama.cpp项目定义的模型格式,支持灵活的混合精度量化,允许不同层使用不同的量化位宽。量化后的模型在大多数对话和推理任务中表现与原始模型相近,但在需要高精度数值推理的场景中可能出现可感知的质量下降。常见的四位量化会把每个参数压缩到约半个字节。以此计算:
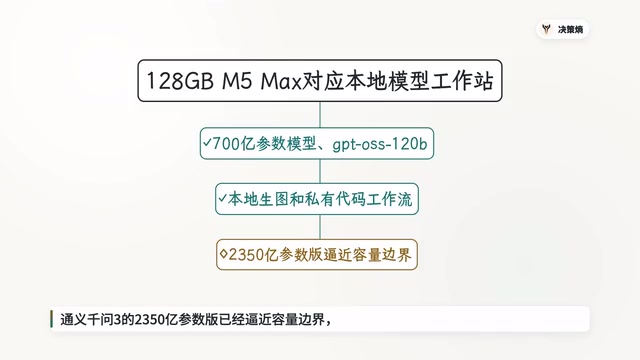
- 700亿参数模型:理论权重约35GB。像GPT-OSS等官方低位版本可在80GB内运行,64GB到128GB因此覆盖了两档常用低位模型。
- 通义千问广告3的2500亿参数版:四位权重下限约118GB,加上系统与KV缓存后,128GB已经相当紧张。
- 完整版DeepSeek广告 R1(6710亿参数):四位权重下限约336GB,上一代M3 Ultra实测峰值约392GB。到这个区间,512GB才成为决定性资源。
但容量只是第一道门槛。操作系统、运行时和KV Cache都会占用统一内存。KV Cache(键值缓存)是Transformer架构在自回归生成时的核心优化机制:每当模型生成一个新token时,它需要对之前所有token执行注意力计算;如果每次都从头计算,时间复杂度会随序列长度平方级增长。KV Cache的做法是将每一层注意力机制中已计算过的Key和Value向量缓存起来,后续生成只需计算新token的注意力即可。代价是内存占用与"层数×注意力头数×上下文长度×精度"成正比。对于一个拥有80层、64个注意力头的700亿参数模型,16K上下文的KV Cache可能额外占用数十GB内存。上下文越长、并发越多,占用就越大。
值得注意的是,业界已经发展出多种针对KV Cache的优化技术来缓解这一压力。GQA(Grouped Query Attention,分组查询注意力)通过让多个查询头共享同一组Key-Value头来成倍减少缓存量,Llama 2/3和Qwen系列已广泛采用此设计。更激进的MQA(Multi-Query Attention,多查询注意力)则让所有查询头共享同一对KV头,进一步压缩缓存。在系统层面,PagedAttention是vLLM项目提出的核心技术,它借鉴操作系统虚拟内存的分页管理思想,将KV Cache按固定大小的"页"动态分配,避免传统方案中为每个请求预分配最大长度缓存导致的严重内存碎片化和浪费。这些优化技术在苹果MLX框架中的适配程度,直接决定了同等内存条件下实际可支持的上下文长度和并发用户数。权重装得下只是能启动,剩余空间才决定上下文长度和并发能力。
速度才是拉开差距的关键
如果说容量决定"能不能跑",那速度决定"跑得好不好"。
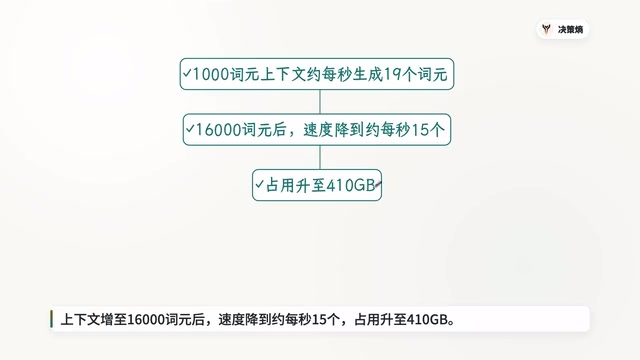
据实测数据,M3 Ultra运行四位DeepSeek R1时,1000 token上下文约每秒生成19个token,占用392GB;当上下文增至16000 token后,速度降到约每秒15个,占用升至410GB。
这个速度足以支撑单用户交互,但服务型负载更看重并发总吞吐。M5 Ultra正是针对这些速度瓶颈:苹果自测显示,其峰值AI算力最高是M3 Ultra的4.3倍。不过,同模型、同量化、同上下文的独立测试,还要等首批交付后才能验证。真正区分工作站和服务器的,是首次延迟(Time to First Token, TTFT,即用户发出请求到收到第一个生成token的时间)、多用户总吞吐(单位时间内服务所有并发用户的总token生成量)、故障恢复和单位请求成本这些指标。在数据中心场景中,这些指标通过成熟的服务框架(如vLLM、TensorRT-LLM、Triton Inference Server)进行精细调优,而苹果生态中的等效工具链仍在早期阶段。
产品分层落到具体任务
把这些指标放回实际任务里,产品分层就一目了然了。
- M6 Mac mini:日常自动化、小模型和云端智能体入口。核心模型放在云端时,甚至旧款Mac也能承担智能体入口。
- 64GB M5 Pro:更大的本地模型、常态运行和高速网络。
- 128GB M5 Max:700亿参数模型、本地生图和私有代码工作流接近这一能力区间。运行通义千问3的250亿版本时,128GB已是"紧配而非富余"。
- M5 Ultra(512GB):本地运行数千亿参数模型、数据留在设备内、机器持续高频使用。只有这些条件才能摊薄5499美元起的固定成本。
对已有M3 Ultra的用户来说,容量保持不变,升级价值主要集中在交付后的实际提速。
配置表之外的隐藏成本
值得警惕的是,配置表之外还有三类成本容易被忽视:
- 框架适配:新模型可能需要等待框架适配才能高效运行。苹果生态主要依赖Core ML和MLX框架,而开源社区的模型往往首先针对CUDA优化。MLX是苹果机器学习研究团队于2023年底开源的数组计算框架,设计理念深度绑定Apple Silicon的统一内存架构,采用惰性求值(lazy evaluation)策略——只在真正需要计算结果时才执行运算,这使得它能更好地优化内存使用和计算图调度。MLX社区已移植了Llama、Mistral、Qwen等主流开源模型,但其算子覆盖率和第三方库丰富度仍远不及CUDA+PyTorch生态。新发布的模型从PyTorch/CUDA移植到MLX或Core ML可能需要数天到数周,期间用户只能使用未经优化的通用推理路径,性能可能大打折扣。对于苹果的AI工作站野心而言,MLX的成熟速度可能是比硬件参数更关键的变量。
- 训练开销:数千亿参数的完整训练要保存梯度、优化器状态和中间激活,内存需求远超推理。以混合精度训练搭配Adam优化器为例,每个参数需要保存FP16权重副本(2字节)、FP32权重主副本(4字节)、FP32一阶动量(4字节)和FP32二阶动量(4字节),合计约14字节——是四位量化推理时0.5字节的28倍。再加上反向传播过程中需要保留的中间激活值(与batch size和序列长度成正比),一个700亿参数模型的全参数训练可能需要超过1TB的内存。即便512GB的Mac Studio Ultra在推理端表现出色,完整的模型训练仍然是数据中心级GPU集群的领地。不过值得一提的是,LoRA(Low-Rank Adaptation)和QLoRA等参数高效微调技术通过只训练极少量的低秩适配矩阵,可将微调所需内存降低到全参数训练的十分之一甚至更低,这使得在Mac工作站上对大模型进行领域适配成为可能——虽然这与从头训练有本质区别。
- 运维成本:多人服务需要监控和故障切换。一旦Mac工作站承担类服务器角色,就需要考虑负载均衡、健康检查、自动重启、日志聚合等运维基础设施,这些在传统服务器生态中有成熟工具链(如Kubernetes用于容器编排和自动扩缩容、Prometheus用于指标监控和告警、Grafana用于可视化),但在macOS上的解决方案仍不完善。macOS缺乏原生的容器运行时支持,虽然可以通过Docker Desktop间接使用,但性能损耗和功能限制显著。此外,macOS的进程管理和系统日志机制(launchd和统一日志系统)与Linux生态的systemd和journald差异较大,现有的服务器运维自动化脚本和工具大多无法直接复用。
软件、训练和运维成本,才是Mac工作站与通用AI服务器之间的真实距离。
结语:升级的是任务跨度
苹果这次搭出了一条本地AI的任务阶梯:Mac mini把常态运行的智能体变成桌边能力,Mac Studio把单机模型规模推到数千亿参数,雷雳5再把计算延伸到多机推理。
这一代Mac真正升级的,是本地AI的任务跨度。而它与通用AI服务器的分界线,也正从单纯的内存容量,转向并发吞吐、软件生态和运维体系。要说苹果的新Mac离AI服务器还有多远,答案或许不在硬件参数表上,而在这套软件与运维的护城河里。
核心要点
核心要点
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。