Pipit:开源Android端离线AI万能搜索,50ms内极速响应
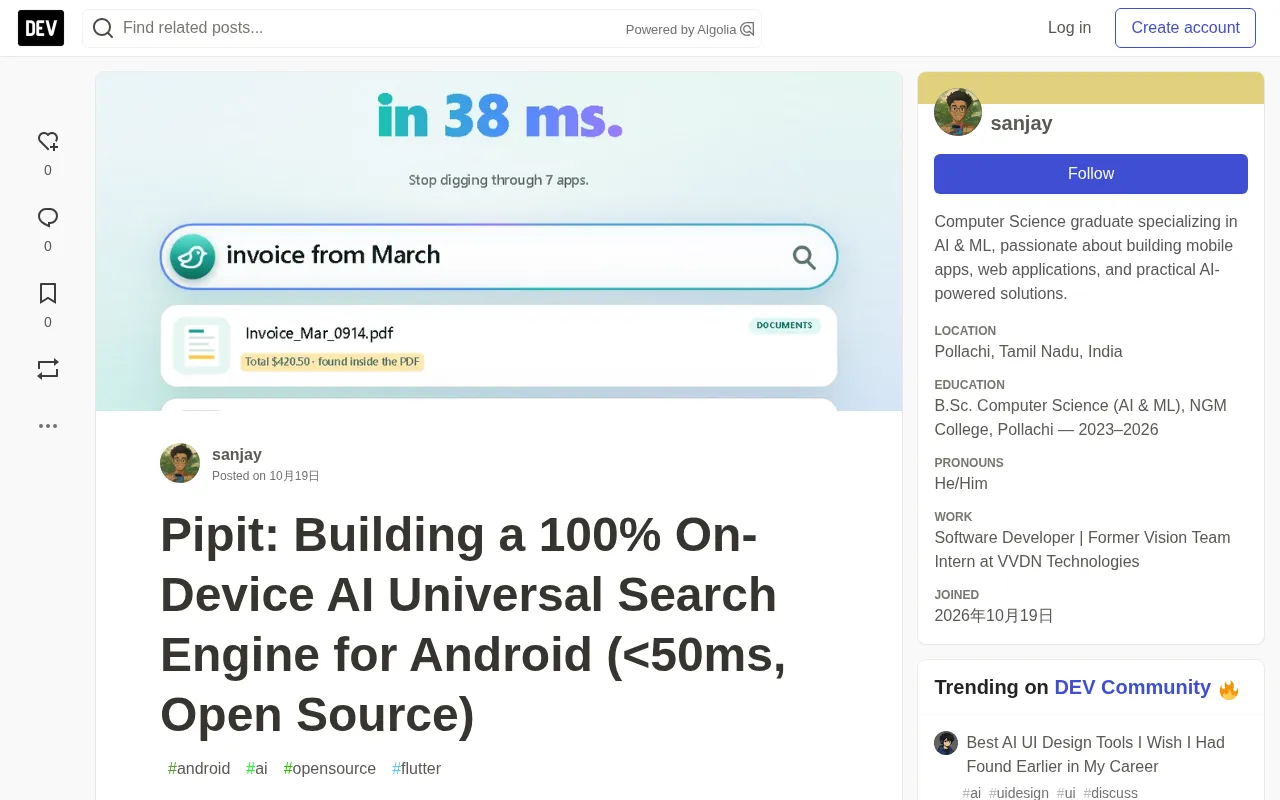
Pipit 是开源 Android 端离线 AI 搜索引擎,支持 OCR 与自然语言找图。
Pipit 是一个完全开源、100% 在设备端运行的 Android AI 搜索引擎,旨在解决原生搜索只认文件名、云端搜索又需上传隐私数据的矛盾。它借助 Google ML Kit 实现 PDF、收据和截图的深度 OCR 检索,并利用量化后的 LiteRT 多模态模型支持用自然语言描述搜索相册图片。统一搜索栏覆盖照片、PDF、消息、联系人、视频、音频、应用七大领域,所有处理均在本地芯片上完成,支持完全断网运行,宣称延迟低于 50ms。源码与 APK 已在 GitHub 发布,但项目仍面临量化精度损失、首次索引开销不明、延迟测试条件不清晰等挑战,开发者公开征集社区反馈。
当手机搜索还停留在文件名时代
智能手机里囤积了我们几乎全部的数字生活:成千上万张照片、收据扫描件、工作PDF、语音备忘,甚至藏在小角落的门禁密码。然而,原生搜索的体验却常常令人沮丧——它只认得 IMG_20240914.jpg 或 Scan_Doc_09.pdf 这类毫无语义的文件名。话说回来,云端相册搜索虽然聪明,却要求你把私人文件上传到远程服务器。
开发者 sanjay434343 在 DEV Community 上发布了一个名为 Pipit 🐦 的项目,试图打破这种两难:一个完全开源、100% 在设备端运行的 Android AI 万能搜索引擎。
核心能力:把语义搜索装进手机
Pipit 最吸引人的地方,在于它把通常需要云端算力才能完成的搜索任务,压缩到了本地芯片上。根据项目说明,它具备以下几个关键特性:
深度内容 OCR:搜进文件“肚子”里
借助设备端的 Google ML Kit,Pipit 能够对 PDF、收据和截图进行 OCR 文字识别,搜索的是文件内部的真实文字,而不只是文件名。这意味着你可以直接搜“上月房租”,而不是回忆那份 PDF 叫什么。
OCR(光学字符识别)是一种将图片中的文字转换为可编辑、可搜索文本的技术。传统 OCR 主要依赖卷积神经网络和序列识别模型,对清晰印刷体效果较好,但对手写体、低质量扫描件容易出错。Google ML Kit 是 Google 提供的移动端机器学习 SDK,其文本识别模块支持设备端离线运行,无需将图片上传到云端,因此适合隐私敏感场景。在 Pipit 中,OCR 不仅用于提取文字,还负责建立可检索的文本索引,使得用户能用自然语言搜索 PDF、收据和截图内部的内容,而不再受限于文件名。
语义视觉搜索:用自然语言找照片
Pipit 支持用大白话描述来检索相册,比如输入“yellow vintage car”或“handwritten grocery list”。这背后依赖的是多模态模型对图像内容的理解,而非传统的标签或元数据匹配。
多模态模型是指能够同时处理和理解文本、图像等多种数据类型的神经网络。在视觉搜索场景中,这类模型通常使用对比学习(如 CLIP 架构)将图像和文本映射到同一个语义向量空间,使得“黄色复古汽车”这样的文本描述可以直接与图像内容进行相似度匹配。与依赖人工标签或 EXIF 元数据的传统相册搜索不同,多模态模型能理解画面中的物体、场景甚至手写文字,从而实现更自然的检索。Pipit 将量化后的多模态模型部署在手机端,意味着推理过程完全本地化,但模型精度和速度会受量化程度与芯片算力的共同影响。
统一搜索栏:七个领域一网打尽
照片、PDF、消息、联系人、视频、音频、应用——七个领域被整合进同一个搜索入口。用户不必再打开不同 App 分别查找,降低了跨应用检索的摩擦。
100% 离线与气隙运行
Pipit 强调“Zero cloud, zero tracking”。所有处理都通过量化后的 Google LiteRT 多模态模型在手机芯片上完成,应用甚至可以完全断网(air-gapped)运行。对于隐私敏感的用户来说,这是最大的卖点。
量化(Quantization)是模型压缩的一种常用技术,通过降低神经网络权重和激活值的数值精度(例如从 32 位浮点数降到 8 位整数)来减小模型体积、降低内存占用并加速推理。对于在手机端运行多模态模型而言,量化几乎是必由之路,因为原始模型往往高达数百 MB 甚至数 GB。Google LiteRT(原 TensorFlow Lite)提供了训练后量化和量化感知训练等工具链,支持在 CPU、GPU 和 NPU 上高效执行。不过,量化会引入一定的精度损失,压缩率越高,模型在细粒度识别任务上的召回率可能越低,这也是端侧 AI 搜索需要权衡的核心问题之一。
低于 50ms 的延迟
通过本地 Vulkan GPU/NPU 委托加速,Pipit 声称搜索延迟控制在 50 毫秒以内。这一数字如果能在中端设备上稳定复现,将显著优于需要网络往返的云端方案。
Vulkan 是一个跨平台的低开销图形与计算 API,在 Android 上被广泛用于 GPU 通用计算。通过 Vulkan 委托,机器学习推理框架可以将部分算子卸载到 GPU 执行,从而利用其大规模并行能力加速模型运算。NPU(神经网络处理单元)则是手机 SoC 中专门为神经网络推理设计的硬件单元,能效比通常优于 CPU 和 GPU。Pipit 声称利用 Vulkan GPU/NPU 委托实现低于 50ms 的搜索延迟,但实际表现高度依赖设备是否支持相应的委托后端、模型算子是否被完全覆盖,以及索引规模大小。不同芯片厂商对 LiteRT 委托的支持程度差异较大,这也是跨设备兼容性面临的主要挑战。
开源策略与可及性
Pipit 的源码和发布版 APK 均已托管在 GitHub(github.com/sanjay434343/Pipit)。开源意味着安全审计、社区贡献和二次开发成为可能,也降低了用户对“黑盒 AI”的信任门槛。
从技术选型看,项目重度依赖 Google 的 ML Kit 与 LiteRT(前身为 TensorFlow Lite)生态,这为其跨设备兼容性提供了一定保障,但也意味着模型体积和硬件加速能力会受限于 Google 的工具链支持范围。
值得关注的挑战
尽管方向诱人,Pipit 仍面临几个现实问题。其一,语义视觉搜索的质量高度依赖量化模型的精度,在低端设备上压缩率更高时,召回率可能打折扣。其二,七个领域的索引建立需要时间,首次全盘扫描的耗时和电量开销尚未在原文中披露。其三,50ms 延迟的测试条件(设备型号、图片库规模)不明确,实际体验可能存在差异。
这些正是开发者公开寻求反馈、批评与想法的原因——对于一个早期开源项目而言,社区验证比宣传数字更有价值。
小结
Pipit 代表了一个清晰的技术趋势:AI 搜索正在从云端下沉到端侧。当隐私、延迟和离线可用性成为刚需,像 Pipit 这样把多模态模型塞进手机、用开源方式交付的尝试,值得 Android 用户和开发者保持关注。
相关推荐
Cohere质疑开源模型与Anthropic IPO同日:巧合还是策略?
Reddit用户发现Cohere批评开源模型的文章与Anthropic提交IPO在同一天发布,引发社区对闭源厂商公共言论商业动机的讨论。本文分析这一时间巧合背后的开源与闭源之争,以及社区反应揭示的信任问题。
纽约ROS开发者聚会:四家机器人公司演讲
纽约ROS开发者聚会将于周四在谷歌办公室举行,Fauna Robotics、Intrinsic、Tangent Robotics、Cohesive Robotics等公司代表将发表演讲,活动免费并提供餐饮,开放报名与演讲征集。
本地AI王者:日耗12M token背后的算力差距与竞争焦虑
Reddit开发者自嘲本地AI王者:日耗12M token,却被每分钟34M token的云端玩家降维打击。文章探讨本地部署与云端自动化的算力差距、token消耗量背后的行业焦虑,以及开发者如何在两种模式间找到平衡。