PixVerse R2:可实时探索与改变的世界模型
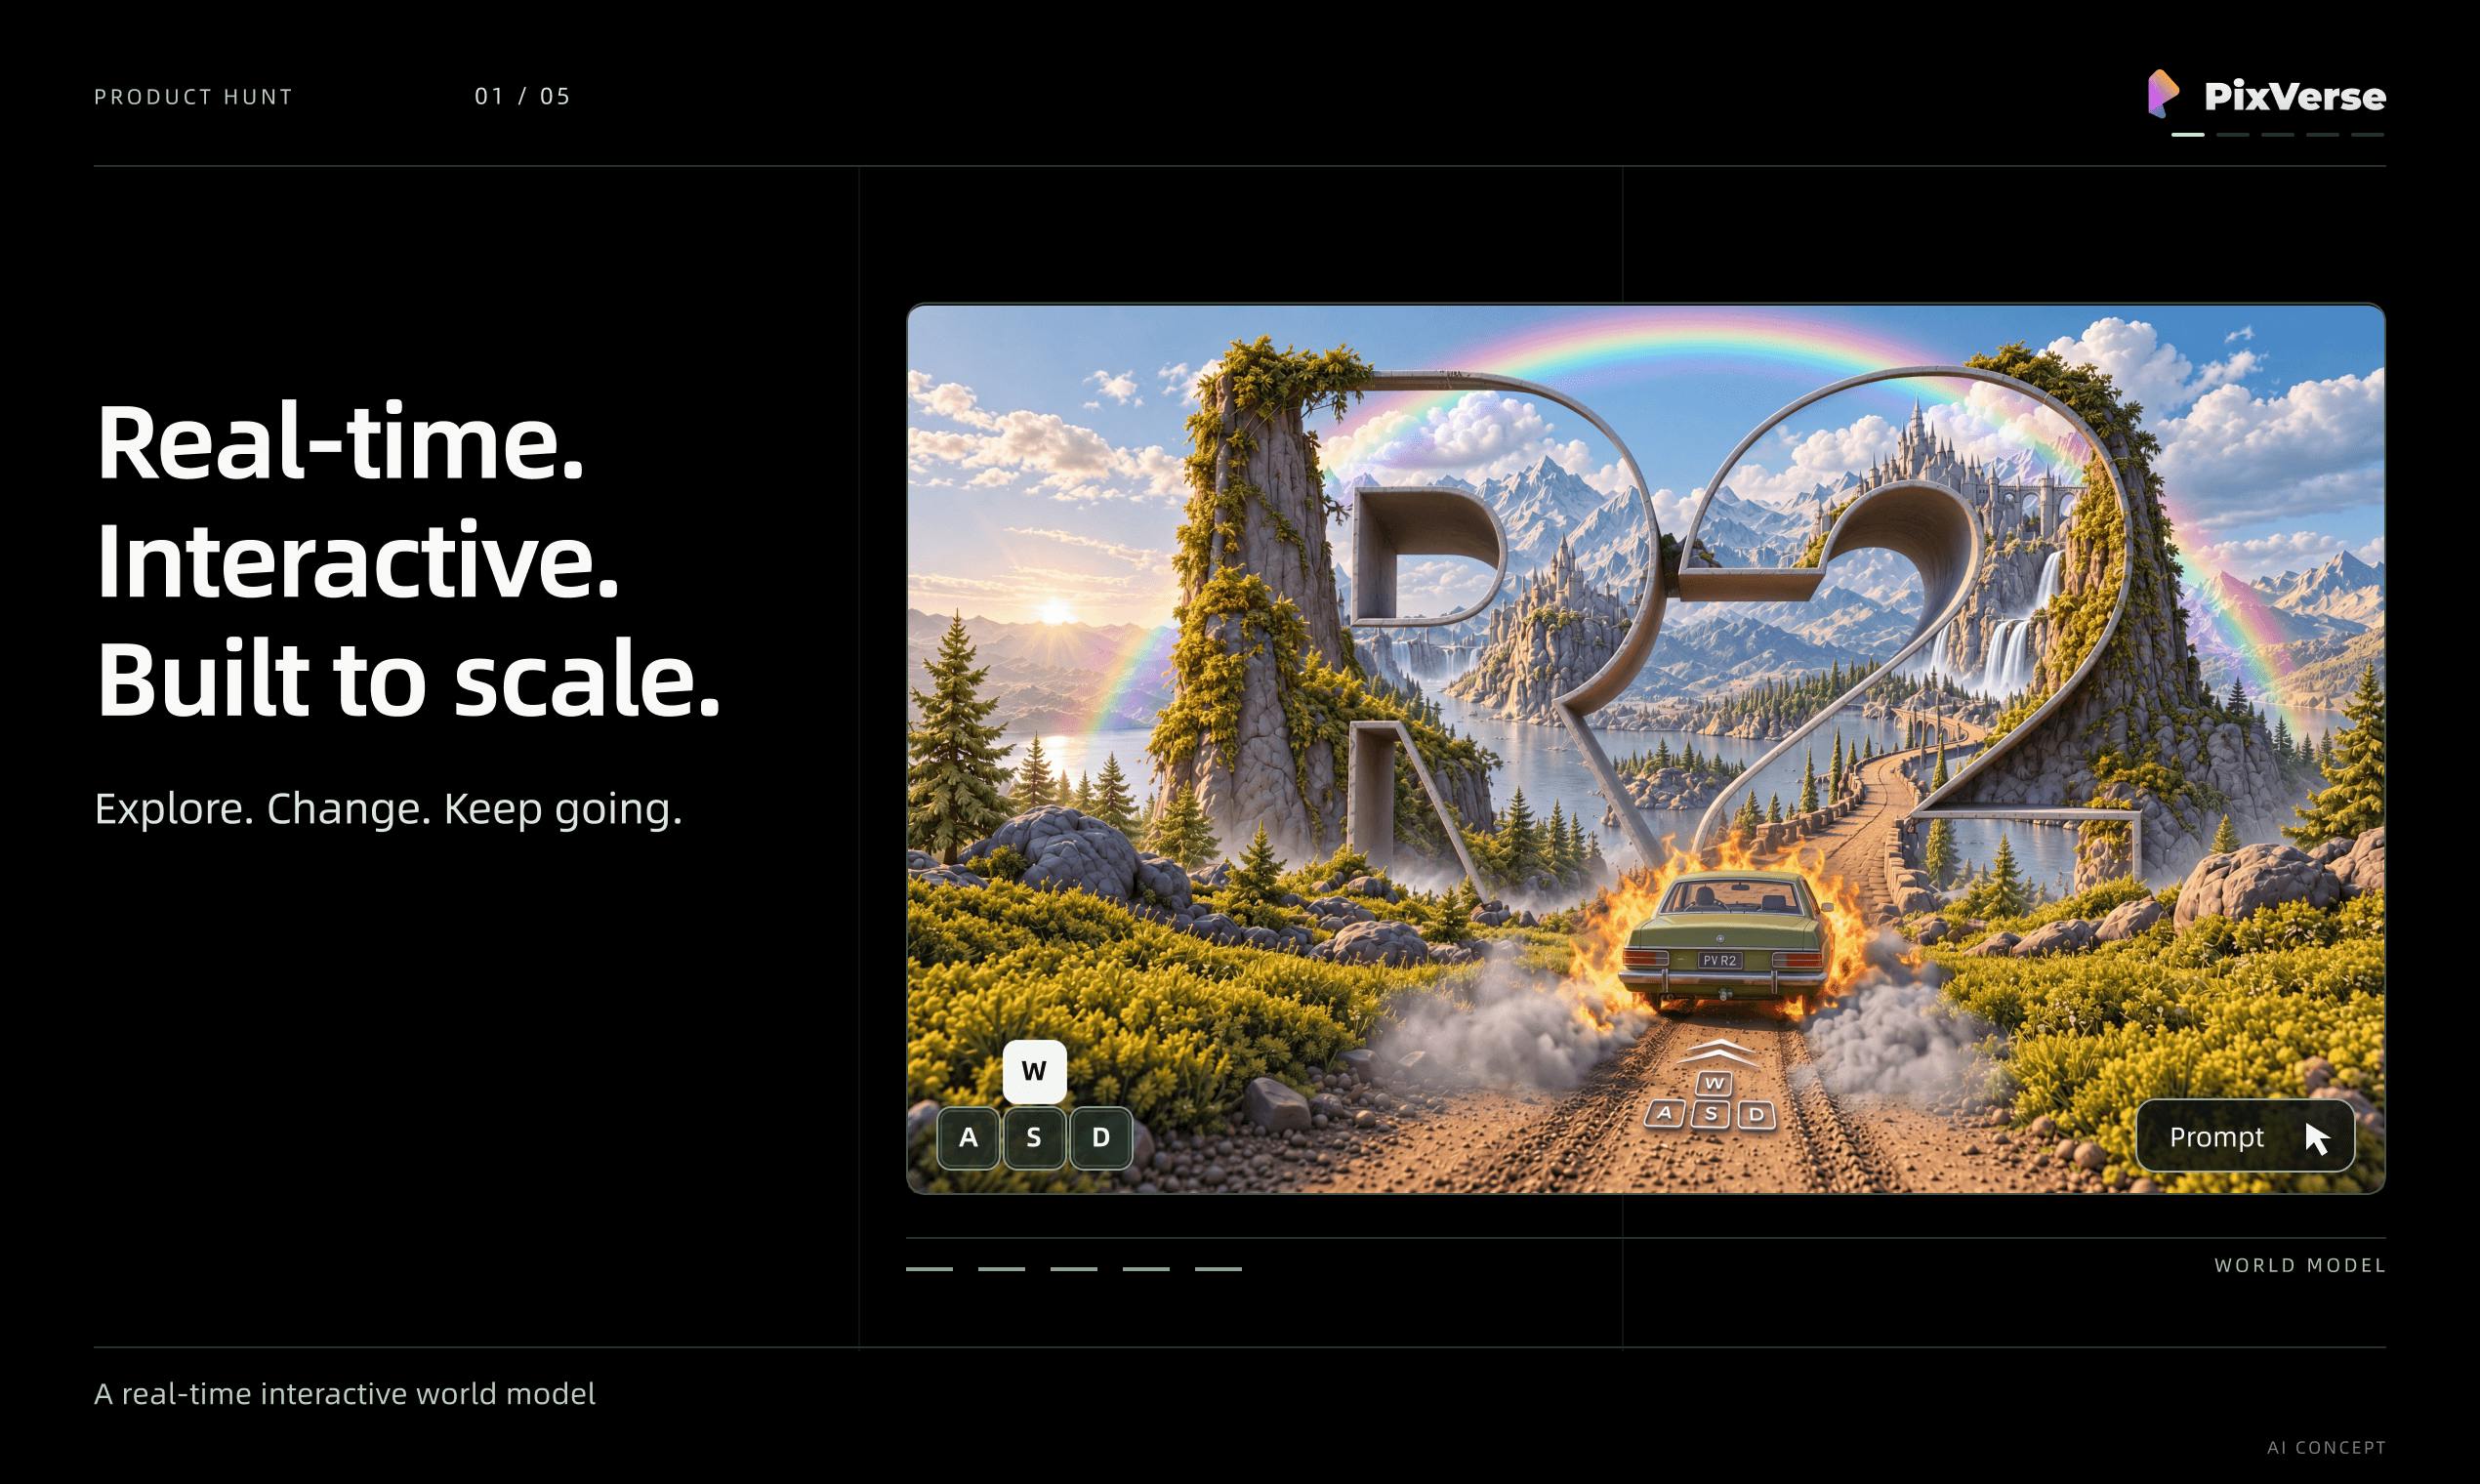
PixVerse R2 将视频生成升级为支持多模态输入与会话记忆的实时可交互世界模型。
PixVerse R2 是一款定位为"实时世界模型"的生成式AI产品,打破了传统文生视频"一次提示、一次输出"的静态逻辑。它支持文本、图像、音频和动作的多模态实时输入,并具备会话记忆能力,能将用户在世界中留下的变化持续延续到后续生成中,从而维持一个连贯、可干预的动态环境。官方将其应用场景指向交互式故事、生成式角色以及可玩世界,并将其归类为开发工具,暗示平台定位而非纯消费产品。该产品在 Product Hunt 登顶当日榜首,市场反响积极,但其实际延迟、长会话一致性等关键指标仍有待实测验证。
从视频生成到"可交互世界"的跃迁
生成式AI在视频领域的进展一直集中在"生成一段固定片段"这件事上——你给出提示词,模型输出一段几秒钟的视频,然后结束。PixVerse R2 试图打破这种一次性的生成逻辑。它把自己定位为一个实时世界模型(real-time world model),不再产出静态的视频剪辑,而是生成一个持续演化的视听世界。
这款产品在 Product Hunt 上登顶当日榜首(#1),获得 216 票和 42 条评论,被归类到 Developer Tools、Artificial Intelligence、Games 以及 Vercel Day 等多个分类,反映出它横跨开发工具、AI 与游戏的定位。
R2 究竟做了什么不一样的事
按照官方描述,R2 的核心差异在于三点:多模态输入、会话记忆与实时延续。
它可以在生成过程中接受文本、图像、音频和动作作为输入——这意味着交互不是一次性的提示词,而是贯穿整个体验的持续指令。你可以在世界运行的过程中随时改变它。
更关键的是记忆能力。R2 会"记住"会话中早先发生的事情,并把这些变化延续到之后的生成中。这一点将它与传统的文生视频模型彻底区分开来:后者每次生成都是独立、无状态的,而 R2 试图维持一个连贯的、有因果关系的世界状态。
为什么"记忆"是关键门槛
对于一个可探索的世界来说,一致性是最大的技术难点。如果你在场景里移动、改变某个物体,然后回头再看,世界应当保持你留下的痕迹,而不是重新随机生成。R2 强调"carries those changes forward in real time"(实时把变化延续下去),正是在回应这个长期困扰生成式视频的连贯性问题。
从技术架构角度看,维持会话记忆对生成模型而言代价极高。传统的扩散模型或自回归视频模型在每次生成时都从噪声或上下文窗口出发,历史状态并不以显式形式保留。要实现"留下痕迹"的效果,模型要么需要将整个历史帧编码进条件向量,要么维护某种外部状态表示(如场景图或隐空间的世界状态向量)。前者随时间增长会带来显著的计算开销,后者则要求模型学会将高维视觉信息压缩成可寻址、可更新的结构化记忆。这正是当前学术界和工业界在"持久世界模型"方向上尚未完全解决的核心问题,也是判断 R2 实际能力边界最需要实测验证的环节。
潜在的应用场景
官方把 R2 的能力指向了从交互式故事、角色到可玩的生成式世界的完整光谱。
这几类场景的共同点在于:它们都需要一个既能被用户实时干预、又能保持内部逻辑连贯的动态环境。交互式叙事需要角色对用户输入作出反应;可玩世界则更接近游戏,要求环境响应动作并维持物理与视觉的一致性。
把它分类到 Developer Tools,也暗示 PixVerse 希望开发者能在此之上构建应用,而不仅仅是把它当作一个终端消费产品。这与近来"世界模型"作为 AI 基础设施的行业趋势相吻合。
定位与行业背景
"世界模型"近来成为 AI 领域的高频词。相较于生成孤立的媒体内容,世界模型试图让 AI 理解并模拟一个可持续演化的环境状态,这被不少研究者视为通向更强通用能力的路径之一。
PixVerse R2 把这个概念带到了实时、可交互、多模态的产品层面。从 Product Hunt 的高投票和登顶表现看,市场对这种"可探索、可改变"的生成范式确实抱有兴趣。不过需要提醒的是,目前公开信息主要来自产品的官方描述,实际的生成质量、延迟表现、可控性精度以及长会话下的一致性稳定度,都还需要更多实测来验证。
"世界模型"概念最早在强化学习领域被系统性提出,核心思路是让智能体学习一个环境的内部表示,从而在"想象"中规划动作而无需每步都与真实环境交互。Yann LeCun 等人将其进一步推广为构建通用人工智能的必要组件,主张模型需要理解世界的因果结构和物理规律,而不只是拟合感知数据的分布。近年来,Google DeepMind 的 Genie、OpenAI 对视频模型的"世界模拟器"定位,以及多家游戏公司探索用神经网络替代传统游戏引擎的尝试,都在将这一学术概念推向产品化。PixVerse R2 是这一趋势中较早明确以"实时可交互"为卖点面向开发者发布的产品之一。
小结
PixVerse R2 代表了生成式视频向"生成式世界"演进的一次明确尝试:多模态输入、会话记忆、实时延续,共同指向一个连贯且可干预的动态世界。对于关注交互式内容、生成式游戏和 AI 基础设施的开发者而言,这是一个值得持续跟进的方向。它能否兑现"可探索、可改变的世界"这一承诺,最终仍要看真实使用中的表现。
相关推荐
Qwen Image 2.1 换脸 LoRA 上手:bestfaceswap 实测观察
基于 Qwen Image 2.1 的换脸 LoRA 模型 bestfaceswap(bfs)通过自然语言指令实现多图头部替换。本文梳理其技术定位、LoRA 换脸原理及使用中的效果与合规注意点。
AI设计芯片时代来临?TechCrunch Disrupt聚焦AI硬件闭环
TechCrunch Disrupt 2026上,Ricursive Intelligence创始人Anna Goldie与Azalia Mirhoseini将探讨AI如何设计自己的硬件,闭合AI与芯片开发的循环。解析AI辅助芯片设计的前景与挑战。
以内核为中心:在Trainium上实现实时视频生成
Reactor与AWS合作,借助Neuron Kernel Interface(NKI)从内核层面攻克动态形状、内存访问与缓存管理三大难题,在Trainium芯片上实现实时自回归扩散视频生成,且方法可跨模型泛化。