Plurai Simulation:让AI Agent在模拟世界中越跑越强

Plurai Simulation 用一条命令为 Agent 构建隔离的数字孪生沙箱,让行为级 bug 在发布前暴露。
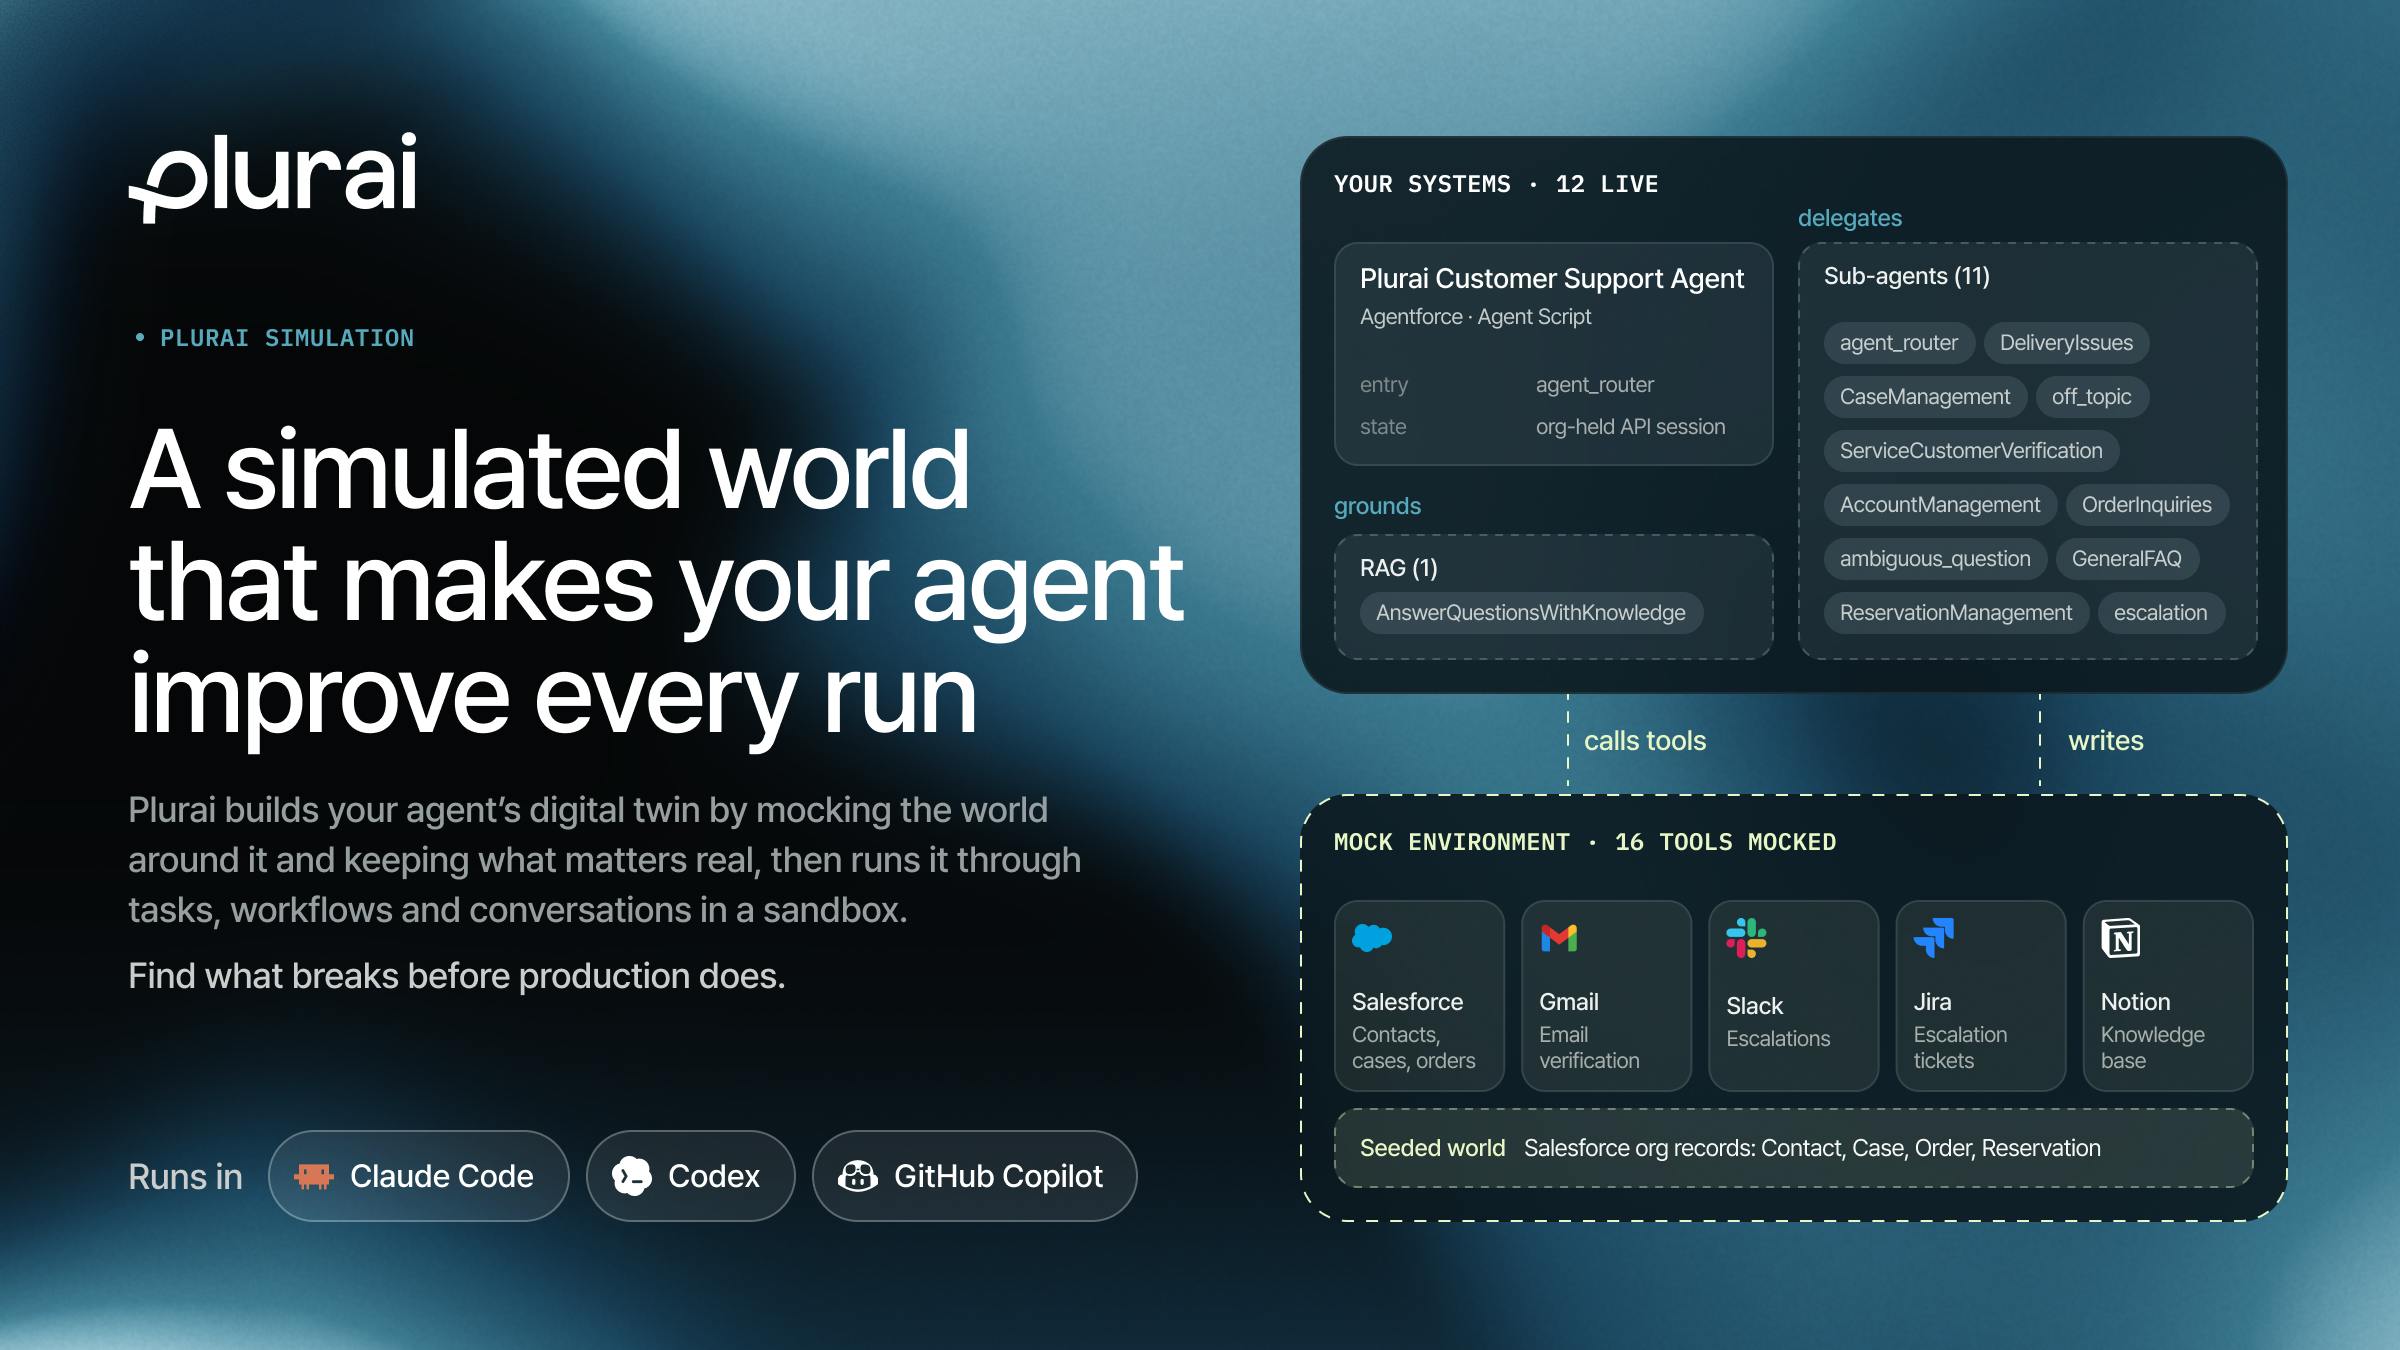
Plurai Simulation 是一款在 Product Hunt 登顶的 Agent 测试工具,核心思路是为 Agent 构建一个可运行的“数字孪生世界”:包含合成 persona、文档以及被 mock 的工具、API 和数据库,全部运行在与生产完全隔离的沙箱中。开发者只需在 Claude Code、Codex 或 GitHub Copilot 中执行一条命令即可接入,无需迁移 IDE 或重写工作流。它瞄准的是 Agent 的行为级缺陷——如错误建议、上下文丢失、工具调用偏差——这些传统测试难以覆盖。产品宣称每次运行都能让 Agent 改进,但“越跑越好”的实现机制尚未公开,模拟环境保真度也需第三方验证。
AI Agent 的调试一直是开发者的痛点:真实用户遇到 bug 时,你才发现问题,代价往往已经产生。Product Hunt 上登顶的 Plurai Simulation 试图改变这一局面——它用一个命令为你的 Agent 构建"数字孪生世界",让它在发布前就把最糟糕的 bug 暴露出来。
核心思路:给 Agent 造一个可运行的平行世界
Plurai Simulation 的定位是"一个让 Agent 每次运行都变得更好的模拟世界"。它的做法不是简单地跑单元测试,而是为 Agent 所处的业务环境建立数字孪生:合成的人物角色(persona)与文档、被 mock 的工具、API 和数据库,全部运行在与生产环境完全隔离的沙箱中。
这意味着 Agent 面对的是一套"看起来真实、但绝不会污染生产"的环境。开发者可以放心让它反复试错,而真实用户永远不会成为第一个发现 bug 的人。官方一句话概括得很直接:在你的用户之前,找到 Agent 最糟糕的 bug。
这个思路的价值在于,Agent 类应用的失败模式往往不是代码报错,而是行为层面的问题——比如对某类用户给出错误建议、在多轮对话中丢失上下文、调用工具时参数理解偏差。这些问题传统测试很难覆盖,只有让 Agent 在接近真实的环境里跑起来才可能暴露。
数字孪生(Digital Twin) 在 Agent 测试语境下,指的是对 Agent 所交互的业务系统(用户、文档、工具、API、数据库)建立一份行为等价但物理隔离的镜像副本。与传统的 mock 不同,数字孪生强调环境的结构与状态同步:合成 persona 模拟真实用户的分布特征,mock 工具返回与真实接口语义一致的响应,沙箱则复刻生产拓扑。其目的是让 Agent 在“高保真但零风险”的环境里运行,从而暴露那些只在真实交互中才会出现的行为缺陷。数字孪生的保真度直接决定了测试的有效性——过于简化会漏掉边缘场景,过度拟合真实数据又可能引入隐私与同步成本。
合成 persona(Synthetic Persona) 是指由系统生成的虚拟用户角色,通常包含背景信息、目标意图、语言风格和行为偏好等维度。在 Agent 测试中,合成 persona 的价值在于覆盖开发者难以手工枚举的用户类型与交互路径:例如不同知识水平的用户、带有歧义或情绪化表达的提问者、以及刻意触发边界条件的“压力型”角色。通过批量生成 persona 并与 Agent 对话,可以在发布前系统性地探测行为级缺陷。需要注意的是,合成 persona 的分布若偏离真实用户,测试结论的可迁移性就会打折,这也是评估此类工具时必须追问的保真度问题。
一条命令接入主流 AI 编程工具
Plurai Simulation 的使用门槛被压得很低:在 Claude Code、Codex 或 GitHub Copilot 中执行一条命令,即可完成模拟世界的搭建。它不要求团队迁移到新的 IDE 或重写现有工作流,而是直接嵌入开发者已经在用的编程助手生态。
从产品分类看,它被同时归入 API、开发者工具和人工智能三个类别,说明其定位不只是一个独立应用,更可能是可以被集成进 CI/CD 或 Agent 开发流水线的基础设施。每次运行都让 Agent 改进,意味着模拟测试可以像回归测试一样常态化执行,而不是一次性的人工验证。
这种"命令行即接入"的形态,也解释了它为何能在 Product Hunt 拿到 153 票、51 条评论并登上榜首——它切中的是正在快速扩张的 Agent 开发者群体的真实需求。
行为级测试(Behavioral Testing) 与传统的单元测试、集成测试关注代码路径和接口契约不同,它检验的是 Agent 在多轮交互中表现出的决策与输出是否合理。Agent 的典型失败往往不是抛出异常,而是“静默错误”:给出看似合理但事实错误的建议、在长对话中遗忘关键约束、调用工具时误解参数含义、或在边界输入下采取不当动作。这类问题无法靠断言精确捕获,需要通过场景化运行、对比预期行为分布或人工评审来发现。模拟世界正是为行为级测试提供了可重复、可批量执行的运行载体,使其具备回归测试的工程形态。
谁最需要它:Agent 开发者的发布前保险
从使用场景看,Plurai Simulation 最直接的价值对象是正在构建对话式 Agent、工作流 Agent 或工具调用型 Agent 的团队。这类团队普遍面临两个矛盾:一方面,Agent 的行为空间巨大,手工测试无法穷举;另一方面,直接在生产环境灰度又可能带来用户体验风险。
模拟世界的方案在这两者之间提供了中间地带。合成 persona 可以覆盖开发者想不到的用户类型,mock 的工具与数据库可以安全地模拟故障和边界情况,沙箱则保证一切试验都不会泄漏到真实系统。
说个细节,团队把"每次运行都改进"作为核心卖点,暗示产品内置了基于模拟结果的迭代机制,而非仅仅提供一个静态的测试环境。不过官方并未详细披露具体如何实现"越跑越好",这部分效果仍需实际使用来验证。
多源信息交叉与待观察之处
目前关于 Plurai Simulation 的公开信息主要来自其 Product Hunt 发布页,包括产品标语、功能介绍和团队名单(Maria Anosova、Tammy Wolfson、Reut Vilek、Ben Wisbih、Ilan Kadar、Arnon Mazza、Nir Aharon)。由于缺乏第三方独立评测,本文所述功能均基于官方描述,尚无外部数据交叉验证。
对开发者而言,值得关注的几个问题是:模拟环境与真实环境的偏差如何控制、合成数据能否覆盖足够多的边缘场景、以及"每次运行改进"是否会带来不可预期的行为漂移。这些都需要在真实项目中检验。但方向上,用模拟世界提前暴露 Agent 的行为缺陷,是 Agent 工程化绕不开的一步。
在 Agent 从 demo 走向生产的阶段,Plurai Simulation 提供了一个值得关注的思路:与其等用户踩坑,不如先给 Agent 造一个可以随便踩坑的世界。
相关推荐
DevWorkflow 5.0:用AI五步法从想法到上线
DevWorkflow 5.0 是 Claude Code 插件,用五步流程让 AI 辅助开发从想法到上线。每个决定先问你,避免 AI 擅自加表加字段、文档代码不一致、测试未写就合并。支持多平台多语言,个人开发者和小团队适用。
Hermes Agent的.md文件如何工作?核心机制解析
解析 Hermes Agent 的 .hermes 目录机制:user.md 存个人信息、memory.md 记录值得记住的细节、soul.md 定义 Agent 性格。了解这套纯 Markdown 文件如何让 Agent 跨会话保持一致行为。
联合国“杀手机器人”谈判再陷僵局:自主武器监管为何难破冰
联合国日内瓦会议就自主武器(“杀手机器人”)规则展开谈判,一周磋商收效甚微,代表仅同意“开始讨论选项”。本文分析谈判僵局背后的定义分歧、安全诉求冲突与多边机制局限。