PrismML押注微型大模型:小体积能否改写AI使用方式
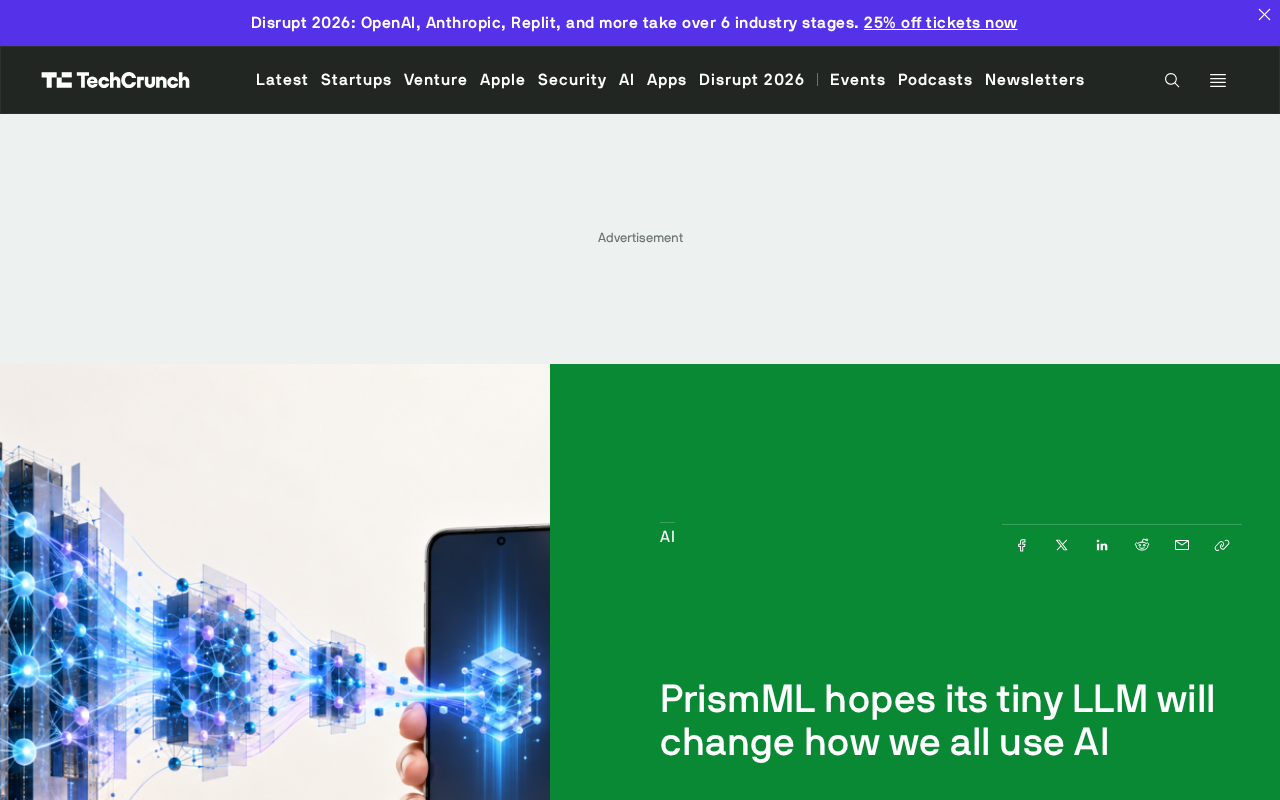
PrismML押注微型LLM,以本地运行、低成本、强隐私为核心优势,挑战云端巨型模型的主导地位。
PrismML是一家专注微型大语言模型(tiny LLM)的AI实验室,其核心主张是用体积极小的模型改变AI的使用方式。与动辄千亿参数的巨型模型不同,微型LLM可在手机、笔记本等终端设备上本地运行,无需依赖云端API,兼具低延迟、强隐私保护和低部署成本的优势。这一路线契合AI产业从「能力上限竞赛」向「效率与可用性竞赛」分化的大趋势,背后有知识蒸馏、量化、剪枝等成熟技术支撑。目前PrismML的具体参数规模与基准测试结果尚未公开,其愿景能否兑现仍需实证数据验证,但其所代表的「小模型落地」命题本身,已是当下AI演进不可忽视的重要方向。
PrismML为何值得关注
AI实验室PrismML正试图用一款体积极小的大语言模型(LLM)撬动整个行业的使用范式。原始报道用一句直白的话点明了它的分量——如果PrismML还没进入你的视野,那么现在应该把它加进去了。
这句判断背后,折射出一个正在升温的趋势:当业界主流仍在比拼千亿乃至万亿参数的巨型模型时,一批研究团队反其道而行,押注于「小而精」的路线。PrismML正是这股潜流中的代表之一。
需要说明的是,目前公开的原始素材信息量相当有限,仅传递出PrismML的核心愿景与市场定位。以下分析结合行业背景展开,帮助读者理解这一方向的意义,但具体的技术参数、基准测试成绩仍有待官方进一步披露。
微型LLM的想象空间
所谓「tiny LLM」,指的是参数规模、内存占用与推理成本都被大幅压缩的语言模型。它的价值不在于跑分榜上的绝对性能,而在于把AI能力从云端数据中心「下放」到更贴近用户的设备与场景。
微型模型的吸引力体现在几个层面。它可以在手机、笔记本甚至嵌入式设备上本地运行,无需持续联网调用云端API;本地推理意味着数据不必上传,天然具备更强的隐私保护属性;同时,更低的算力需求直接转化为更低的部署与运营成本。
PrismML所谓「改变我们使用AI的方式」,很可能指向的正是这种从「集中式云服务」向「分布式本地智能」的转变。如果一款足够小的模型能在保证可用性的前提下嵌入日常工具,AI的触达半径将被显著拓宽。
从参数规模来看,业界通常将10亿(1B)以下的模型称为「微型模型」,1B-7B区间称为「小型模型」,而GPT-4级别的模型参数量估计超过万亿。实现模型「瘦身」的核心技术手段主要有三类:知识蒸馏(让小模型模仿大模型的输出分布,迁移其「知识」)、量化(将模型权重从32位浮点数压缩为8位甚至4位整数,大幅减少内存占用)、以及剪枝(移除对最终输出贡献较低的神经网络连接)。这三类技术往往组合使用。Meta的Llama系列、微软的Phi系列、谷歌的Gemma系列都是近年来小型/微型模型路线的典型案例,其中Phi-2(2.7B参数)在多项基准测试中已能媲美体量大出数倍的模型,印证了「小而精」路线的可行性。
小模型路线的行业逻辑
近一两年,模型「瘦身」已成为技术竞赛的重要支线。大型模型固然能力全面,但推理成本高、响应延迟大、部署门槛陡峭,并不适配所有场景。对大量具体、垂直的任务而言,一个经过精心训练与蒸馏的小模型,往往就能提供「够用」的效果。
这条路线的商业逻辑同样清晰。对开发者和企业来说,能在本地运行的小模型降低了对昂贵GPU集群和云端调用的依赖,让AI功能的规模化落地更具经济可行性。PrismML选择在此时切入,正是看准了效率与成本这一被巨型模型忽视的价值洼地。
从更宏观的视角看,AI产业正在经历从「能力上限竞赛」到「效率与可用性竞赛」的分化。前者追求突破边界,后者追求落地普及,二者并不矛盾,反而构成了完整的产业生态。
「模型蒸馏」值得单独解释,因为它是小模型能力跃升的关键机制。蒸馏的核心思想是:大型「教师模型」不仅输出最终答案,还输出每个词汇的概率分布(称为「软标签」)。这些概率分布包含了远比单一正确答案丰富的信息——例如模型认为第二可能的答案是什么、不同选项之间的相对置信度。小型「学生模型」通过学习这些软标签,能以远低于从头训练的成本,习得大模型的部分推理能力。这解释了为何当下一些参数量仅为GPT-4千分之一的模型,在特定垂直任务上仍能达到接近水平的表现。对PrismML而言,其技术护城河很可能就在于蒸馏策略与目标任务的精准匹配。
尚待验证的关键问题
愿景动人,落地却需要硬指标支撑。PrismML的微型模型究竟小到什么程度、在哪些任务上能媲美更大的模型、实际推理速度与能耗表现如何,这些核心问题在现有素材中都尚未给出答案。
对于任何宣称要「改变行业」的产品,真正的考验来自可复现的基准测试、真实场景中的表现,以及开发者社区的实际反馈。在这些数据公开之前,谨慎乐观是更理性的态度。
对关注AI落地的读者而言,PrismML提供了一个值得持续跟踪的观察样本:它代表的「小模型改变使用方式」这一命题,本身就是当下AI演进的重要方向之一。后续如果有更详实的技术披露,这个故事才会真正立体起来。
相关推荐
NVIDIA TensorRT Model Connect:两行命令部署开源模型
NVIDIA TensorRT Model Connect 让开源模型部署仅需两条命令,无需 ONNX 转换。支持 LLM、扩散、视频生成等多类模型,兼容 RTX 消费级 GPU,并新增双 DGX Spark 多设备推理能力。
NVIDIA cuML 加速谱聚类:Scikit-Learn 提速100倍实测
NVIDIA cuML 让 Scikit-Learn 谱聚类无需重写代码即可在 GPU 上运行,大规模数据下提速超 200 倍。本文解析其原理、接入方式及在金融期权数据中的实测表现。
谷歌DeepMind成立新机构:把AGI大辩论摆上台面
Google DeepMind成立新机构,旨在把通用人工智能(AGI)的重大问题带入公共辩论。本文分析这一举措背后的行业信号,以及从技术竞赛走向公共治理的转向意义。