PrO-GPs:以预测为核心重塑高斯过程后验推断

PrO-GPs将预测校准作为首要目标,使高斯过程在模型错误设定时仍能给出可靠的不确定性估计。
高斯过程(GP)是量化不确定性的经典工具,但其预测质量高度依赖核函数与观测模型的正确选择,一旦「错误设定」便会导致置信区间严重失准。新论文提出的PrO-GPs(预测导向高斯过程)反转了传统推断逻辑:不再以刻画底层函数的后验为首要目标,而是直接将预测不确定性的校准质量作为推断核心。为解决非参数模型下直接计算不可行的问题,作者推导了简化数学形式并设计了配套采样方案。在合成与真实数据实验中,PrO-GPs在模型错误设定条件下的预测分布校准性能显著优于标准GP,为贝叶斯优化、科学建模等对不确定性敏感的应用场景提供了更可靠的替代方案,同时呼应了统计机器学习领域「预测驱动推断」与「鲁棒贝叶斯」的前沿研究趋势。
高斯过程的痛点:设计选择决定成败
高斯过程(Gaussian Processes, GPs)是机器学习与统计建模中量化不确定性的强大工具。它能够对函数关系进行建模,并给出带有置信区间的预测结果,广泛应用于贝叶斯优化、空间统计、时间序列预测等场景。
然而,GP 的强大是有代价的。使用者必须做出一系列关键的设计决策——最典型的就是核函数(kernel)的选择与观测模型(observation model)的设定。这些选择看似技术细节,却直接决定了模型能否真实捕捉数据背后的生成过程。一旦选择失当,模型就会出现「错误设定」(misspecification),导致预测分布失真、不确定性估计不可靠。
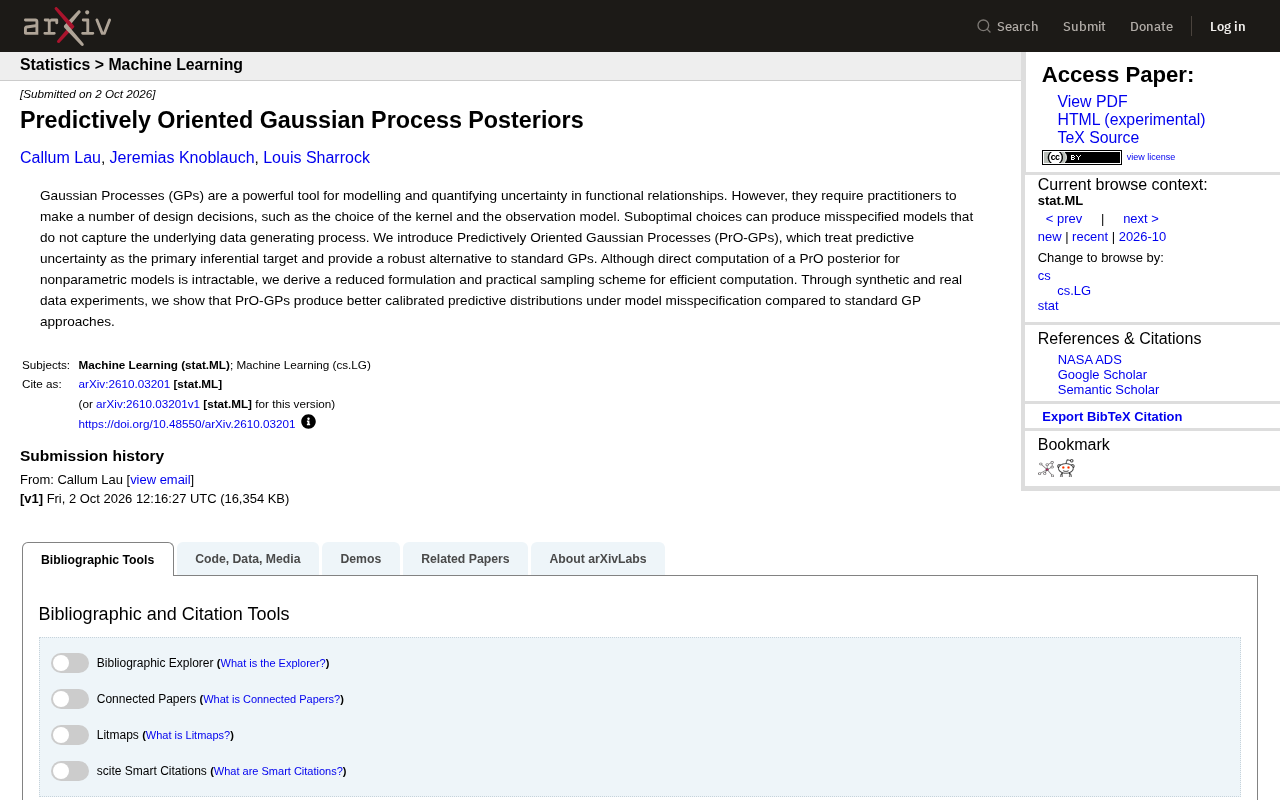
这正是一篇新发表的 arXiv 论文(arXiv:2610.03201)试图解决的问题。研究者提出了 Predictively Oriented Gaussian Processes(PrO-GPs,预测导向的高斯过程),重新审视了 GP 推断的目标优先级。
**核函数(kernel)**是高斯过程的核心组件,它定义了函数值之间的相似性结构,本质上编码了对数据平滑程度、周期性、趋势等先验假设。常见的核函数包括径向基函数(RBF/Squared Exponential)、Matérn 核、周期核等,不同选择会产生截然不同的预测行为。观测模型则决定了如何处理测量噪声——例如假设噪声为高斯分布还是厚尾分布。这两个设计决策往往需要领域知识或大量调参,而错误设定(misspecification)的后果是双重的:预测均值可能偏离真实值,更危险的是不确定性估计会系统性地失准,让使用者对错误结果产生虚假的信心。在贝叶斯优化等场景中,这种失准会直接导致采集函数给出错误的探索方向,累积误差随迭代急剧放大。
核心思路:把预测不确定性当成第一目标
标准 GP 的推断逻辑是:先在参数或函数空间上建立后验,再从后验推导出预测分布。这意味着预测质量某种意义上是建模假设的「副产品」——如果核函数或观测模型选错了,预测自然就会跟着偏。
PrO-GPs 的创新在于反转这一优先级。它将「预测不确定性」直接作为主要的推断目标(primary inferential target),而不是先纠结于底层函数的精确形式。换句话说,与其追问「真实的函数长什么样」,PrO-GPs 更关心「我对未来观测的预测分布是否被良好校准」。
这种以预测为中心的视角,使模型在面对错误设定时更加稳健。即便核函数的选择并不完美,PrO 后验仍能提供相对可靠的预测区间,这对实际应用中难以保证模型完全正确的场景尤为重要。
为什么稳健性如此关键
在真实世界的数据建模里,「模型正确设定」几乎是一种奢望。数据生成过程往往比我们假设的任何核函数都复杂。标准 GP 在这种情况下容易给出过度自信或过度保守的不确定性估计,而这恰恰是下游决策(如主动学习、贝叶斯优化)最忌讳的。PrO-GPs 提供的正是一条「即使模型不完美也能用得放心」的路径。
技术挑战与解决方案
理论虽然优雅,但落地并不容易。论文坦言,对于非参数模型而言,直接计算 PrO 后验是难以处理的(intractable)。这是因为预测导向的目标涉及对无限维函数空间的复杂积分,无法用封闭解表达。
为此,研究者做了两件事:
- 推导出一个简化形式(reduced formulation),将原本棘手的计算问题转化为可操作的数学表达;
- 设计了一套实用的采样方案(practical sampling scheme),使得 PrO 后验能够被高效地近似计算。
这套「理论简化 + 采样近似」的组合,是让 PrO-GPs 从概念走向可用工具的关键一步。它既保留了预测导向的核心优势,又避免了计算上的不可行。
「难以处理(intractable)」在贝叶斯推断中指无法用有限步骤的解析公式精确计算后验分布,通常是因为归一化常数涉及高维积分。标准GP之所以存在解析解,得益于高斯分布在线性运算下的封闭性——高斯先验加高斯似然依然给出高斯后验。但PrO-GPs的预测导向目标打破了这一共轭结构,使后验形式变得更为复杂。论文采用的采样方案本质上属于蒙特卡洛近似族(如MCMC或重要性采样),用大量样本估计原本无法精确计算的后验期望。「简化形式」的推导则是通过数学变换将目标函数化为更易操作的等价表达,减少采样所需的计算量,使方法在中小规模问题上具备实用性。
实验验证:校准性能的提升
论文通过合成数据与真实数据两类实验来验证 PrO-GPs 的有效性。结果显示:在模型错误设定的条件下,PrO-GPs 产生的预测分布比标准 GP 方法校准得更好(better calibrated)。
「校准」是评估概率预测质量的核心指标——一个良好校准的模型,其声称的 90% 置信区间应当真的有约 90% 的概率覆盖真实值。标准 GP 在错误设定下往往校准失准,而 PrO-GPs 的实验表现表明,它在这一点上提供了实质性的改进。
这意味着,对于那些对不确定性量化高度敏感的应用——例如科学建模、风险评估、自动化实验设计——PrO-GPs 是一个值得关注的替代方案。
概率预测的**校准性(calibration)**可以通过校准图(reliability diagram)或连续排名概率分数(CRPS)等指标量化。直观理解:若一个模型声称某区间有80%的覆盖率,但在大量重复预测中实际只覆盖了60%的真实值,则该模型存在「过度自信」的校准偏差;反之若实际覆盖率高于声称值,则模型过于保守,不确定性被高估。标准GP在核函数选择错误时,倾向于低估预测方差,产生过窄的置信区间,即过度自信的偏差,这在医疗、材料科学等高风险决策场景中尤为危险。PrO-GPs通过直接优化预测目标来缓解这一系统性偏差,其实验结果表明校准误差在错误设定条件下有显著改善。
意义与展望
PrO-GPs 的贡献不仅在于一个新的算法,更在于它提出的方法论转向:当我们无法保证模型完全正确时,与其追求对底层机制的精确刻画,不如直接优化我们真正关心的目标——预测本身。
这一思路与近年来「预测驱动推断」「鲁棒贝叶斯」等研究方向遥相呼应,反映出统计机器学习领域对模型错误设定问题日益重视的趋势。对实践者而言,PrO-GPs 提供了一个在真实、复杂、不完美数据环境下更可信赖的工具。
当然,作为一篇新发布的预印本,PrO-GPs 的进一步价值仍有待更广泛的实验与社区验证,例如在高维问题、大规模数据集上的可扩展性,以及与其他鲁棒 GP 变体的系统对比。但其核心理念已经为高斯过程建模指明了一个富有潜力的新方向。
相关推荐

问责机制也能充满乐趣:重塑自律与团队协作的新思路
问责机制常被视为压力与惩罚的代名词,但它其实可以充满乐趣。本文探讨如何通过同伴支持、进展可见化和庆祝小胜利,将问责重构为推动个人成长与团队协作的愉悦力量。

Claude Code 入门:读懂它是什么与多端用法
Anthropic 团队成员 Lydia 主讲的 Claude Code 入门分享:它不只是 CLI,而是可在终端、IDE、浏览器和桌面端运行的 AI Agent。本文梳理其本质定位、多端用法与学习路径。

OpenWiki 该不该收录 PRD 等叙事文档?取舍分析
在为项目构建 OpenWiki 时,是否该收录 PRD、设计、愿景等叙事文档?本文分析代码与叙事文档的本质差异、收录的收益与风险,并给出按成熟度筛选、标注时效、以代码为事实源等实用决策建议。