ProtoDiffusion:用原型令牌压缩多层图像生成

ProtoDiffusion 用共享原型加每层单向量压缩多层设计表示,原生生成图层结构。
文章介绍 ProtoDiffusion 及其配套自编码器 ProtoVAE 如何在扩散模型中原生生成多层 RGBA 设计。现有做法为每个图层分配一张满画布空间 latent grid,N 层设计需 N×H×W 个令牌,表示随图层数与画布尺寸线性膨胀。ProtoVAE 改为所有图层共享一张空间原型、每层仅保留一个候选向量,令牌量降至 HW+N,图层裁剪重建仍达 40.43 dB PSNR。ProtoDiffusion 在该紧凑 latent 空间联合去噪原型与固定数量的可空置候选槽,图层数量无需作为输入,边界框仅为可选布局引导,同一架构同时支持图像与文本条件生成。
多层设计生成的核心难题:表示随图层数线性膨胀
Graphic design 的本质是 RGBA 图层的堆叠——每个图层独立可选中、可移动、可复用,这正是设计师工作流的基础。但在生成模型里,要把一个设计表示为「多层」却代价高昂:现有做法为每一层分配一张满画布或区域大小的空间 latent grid,于是表示体量随图层的空间叠加范围线性增长。N 层设计就要占用 N×H×W 的令牌量,图层越多、画布越大,计算和显存压力越重。
来自 RSS 的新研究 ProtoDiffusion 提出另一条路线:不再为每层存一张 grid,而是让所有图层共享一张空间原型(spatial prototype),每层只保留一个候选向量(candidate vector)。这一设计将 N 层设计的表示压缩到 HW+N 个令牌(在骨干网络特定的打包之前),对比满网格方案的 NHW,差距是数量级的。
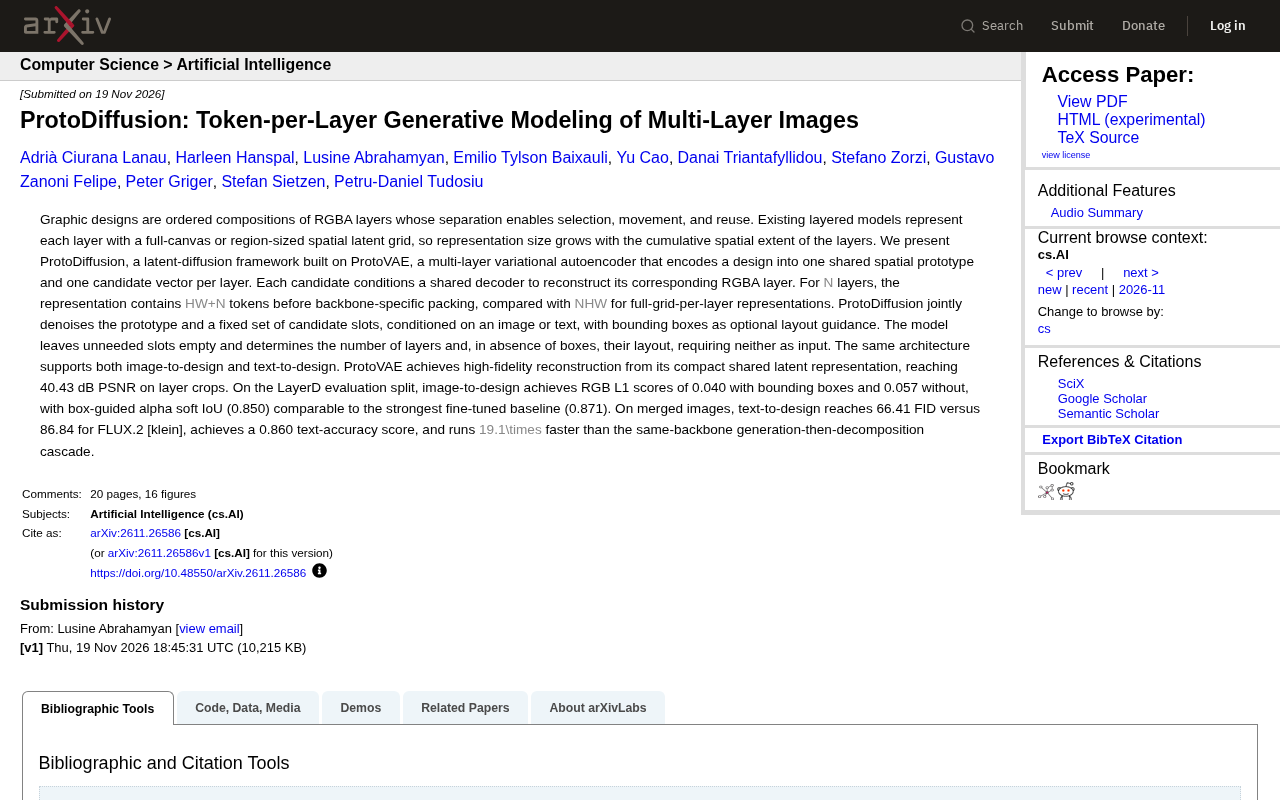
空间 latent grid 指自编码器把图像压缩后得到的二维特征图,空间维度上每个位置对应原图的一块区域(如 8×8 或 16×16 像素),每个位置带一个通道向量。令牌量即 H×W(按 patch 展平后)。对多层设计而言,每层各存一张 grid,就相当于为每层单独保留一份完整的画布特征,N 层叠加即为 N×H×W。这是理解本文动机的关键:设计图层的价值在于「独立可编辑」,但生成模型若照搬这一结构,就会把编辑粒度直接转化为显存与注意力计算的开销,因为 Transformer 的注意力复杂度对令牌数是超线性的。本文的压缩思路正是把「每层都有独立空间结构」这一冗余假设去掉。
ProtoVAE:共享原型 + 每层候选向量
这套表示来自配套的自编码器 ProtoVAE。它把一张设计编码成一个共享空间原型,外加每层一个候选向量;每个候选向量去条件化同一个共享解码器,重建出对应的 RGBA 图层。共享的空间结构由原型承载,图层间的差异由轻量的候选向量表达——相当于把「图层之间相同的东西」和「每层独有的东西」拆开建模。
这种拆分的关键收益是可扩展性。由于表示量只随层数线性增加一个固定长度的向量,而非整张空间网格,ProtoVAE 在图层裁剪上仍能达到 40.43 dB 的 PSNR,说明这套紧凑表示没有牺牲重建保真度。对下游生成任务来说,这意味着模型可以在不显著膨胀的 latent 空间里同时处理所有图层。
PSNR(峰值信噪比) 是重建质量的常用度量,单位为 dB,数值越高表示重建图与参考图逐像素误差越小。它以最大可能像素值(通常为 1 或 255)的平方除以均方误差再取对数,因此 dB 每提高约 3 大致对应误差减半。在自编码器文献中,30 dB 以上通常视为视觉上较好的重建,35–40 dB 区间则接近高质量。文章报告的 40.43 dB 是在图层裁剪这一设定下测得,意味着共享原型加每层单个向量的紧凑表示仍能保留图层细节(包括边界与透明度边缘),这是该表示能支撑下游生成的前提——若重建本身损失严重,扩散模型学到的 latent 分布也会失真。
联合去噪:原型与候选槽一起生成
ProtoDiffusion 把扩散过程放在这个紧凑 latent 空间里做:联合去噪共享原型和一组固定数量的候选槽(candidate slots),条件可以是图像或文本,边界框作为可选的布局引导。
几个设计细节值得注意:
- 槽位可空置:模型自行决定哪些候选槽为空,因此图层数量不需要作为输入提供,由模型自己判断。
- 布局可推断:在没有提供边界框的情况下,模型也能推断图层布局,框只作为可选约束而非必需输入。
- 一套架构双任务:同一模型同时支持 image-to-design 与 text-to-design,不需要为两个方向分别设计网络。
这种「固定槽位 + 可空置」的机制,把变长图层数的问题转化为在固定槽集合上的去噪问题,避免了为不同层数设计不同网络结构的麻烦。
扩散模型的联合去噪 指在同一个去噪网络中同时处理多组 latent 变量,让它们在同一步内相互感知。与「先独立生成再拼接」不同,联合去噪允许原型与各候选槽通过注意力互相传递信息,从而在生成过程中就保持图层间的空间对齐。候选槽(candidate slot) 是一组预设数量的可学习槽位,每个槽负责承载一个图层的候选向量;把槽位设计为可空置,等价于让模型自己输出一个「该槽是否有效」的判定,变长图层数因此被吸收进固定尺寸的张量里,无需 padding 或分桶训练。这也是该架构能同时兼容图像与文本条件的原因:条件只影响去噪输入,槽集合的结构不变。
实测表现:重建、布局与文本生成
在 LayerD 评测集上,image-to-design 的 RGB L1 分数为:有边界框时 0.040,无边界框时 0.057——布局引导带来的收益清晰可见,但即便去掉框,模型仍能给出可用的结果。框引导下的 alpha soft IoU 为 0.850,与最强微调基线(0.871)相当,说明压缩表示在图层透明度这一细节上并未明显丢分。
文本到设计方向的对比更能体现架构优势。在合并图像上,ProtoDiffusion 的 FID 为 66.41,对比 FLUX.2 [klein] 的 86.84;文本准确率分数达到 0.860;速度上比同骨干的「先生成再分解」级联方案快 19.1 倍。需要强调的是,这组对比的基线是级联式流程——先整图生成再做图层分解,而 ProtoDiffusion 直接在多层表示上生成,省掉了分解环节,速度差距主要来源于此。
FID(Fréchet Inception Distance) 衡量生成分布与真实分布的距离:用 Inception 网络提取特征,分别拟合两组特征的高斯分布,再计算二者之间的 Fréchet 距离,数值越低越好。它同时惩罚质量差与多样性不足,但对特征提取器和样本量敏感,跨论文的绝对数值不宜直接比较,只适合同一评测设定下的相对比较。文中 66.41 与 86.84 的对比需放在 LayerD 的评测协议下解读。alpha soft IoU 则是针对图层透明度通道的软交并比,衡量预测 alpha 掩码与真值的重叠程度,取值 0–1,越接近 1 说明图层边界与透明区域还原越准,它比 RGB 指标更能反映「图层是否能被干净地选中」。
为什么这条路线值得关注
把图层表示从「每层一张网格」压到「共享原型 + 每层一个令牌」,本质上改变了多层生成问题的复杂度结构。现有级联方案(生成整图 → 分解图层)的误差会在两个阶段累积,而 ProtoDiffusion 在单一模型内联合建模所有图层,图层间的空间对齐由共享原型天然约束。
当然,这套方法的边界也来自它的假设:共享原型意味着所有图层共享同一套空间结构先验,对于图层间空间分布差异极大的设计,这种共享是否仍然充分,论文给出的指标之外还需要更多场景验证。固定数量的候选槽也意味着超长图层设计需要依赖槽位复用或扩展策略。
从工程角度看,19.1 倍的加速和更低的表示开销,让多层设计的原生生成距离实际生产工作流更近了一步——设计师拿到的不是一张需要手动拆分的平面图,而是可直接选中、移动、复用的图层结构。
相关推荐
开源权重模型正在掉队:三大结构性原因
一位资深开发者基于自家平台使用数据与公开基准实验,论证开源权重模型为何正在被闭源前沿模型甩开:算力差距指数级扩大、蒸馏路径被封锁、递归自我改进只在闭源侧发生。

AI正在成为气候灾难?深度解析算力扩张的碳代价
AI算力扩张正在带来训练与推理的双重能耗压力,数据中心面临电力、散热与水资源的多重挑战。本文解析AI对气候的影响及行业可能的可持续出路。

印度国大党抗议者冲击Meta办公室:要求恢复账号
印度国大党成员在Meta德里办公室外抗议,要求恢复政党领导人账号,并警告将发起更多抗议。事件凸显社交平台账号管理与政治团体的紧张关系。