ProTok: 统一蛋白质分词的多码本量化新方案

ProTok 用模块化多码本量化与模态dropout构建统一蛋白质分词器,实现多模态灵活推理与生成。
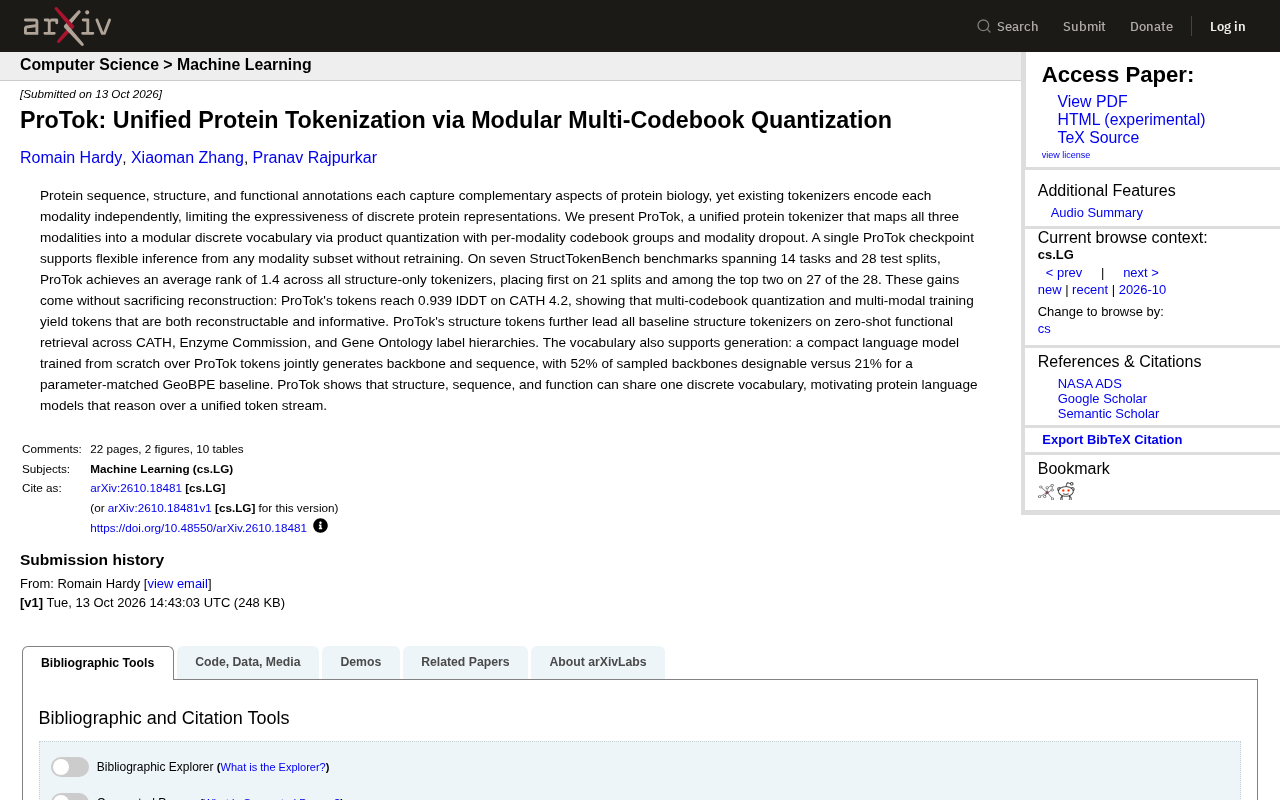
ProTok 是一个统一的蛋白质分词器,通过乘积量化为序列、结构和功能三种模态分配独立的 codebook 组,并借助模态 dropout 训练策略,使单一 checkpoint 无需重训即可支持任意模态子集推理。在 StructTokenBench 的 28 个测试划分上,ProTok 平均排名 1.4,21 个划分排名第一,27 个进入前两名。其 token 在 CATH 4.2 上达到 0.939 lDDT,证明下游性能提升未以牺牲重建质量为代价。结构 token 在 CATH、EC、GO 零样本功能检索上全面领先基线,且统一词汇表可支撑生成任务,采样骨架 52% 可设计,远高于 GeoBPE 基线的 21%。整体而言,ProTok 为蛋白质语言模型走向“统一 token 流、多模态输入”提供了可复现的范例。
蛋白质的序列、结构和功能注释各自捕捉了蛋白质生物学的不同侧面,但现有的分词器(tokenizer)大多独立编码每种模态,限制了离散蛋白质表示的表达能力。一篇新论文提出了 ProTok——一个统一的蛋白质分词器,通过模块化多码本量化(modular multi-codebook quantization),将三种模态映射到统一的离散词汇表中。
为什么蛋白质表示需要统一分词
在自然语言处理领域,统一的tokenizer是构建通用语言模型的基础。蛋白质领域面临类似问题:序列数据有丰富的文本语料,结构数据依赖3D坐标,功能注释则是多层级标签体系。三者信息互补,却通常被割裂处理。
ProTok的核心思路是利用乘积量化(product quantization),为每种模态分配独立的codebook组,再通过模态dropout(modality dropout)让模型学会在任意模态子集下进行推理。这意味着单一checkpoint无需重新训练即可支持灵活推理。这是蛋白质表示学习走向“一个模型、多种输入”的重要一步。
乘积量化(Product Quantization, PQ) 最初由 Jégou 等人在 2011 年提出,用于大规模图像检索中的向量压缩。其核心思想是将一个高维向量切分为若干低维子向量,对每个子空间分别训练一个独立的小码本(codebook),再将这些子空间的量化结果组合起来近似原始向量。相比训练一个庞大的单一码本,PQ 在同样的码本存储预算下能表达指数级更多的组合,从而显著提升离散表示的容量。ProTok 正是借助这一性质,为序列、结构和功能三种模态各自分配 codebook 组,使统一词汇表在保持紧凑的同时容纳多模态语义。
模态dropout 借鉴了多模态学习中的 missing modality 训练范式,例如在视觉-语言模型中随机屏蔽某种输入模态,迫使模型学习跨模态冗余表示。ProTok 的创新在于将这种策略与量化 tokenizer 结合:训练时随机丢弃某一模态的输入后,共享的 codebook 仍须产出有意义的离散 token,从而保证任意模态子集输入下推理的一致性。这与传统为每种输入组合单独训练模型的做法形成鲜明对比。
多码本量化与模态dropout的协同设计
ProTok采用模块化设计:每种模态(序列、结构、功能)拥有自己的codebook组,乘积量化将高维连续表示分解为多个低维子空间的组合,从而在保持离散化效率的同时提升表示容量。
模态dropout是关键训练策略。模型在训练时随机屏蔽某些模态的输入,迫使共享词汇表在不同模态组合下都能产生有意义的token。这种做法类似多模态学习中的“missing modality”训练,但ProTok将其与量化tokenizer结合,使一个模型能适配不同的下游场景——只有结构、只有序列、或组合输入。
结构分词基准上的表现
在StructTokenBench的七个基准、14项任务和28个测试划分上,ProTok在纯结构分词器中取得了平均排名1.4的成绩,在21个划分上排名第一,28个划分中有27个进入前两名。
更关键的是,这些提升没有牺牲重建质量。ProTok的token在CATH 4.2数据集上达到0.939 lDDT,说明多码本量化和多模态训练产出的token兼具可重建性和信息量。这项数据回应了一个常见质疑:更强的下游任务表现是否以牺牲重建保真度为代价——ProTok的结果表明两者可以兼得。
lDDT(local Distance Difference Test) 是蛋白质结构预测与建模领域广泛使用的无对齐评估指标,衡量预测结构与参考结构在局部原子间距离上的吻合程度。其计算方式是统计所有原子对中,距离偏差在若干阈值(通常为 0.5、1、2、4 Å)以内的比例,再取平均,取值在 0 到 1 之间,越高表示局部几何越准确。与 RMSD 依赖全局叠合不同,lDDT 对结构局部错误更敏感,也不受全局旋转平移影响。在 CATH 4.2 数据集上达到 0.939 lDDT,意味着 ProTok 的离散 token 解码回结构后仍能高度保真地还原三维几何,这是评判一个结构分词器是否“有损”的关键证据。
StructTokenBench 是面向蛋白质结构分词器的评测基准集合,整合了多个下游任务与数据划分,用于横向比较不同 tokenizer 的表征质量。它覆盖 7 个基准、14 项任务、28 个测试划分,考察维度包括结构重建、功能预测、检索等。ProTok 平均排名 1.4 且 27/28 划分进入前两名,说明其优势并非来自单一任务的偶然提升,而是在多任务体系下整体稳定领先。
零样本功能检索与生成能力
ProTok的结构token在零样本功能检索上全面领先基线结构分词器,覆盖CATH、酶学委员会(EC)和基因本体(GO)标签层级。这意味着token本身编码了可迁移的功能语义,而非仅拟合结构坐标。
词汇表还支持生成任务。一个从零训练的紧凑语言模型在ProTok token上联合生成骨架和序列,采样骨架中有52%可设计,而参数匹配的GeoBPE基线仅为21%。这一差距说明统一token stream不仅利于理解任务,也能支撑生成式蛋白质设计。
CATH、EC 与 GO 是蛋白质功能注释中三个互补的标签体系。CATH 按层级对蛋白质结构域进行分类(Class、Architecture、Topology、Homologous superfamily),反映折叠与进化关系;EC(酶学委员会编号)按催化反应类型对酶进行四位数字分类,反映生化功能;GO(基因本体)则用受控词汇描述基因产物的分子功能、生物过程和细胞组分,是多层级的有向无环图标签。零样本功能检索指模型未在对应标签上训练,直接利用学到的 token 表征去匹配功能标签——ProTok 在这三个层级上均领先基线,说明其 token 携带了可迁移的功能语义,而不仅是结构坐标的压缩。
可设计性(designability) 是生成式蛋白质设计中的常用评估标准:将生成的骨架输入独立的序列设计模型(如 ProteinMPNN),再用结构预测工具(如 ESMFold 或 AlphaFold)重新折叠预测序列,若预测结构与原骨架高度一致(通常以 scRMSD 阈值判定),则认为该骨架“可设计”。52% 对 21% 的差距表明 ProTok 的统一 token stream 不仅服务于理解任务,也能直接作为生成式设计的表示基础。
对蛋白质语言模型的启示
ProTok的价值在于示范了一条路径:结构、序列和功能可以共享同一个离散词汇表。这为蛋白质语言模型提供了新的可能性——不再需要为每种模态设计独立编码器,而是让模型在统一token流上进行推理。
当然,ProTok目前验证的规模有限,生成任务也使用了较小的语言模型。统一词汇表能否扩展到更大参数规模和更复杂的多模态蛋白质任务,仍是开放问题。但其在多个基准上的稳定表现和重建指标,已经为后续研究提供了可复现的起点。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。