普通家用电脑跑本地大模型实测:哪些值得留下?
用mini主机实测本地大模型:MoE架构让26B模型比稠密12B快三倍,Qwen3 27B在普通家用机上可实用
一位B站UP主用 Geekom A9 Max mini 主机(通过BIOS将显存调至24GB)系统测试了多个本地大语言模型的运行表现,核心发现是:MoE(专家混合)架构对家用场景具有决定性优势——稠密12B模型仅约10 Token/秒,而26B的MoE模型可达31 Token/秒,36B的Qwen3 MoE更达38 Token/秒。最终保留的两个模型是Qwen3 27B(约14 Token/秒,新一代模型)和Gemma 26B MoE(速度更快,互为补充)。测试还验证了Ollama与底层llama.cpp的性能差异几乎可忽略,以及BIOS可调显存是能否运行27B级模型的关键门槛。结论是:主流中等配置的现代家用电脑,无需发烧级硬件即可日常使用新一代20B–27B级大模型。
在动辄百GB内存、专业显卡的工作站之外,越来越多人开始好奇一个更贴近现实的问题:普通家用电脑到底能跑动哪些本地大语言模型? 这位B站UP主没有用发烧级台式机做演示,而是选了一台紧凑型 mini 主机,实测从小模型到重量级模型的运行表现,最终筛选出真正值得日常使用的组合。
为什么选一台 mini 主机做测试
UP主刻意避开了自己那台带强力显卡、超过100GB内存的台式机,转而选用 Geekom A9 Max mini 主机作为测试平台。理由很实际:他不需要第二台全尺寸台式机,紧凑机身对桌面场景更友好;这台机器的处理器与显卡搭配相对均衡,且配有专门为这套硬件设计的主动散热系统。
真正的决定性因素在于 BIOS。这台主机允许在系统内存和显存之间自定义分配比例——测试中他把显存设成了 24GB,从而能够更精细地控制自己能加载多大的模型。这是普通 mini 主机上并不常见的可玩性。
整个测试以无头模式(headless)运行,通过本地网络用 SSH 和 tmux 连接。运行框架选择了 Ollama 而非更底层的 llama.cpp。他解释得很直接:Ollama 内部用的就是 llama.cpp 库,经过近期优化后额外开销几乎可以忽略,因此在这个场景下没必要折腾更底层的方案。所有模型统一使用 Q4_K_M 量化和默认参数运行。
从小模型到大模型的逐级实测
测试思路是从小往大跑,寻找「回答质量尽可能高、响应速度仍可接受」的那个平衡点。评估的核心指标只有一个:Token 生成速度。
小模型:轻松跑满
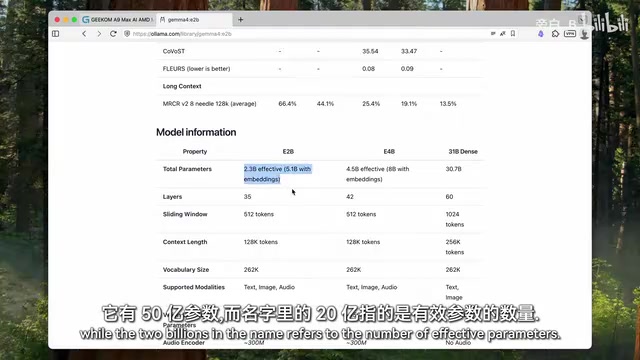
起点是 Gemma 系列最小的版本,型号名里带 E6B。UP主专门澄清了一个常见误解:这个名字里的数字指的不是总参数量,而是有效激活参数数量——每一步生成 Token 时实际参与计算的参数量,正是这种架构让模型跑得更快。实测速度超过 46 Token/秒,硬件应付这类小模型毫无压力。
中等稠密模型:速度明显回落
接着上的是 120 亿参数的 Gemma 稠密模型。「稠密」意味着生成每个 Token 都要用上全部 120 亿参数,没有偷懒空间。速度果然掉到刚过 10 Token/秒。虽然明显变慢,但 UP主认为仍在可接受范围。
运行过程中,他切到 btop(一款开源资源监控工具)观察负载:GPU 满载、CPU 未满载,说明工作正确地压在了显卡上;同时显存还剩近三分之二空闲,这为继续测试更大模型留出了空间。散热风扇此时开始更积极工作,他形容近距离听是「安静」级别,放到房间另一头基本不会注意到。
200 亿参数:MoE 架构的速度惊喜
换上 OpenAI 的 GPT-OSS 20B 后,速度反而回升到超过 21 Token/秒,接近稠密 12B 模型的两倍。对于一个 200 亿参数的模型来说,这个成绩相当亮眼,UP主直接决定保留它。
Q4_K_M 是大语言模型量化压缩方案中的一种具体规格。量化的基本思路是将模型权重从原始的 32 位或 16 位浮点数降精度存储,以换取更小的文件体积和更低的显存占用,代价是引入一定精度损失。Q4 表示使用 4 位整数存储权重;K 指「K 量化」系列,这是 llama.cpp 引入的一套分组量化方案,对不同层的权重采用不同精度分配,敏感层保留更高精度;M 代表「中等(Medium)」规格,在压缩率与质量之间取平衡。相比之下,Q4_K_S(Small)压缩更激进,Q4_K_L(Large)保留更多精度。以一个 27B 参数模型为例,原始 BF16 权重约需 54GB 显存,Q4_K_M 量化后可压缩至约 15–17GB,使其能够装入本文测试机器的 24GB 显存。这也是为何量化是在消费级硬件上运行大模型的必要前提,而非可选项。
重量级模型:MoE 架构的分水岭
真正拉开差距的是采用专家混合(MoE)架构的大模型。这类模型虽然总参数量大,但每步只激活约 30–40 亿参数,因此能在保持高质量输出的同时跑出可观速度。
Gemma 与 Qwen 的正面对比
260 亿参数的 Gemma(MoE)跑出接近 31 Token/秒,比 200 亿参数的 GPT-OSS 快了约三分之一。随后测试 360 亿参数的 Qwen3,成绩更进一步——接近 38 Token/秒,超出了 UP主的预期,他原以为两者速度会差不多。
一个有意思的细节:Qwen 的总响应时间几乎是 Gemma 的两倍,看似矛盾,实则因为 Qwen 在生成完 JSON 后额外跑了一遍自检,确认文件正确、检查元素间有无信息重复。这是生成质量意识的体现,而非速度劣势。
Qwen3 27B:新一代模型的极限试探
最后压轴的是最近发布的 270 亿参数 Qwen3。从资源占用看已接近这台机器的极限,但显存仍然够用,模型顺利跑起来,速度接近 14 Token/秒。虽然比前面的 MoE 模型慢,但考虑到它属于更强大、更先进的新一代模型,这个成绩意味着——不需要发烧级台式机,一台普通现代电脑也能跑动 Qwen3 27B。
专家混合(Mixture of Experts,MoE)架构的核心思想是将模型分成多个「专家」子网络,每次推理时由一个轻量级的门控网络(gating network)动态选择其中少数几个专家参与计算,而不是像稠密模型那样让所有参数都工作。这样一来,模型的「总参数量」可以做得很大(提升知识容量和表达能力),而「激活参数量」只占其中一小部分(降低单次计算量)。举例来说,一个 MoE 模型标称 260 亿参数,实际每步只激活 30–40 亿,推理计算量与后者相当,速度自然远超同总参数量的稠密模型。MoE 架构的主要挑战在于:所有专家的权重都必须常驻显存,因此虽然计算快,但显存占用并不会等比例减少。这也是文中 BIOS 可调显存这一特性如此关键的原因——装不进显存的模型,再快也无法运行。
最终留下哪两个模型
需要强调的是,本次测试只关注 Token 生成速度这一个维度,参数全部用默认值,目标不是压榨单个模型的极限,而是先摸清「哪一组模型在普通电脑上跑有意义」。微调将是下一步的工作。
基于此,UP主最终在这台 mini 主机上保留了两个模型:
- Qwen3 27B:今天明显的赢家。属于新一代模型,速度可以接受,经过微调后有望更快。
- Gemma 26B(MoE):来自不同模型家族,速度明显更快,可作为 Qwen 的极好补充。
他还预告后续会做一期关于「组合使用这两个模型」的内容。
给普通用户的实用启示
这次实测最有价值的结论,不在于某个具体的 Token/秒数字,而在于几个可迁移的判断:
MoE 架构是家用场景的关键。 同样参数规模下,稠密模型(12B 只有约 10 Token/秒)和 MoE 模型(26B 达 31 Token/秒)的体验差异巨大。选模型时看「激活参数」比看「总参数」更贴近实际速度。
显存可调分配拉高了上限。 能在 BIOS 里把显存设到 24GB,直接决定了这台机器能不能装下 27B 级别的模型。这是选购家用 AI 主机时容易被忽略的一项。
Ollama 已足够好。 对绝大多数用户而言,没必要为了那点几乎测不出的性能差异去折腾 llama.cpp 或 vLLM。
对于想在自己电脑上搭建本地 AI 的人来说,这份测试提供了一个清晰的现实基准:主流的中等配置机器,完全能够胜任新一代 20B–27B 级模型的日常使用。
相关推荐
Qwen Image 2.1 实测:7B 模型的图像生成能力如何?
Reddit 用户抢先体验 Qwen Image 2.1,实测生成 200+ 人物图像。本文解析这款 7B 参数图像生成模型的画质表现、噪点问题以及图像编辑与参考图能力。
Meta Muse评测:强大却令人不安的AI助手
Meta的AI助手Muse功能强大却令人不安。其Mac应用可访问信息、日历和备忘录引发隐私担忧,而它无法描述自身的局限更揭示了当前AI的深层问题。本文解析Muse评测背后的信任与边界议题。
Deodand:中世纪英格兰为致死之物定价的古老法律
Deodand 是英格兰普通法中一项为致死之物定价并没收的古老制度。本文解析其法律逻辑、从宗教赎罪到财政工具的演变,及其对当今自动驾驶与 AI 责任归属讨论的启示。