Python调用Ollama本地大模型实战:智能体开发指南

教你用OpenAI SDK零成本调用Ollama本地模型,并集成进带工具调用的Agent。
本文基于B站UP主的实战演示,讲解如何用OpenAI SDK调用Ollama本地大模型。核心结论是Ollama兼容OpenAI API,迁移只需把`base_url`指向本地11434端口并填写正确的模型名,无需改动其他调用代码。文章强调所有Ollama模型共用同一端点,模型选择完全由请求中的`model`字段决定,切换模型只需改一个字符串。演示第二部分把本地模型接入带工具调用的Agent原型,并借助大模型完成代码改动;测试中Agent能发起工具调用,但受模型规模与网络环境限制,实时任务可靠性有限。作者总结了热加载后响应尚可、首次加载偏慢等实践经验,并布置了两个动手练习。
本地大模型正在成为开发者构建AI应用的重要选项,而Ollama作为轻量级本地模型运行工具,与Python的结合尤为便捷。本文基于B站UP主的实战演示,梳理如何用OpenAI SDK调用Ollama本地模型,并将模型集成到带工具调用的智能体(Agent)中。
用OpenAI SDK连接Ollama:改动极小
UP主演示的核心思路是:Ollama兼容OpenAI API格式,因此可以直接复用OpenAI的Python SDK。与调用云端API相比,唯一需要改动的是base_url——将其指向本地Ollama服务地址(如http://localhost:11434/v1),而不是OpenAI的官方端点。
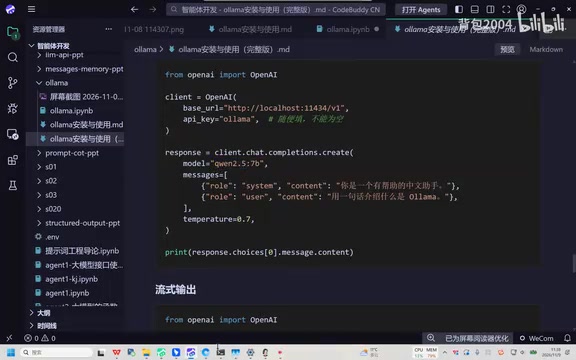
模型名称的填写也有讲究。UP主强调,代码中的模型名应与Ollama中实际拉取的模型名称一致,可通过命令行查看当前模型列表来获取准确名称。演示中使用的并非7B模型,而是“千问三猫后8B”(音译,指Qwen系列8B参数模型),并提醒注意模型名称不要写错。
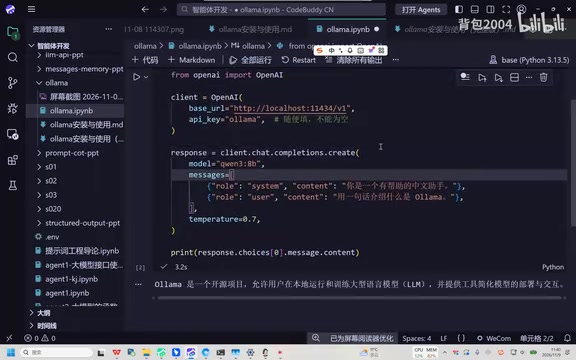
连接建立后,提问调用方式与OpenAI标准用法完全一致。UP主现场运行代码,首次因为模型被关闭需要重新加载,响应稍慢;第二次加载完成后,大约三秒即返回结果。这表明本地推理在模型热加载后的延迟表现可以接受。
Ollama 是专为本地运行大语言模型设计的轻量级工具,类似本地版的“模型包管理器”:它负责下载量化后的模型权重、管理模型生命周期,并在本机启动一个 HTTP 服务。该服务默认监听 11434 端口,除提供自有 REST API 外,还兼容 OpenAI 的 /v1/chat/completions 等接口格式,并额外支持 /api/generate 等原生端点。正因如此,任何按 OpenAI 规范编写的客户端——包括官方 Python SDK——只要把 base_url 指向 http://localhost:11434/v1,即可无缝调用本地模型,无需改动请求构造与解析逻辑。这种“协议兼容”策略大幅降低了从云端迁移到本地的成本,也是 Ollama 生态迅速扩张的关键原因之一。
关键细节:所有Ollama模型共用同一端点
UP主特别指出一个容易忽略的点:对Ollama而言,所有本地模型都使用同一个链接(即同一个base_url),链接本身不会因模型不同而变化。模型的选择完全由请求中的model字段决定。这意味着开发者无需为每个模型维护不同的连接配置,切换模型只需改一个字符串。

这一特性简化了多模型实验的流程,也解释了为什么代码中的模型名称“随便写”也能工作——只要该名称对应已拉取的模型。
在量化与本地推理语境下,“7B”“8B”指模型参数量约为 70 亿或 80 亿。参数量直接决定显存占用与单次推理速度:同一台机器上,8B 模型通常比 3B 慢,但对复杂指令的理解、工具调用格式的遵从度往往更好。Ollama 分发的模型多为 4-bit 量化的 GGUF 格式,8B 模型通常需要约 5–6 GB 显存或内存,7B 相近,3B 则只需约 2–3 GB。文章中小模型在工具调用时出现“绕道访问网站”的行为,正是模型规模有限、规划能力不足的典型表现。因此选型时需在响应速度、硬件门槛与任务复杂度之间权衡,而不是单纯追求参数更大。
把Ollama塞进Agent:让大模型帮你改代码
演示的第二部分是将本地模型集成到已有的智能体原型中。UP主此前有一个带工具调用的简单Agent原型,这次要做的就是把模型替换为Ollama本地模型。
有意思的是,UP主并没有手动逐行修改,而是直接把需求丢给大模型,让大模型帮忙完成代码改动。改动基于此前发放的一个文件,效果是Agent能够调用本地模型进行推理。运行后可以看到,Agent成功使用了“千问三发币”(音译,指Qwen 3B模型)进行响应。
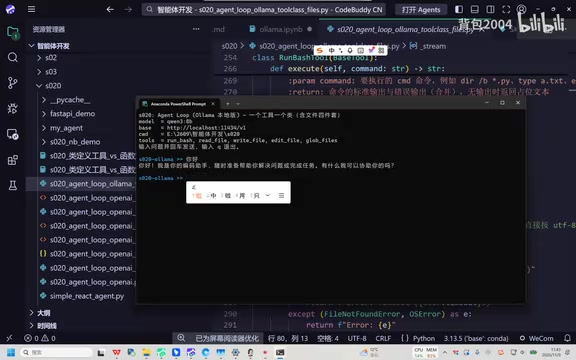
随后UP主测试了工具调用能力:让Agent查询最近新闻。由于该原型没有内置搜索引擎工具,模型转而尝试使用终端工具访问新浪等网站获取信息。演示中网络连接不畅,访问未能成功,但UP主指出,模型确实发起了工具调用行为,说明小模型也能完成少量Agent任务。
工具调用(Tool Calling / Function Calling)指模型不直接给出最终答案,而是输出一个结构化的调用请求,例如“调用 search_news,参数为 {query: '最近新闻'}”,由外部程序实际执行后再把结果回传给模型,形成多轮循环。工程上通常需要两件事:一是向模型声明可用工具的名称、描述与参数 schema,二是解析模型返回的 tool_calls 字段并路由到对应函数。不同模型对这一格式的遵循能力差异明显,小参数模型常出现参数缺失、格式错误或“假装调用”等问题。文章演示中模型改选终端工具抓取网页,说明它已理解“需要外部能力”这一层,但工具选择的合理性与执行成功率仍依赖于模型能力和可用工具的设计。
实践建议与局限
从演示可以提炼几点经验。第一,调用Ollama本地模型的门槛很低,OpenAI SDK用户几乎零成本迁移,只需改base_url和模型名。第二,模型热加载后的推理速度在演示场景中表现尚可,但首次加载有等待。第三,本地小模型在Agent工具调用上具备基础能力,但受限于模型规模和外部网络环境,复杂任务(如实时新闻抓取)的可靠性有限。
UP主布置了两个练习任务:一是在既有Agent代码中接入本地模型,二是实现课件中的调用程序。对于想动手的开发者,建议先从最简单的单轮问答跑通,再逐步加入工具调用逻辑。
相关推荐

Anker SOLIX X1三个月实测:断电无缝切换,家庭储能如何省电费
Anker SOLIX X1与PowerDock Pro安装三个月实测:断电毫秒级无缝切换,九月用电735千瓦时仅从电网购买16千瓦时,太阳能加电池覆盖约98%需求,电池放电358千瓦时,还向电网输送495千瓦时富余电力。

@ai-sdk/rsc 1.0.291 版本发布:修复补丁与依赖更新
@ai-sdk/rsc 发布 1.0.291 补丁版本,更新依赖至 ai@5.0.289。本文介绍该版本的变更内容、依赖关系与升级建议,帮助开发者了解 AI SDK 生态的版本维护节奏。

英伟达治理危机:公司治理专家为何集体围观
英伟达陷入令公司治理专家都感到罕见的危机,多位专家表示从未见过类似局面。本文分析这一治理危机为何引发专业围观,以及对AI芯片行业可能产生的影响。