Q2D-Web数据集:23000条真实搜索背后的Agent查询重构评测
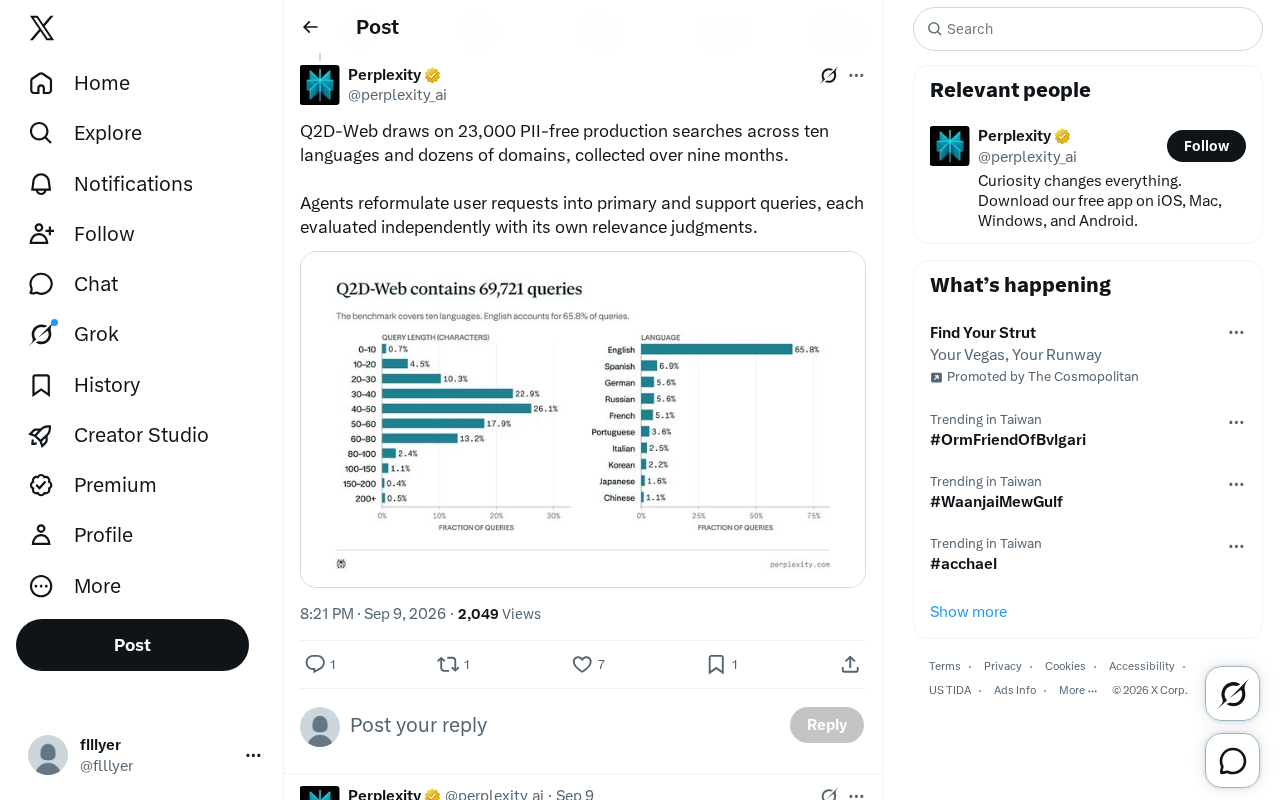
Q2D-Web用2.3万条真实生产搜索数据,为Agent查询重构能力提供多语言、细粒度的评测基准。
Q2D-Web是一个专为检索式Agent查询重构能力设计的评测数据集,包含23,000条经过隐私处理的真实生产环境搜索记录,覆盖十种语言和数十个领域,历时九个月持续采集。与依赖合成数据的现有基准不同,Q2D-Web的数据来源于真实用户行为,能够更忠实地反映生产部署场景下的复杂性。其评测逻辑聚焦于Agent将用户模糊请求重构为主查询与支持查询的能力,并对每条查询独立进行相关性评判,实现细粒度诊断。这种设计使研究者能够精准区分Agent在意图理解与信息补全策略上的不同缺陷,为RAG系统和搜索Agent的迭代改进提供更直接的指导依据。
一个被忽视的评测缺口
在检索增强生成(RAG)和智能体(Agent)系统快速演进的当下,如何客观衡量一个Agent将用户模糊请求转化为有效搜索查询的能力,一直缺乏贴近真实场景的评测基准。多数现有数据集要么规模有限,要么依赖合成数据,与生产环境的复杂性存在明显落差。
Q2D-Web 正是针对这一缺口而构建的数据集。根据公开披露的信息,它汇集了 23,000 条不含个人身份信息(PII-free)的生产环境搜索,覆盖 十种语言和数十个领域,并在长达 九个月 的周期内持续采集。这样的规模与多样性,使其区别于大多数实验室条件下拼凑的测试集。
数据集的三个关键特征
真实生产数据,而非合成样本
Q2D-Web 的核心价值在于其数据来源——它取自真实的生产环境搜索行为,而非人工编造或模型生成的查询。这意味着数据集能够反映用户在实际使用中提出请求的多样性、口语化程度以及领域跨度。对于希望评估Agent在真实部署场景下表现的团队而言,这种数据的可信度远高于合成基准。
同时,数据在采集阶段就完成了个人身份信息的剥离,这在合规性日益重要的当下是一个必要且负责任的做法,既保证了数据可用于公开研究,又规避了隐私风险。
跨语言与跨领域的广度
十种语言、数十个领域的覆盖,让 Q2D-Web 具备了检验模型泛化能力的天然优势。一个只在英文单一领域表现良好的Agent,在多语言、多主题的真实世界中往往会暴露短板。九个月的采集周期也意味着数据集能够涵盖不同时间段、不同语境下的搜索需求,减少了单一时间窗口带来的偏差。
Agent 查询重构的评测逻辑
数据集背后真正值得关注的,是它所对应的评测方法论。在 Q2D-Web 的设定中,Agent 会将用户的原始请求 重构(reformulate)为主查询(primary query)和支持查询(support queries)。
这一设计贴合了现代检索式Agent的实际工作方式:面对一个复杂或模糊的用户意图,单一查询往往不足以召回完整信息,Agent需要拆解出一个核心查询,再辅以若干补充查询来覆盖信息的不同侧面。
更关键的是评测粒度——每一条查询都被独立评估,拥有各自的相关性判断(relevance judgments)。这种做法避免了将Agent的整体输出笼统打分,而是能够精细定位问题:主查询是否准确捕捉了用户核心意图?支持查询是否有效补全了信息盲区?还是产生了冗余甚至偏离的噪声查询?
为什么独立评估很重要
将主查询与支持查询分开评判,本质上是把Agent的"查询规划"能力拆解为可量化的子任务。它让研究者能够回答更具体的问题:Agent的失败究竟源于对用户意图的误解,还是源于信息补全策略的不足。这种细粒度的诊断对于改进检索式Agent的实际迭代具有直接指导意义。
对检索式 Agent 研发的意义
Q2D-Web 的出现,为查询重构(query-to-document 或 query reformulation)这一环节提供了一个更接近真实的评估标尺。对于正在构建RAG系统、搜索Agent或多步推理检索管线的团队,这类基准的价值在于:
- 用真实、多语言的数据检验系统在生产条件下的鲁棒性;
- 通过独立的查询级相关性判断,精准定位查询生成中的薄弱环节;
- 为跨领域泛化能力提供可对比的量化依据。
需要说明的是,当前公开的信息主要来自简短的项目介绍,关于数据集的具体构建流程、标注标准、以及配套的基线模型结果等细节尚未在此素材中充分展开。有意采用该基准的研究者仍需参考其完整的原始文档与评测协议,以准确理解其适用边界。
小结
Q2D-Web 以真实生产数据、多语言多领域覆盖和查询级独立评估三个特点,填补了Agent查询重构评测中的一块空白。它反映出行业评测正在从合成、单一语言的实验环境,向更贴近真实部署的方向演进。对于严肃对待检索式Agent质量的团队而言,这类基准值得纳入评估工具箱。
相关推荐
微软紧急发布Win11补丁,修复史上最大更新引发的Bug
微软紧急推送Windows 11带外更新,修复其史上最大规模的九月补丁所引发的Bug。该更新曾一次性修复近千个漏洞,却影响了企业、开发者和游戏玩家,尤其是Hyper-V文件夹共享功能。
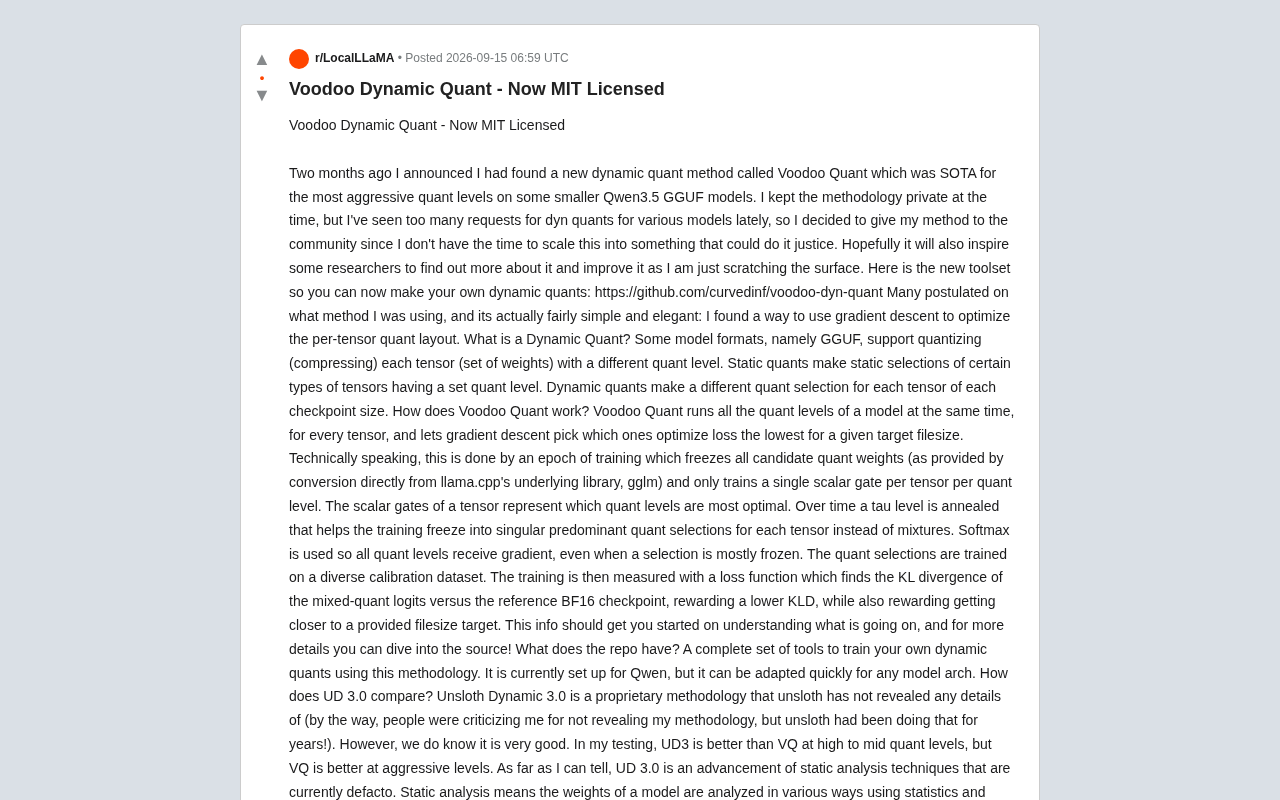
Voodoo Dynamic Quant开源:用梯度下降优化模型量化
开发者开源动态量化方法 Voodoo Dynamic Quant,采用 MIT 协议。它用梯度下降优化 GGUF 模型的逐张量量化布局,在激进低比特档位优于 Unsloth Dynamic 3.0,为低显存本地部署提供新工具。
Perplexity揭秘:支撑AI搜索的嵌入与排序模型服务架构
Perplexity公布AI搜索底层技术研究,揭示支撑嵌入与排序模型的业界领先服务基础设施,解析检索增强生成中检索与排序环节如何决定回答质量与响应速度。